원본 화면 비율을 유지
결과 영상은 올린 이미지의 형태를 따릅니다. 세로 제품 사진은 세로로, 가로로 넓은 이미지는 가로로 남습니다. 채널마다 다시 자르거나 구도 가장자리를 잃지 않아도 됩니다.
Vidu Q4 Preview는 ShengShu의 최신 AI 영상 모델입니다. 이미지 한 장, 또는 참조 이미지 최대 15장과 음성 참조 3개로 네이티브 오디오가 있는 최대 16초, 2K/4K 영상을 생성합니다.
Vidu가 2026년 10월 7일 공개 · 지금 Topview에서 사용
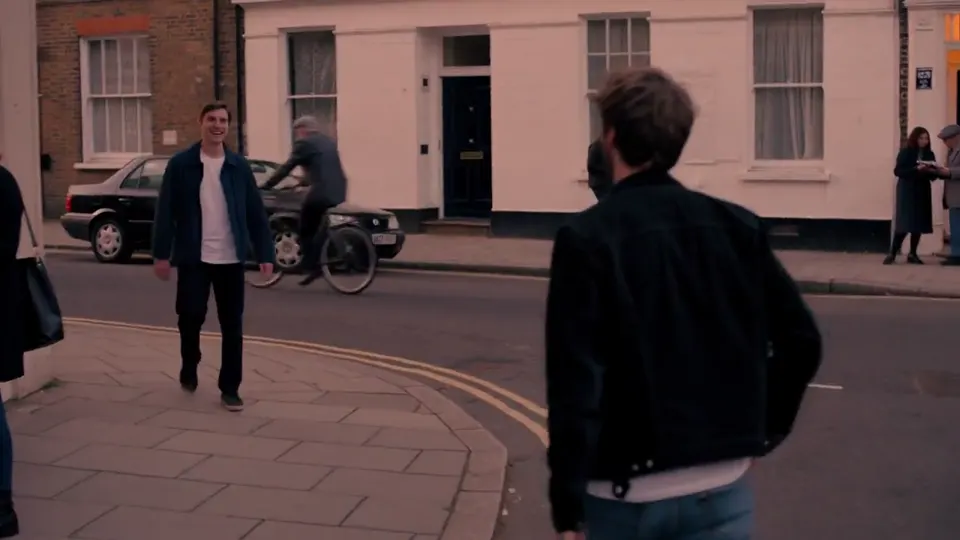
이미지 한 장으로 시작합니다. 움직임과 카메라를 적으면 Vidu Q4가 정지 화면을 3–16초, 2K 또는 4K 영상으로 늘립니다. 모습은 올린 프레임을 따르고, 다음에 무슨 일이 일어나는지는 프롬프트가 정합니다.
결과 영상은 올린 이미지의 형태를 따릅니다. 세로 제품 사진은 세로로, 가로로 넓은 이미지는 가로로 남습니다. 채널마다 다시 자르거나 구도 가장자리를 잃지 않아도 됩니다.
무술, 달리기, 싸움은 이미지로 영상을 만들 때 형태가 깨지기 쉬운 장면입니다. Vidu는 Q4가 이런 움직임을 더 매끄럽게 하고 변형, 끊김, 아티팩트를 줄인다고 합니다. 프롬프트에 동작과 방향을 적으면 모델이 따라갈 경로가 분명해집니다.
폭발, 연기, 파티클, 에너지 효과의 빛과 움직임이 더 자연스럽습니다. 게임 예고, 판타지 단편, 제품이 드러나는 장면에서는 그 한 번이 샷 전체를 맡습니다.
Vidu 이미지 투 비디오에서 흔한 불만은 영상이 요청에서 벗어나는 것입니다. Q4는 카메라 움직임과 전환을 더 가깝게 따르지만, 방향은 여전히 프롬프트에 있습니다. 샷마다 주체 하나, 주요 동작 하나, 카메라 움직임 하나가 가장 예측하기 쉽습니다.
Q4에서 가장 크게 바뀐 부분이 레퍼런스 투 비디오입니다. 시작 프레임 한 장이 아니라 얼굴, 의상, 소품, 장소, 스타일 이미지를 한 세트로 넘깁니다. 한 번의 생성에 이미지 최대 15장과 음성 참조 최대 3개가 들어가고, Vidu Q4가 그 주위로 장면을 만듭니다.
촬영 준비처럼 캐릭터, 의상, 소품을 각각 올립니다. 칸은 Q3 참조 모델의 7장에서 15장으로 늘었습니다. 두 사람 장면이면 둘의 정면과 측면, 장소, 스타일 참조까지 넣을 수 있습니다.
얼굴이나 의상이 참조끼리 다를 때는 프롬프트가 결정합니다. 태그로 각 참조를 가리키고 샷에서 무엇을 하는지 적으세요. 예: "@1이 흰 도복으로 지르고 @2가 가드를 유지한다." 태그가 분명하면 얼굴이 섞이는 일이 줄어듭니다.
음성 클립은 최대 3개, 각 3–12초입니다. 클립이 그 캐릭터의 목소리를 정합니다. 대사 자체는 프롬프트에 쓰고, 누가 말하는지 지정합니다.
Q4의 레퍼런스 투 비디오는 정지 이미지와 오디오만 받습니다. 움직임이나 편집을 위한 참조 영상은 받지 않습니다. 기존 영상의 움직임을 옮기려면 영상 참조를 지원하는 모델을 사용하세요.
Q4는 화면과 함께 소리를 생성합니다. 대사와 환경음이 같은 과정에서 나오므로, 무음 영상을 내보낸 뒤 오디오를 붙이지 않아도 됩니다.
입 모양은 목소리, 얼굴과 함께 생성됩니다. 끝난 영상에 나중에 붙이는 방식이 아닙니다. 표정과 입은 그 캐릭터가 실제로 말하는 내용에 붙어 있습니다.
이전 모델에서는 같은 캐릭터도 생성할 때마다 목소리가 달라질 수 있었습니다. 음성 참조는 고른 샘플에 목소리를 고정합니다. 시리즈 캐릭터는 회차를 넘어가도 같은 목소리를 유지합니다.
대사는 따옴표 안에 넣고 누가 말하는지 적습니다. 길이는 클립 안에 들어가야 합니다. 상한은 16초이므로, 짧게 쓰면 반응 샷을 남길 수 있습니다.
Vidu가 Q4에 둔 작업은 AI 시리즈, 광고, 소셜 콘텐츠, 영화에 가까운 제작입니다. 각각 이 AI 영상 생성기를 어떻게 쓰는지 정리했습니다.
이어지는 캐릭터에는 매번 같은 얼굴과 같은 목소리가 필요합니다. 참조 이미지와 음성 클립이 있으면 짧은 에피소드 내내 그걸 유지할 수 있습니다.
제안용으로 방향을 여러 개 시험하거나, 같은 제품 영상을 시장별로 만듭니다. 그때마다 배역을 다시 만들지 않아도 됩니다.
Reels, Shorts, TikTok용 세로 영상입니다. 대사와 소리는 처음부터 들어 있습니다.
촬영 전에 연기, 프레이밍, 호흡을 잡아 둡니다. 10-bit 컬러의 4K 출력은 나중에 색을 잡아도 버팁니다.
Vidu Q4는 Topview에서 사용할 수 있습니다. 단계는 아래와 같습니다.
원하는 영상을 프롬프트에 적으세요. 동작, 카메라, 누가 무엇을 하는지를 넣습니다.
생성을 클릭하세요. Vidu Q4가 프롬프트와 이미지로 영상을 만듭니다.
영상을 확인한 뒤, 원하는 버전을 다운로드하세요.
바뀐 점은 Vidu 자신의 API 문서를 기준으로 합니다. 대시는 그 모델에 기능이 없거나 문서에 없다는 뜻입니다.
| Vidu Q4 Preview | Vidu Q3 Pro | Vidu Q3 (참조 모델) | Vidu Q2 | |
|---|---|---|---|---|
| 생성 모드 | 이미지→영상, 레퍼런스→영상 | 텍스트→영상, 이미지→영상, 시작/끝 프레임 | 레퍼런스→영상 | 레퍼런스→영상* |
| 최대 길이 | 16s | 16s | 16s | 10s |
| 참조 이미지 | 최대 15장 | — | 최대 7장 | 최대 7장 |
| 음성 참조 | 최대 3개 | — | Q3 Mix의 음성 참조 | — |
| 최대 해상도 | 4K (10-bit 컬러) | 1080p | 1080p | 1080p |
| 네이티브 오디오 | 지원 | 지원 | 지원 | — |
| Artificial Analysis 이미지 투 비디오 순위 | #3 | #19 | — | — |
*Q2 수치는 레퍼런스→영상 모드만 해당합니다.
같은 점이 두 가지입니다. 16초 상한은 Vidu Q3과 같습니다. Q4에는 텍스트→영상이 없고, Q3 Pro에는 아직 있습니다. 그게 필요하면 Vidu Q3 페이지를 보세요.
Artificial Analysis 이미지 투 비디오 리더보드에서 Vidu Q4 Preview는 첫 공개 3위, 같은 보드의 Vidu Q3 Pro는 19위입니다 (2026년 10월 8일 기준).
Topview는 Vidu Q4를 기존 영상 작업 옆에 둡니다.
같은 참조와 스크립트를 하나의 워크스페이스에서 Vidu Q4, Vidu Q3, 다른 모델에 돌리고 맞는 클립을 남깁니다.
초안을 팀과 공유하고, 밖에 나가기 전에 버전을 정합니다.
결과를 Topview의 광고·소셜 영상 형식으로 바로 넘깁니다. 도구 사이로 파일을 옮기지 않아도 됩니다.
다른 선택과 비교 중인가요. Vidu AI 대안 가이드를 보세요.
이미지 한 장, 또는 참조 이미지 15장과 음성 3개로 시작하세요. Topview에서 최대 16초 영상을 생성할 수 있습니다.