Zostawia oryginalne proporcje
Wyjście trzyma format obrazu. Pionowy produkt zostaje pionowy, szeroki kadr zostaje szeroki. Nie trzeba przycinać pod każdą sieć ani obcinać krawędzi kompozycji.
Vidu Q4 Preview to najnowszy model wideo AI od ShengShu. Zamienia jeden obraz albo do 15 obrazów referencyjnych i 3 klipy głosu w materiał do 16 sekund, z natywnym dźwiękiem i wyjściem 2K/4K.
Wydany przez Vidu 7 paź 2026 · Już w Topview
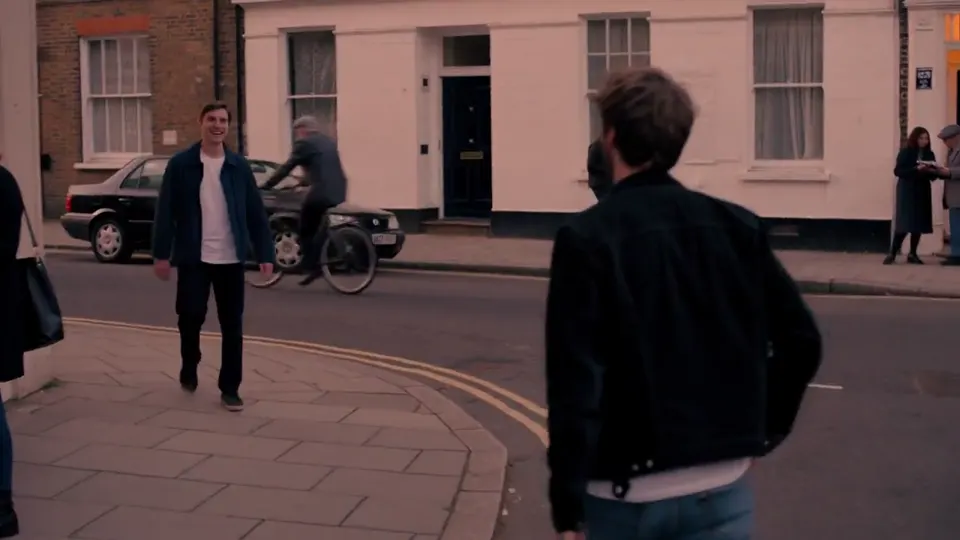
Zacznij od jednego obrazu. Opisz ruch i kamerę, a Vidu Q4 rozciągnie nieruchomą klatkę do klipu na 3–16 sekund, w 2K albo 4K. Wygląd idzie za wgranym plikiem; prompt decyduje, co dzieje się dalej.
Wyjście trzyma format obrazu. Pionowy produkt zostaje pionowy, szeroki kadr zostaje szeroki. Nie trzeba przycinać pod każdą sieć ani obcinać krawędzi kompozycji.
Walka, bieg i starcia to miejsca, w których obraz na wideo najczęściej się rozjeżdża. Vidu podaje, że Q4 robi ten ruch płynniejszym, z mniejszą liczbą zniekształceń, przycięć i artefaktów. W prompcie nazwij akcję i kierunek.
Wybuchy, dym, cząsteczki i energia wychodzą z naturalniejszym światłem i ruchem. W zwiastunie gry, krótkim fantasy albo odsłonie produktu ten efekt niesie ujęcie.
Częsta uwaga do obrazu na wideo Vidu: klip odjeżdża od prośby. Q4 ściślej trzyma ruchy kamery i przejścia, ale reżyserem zostaje prompt: jeden podmiot, jedna główna akcja i jeden ruch kamery na ujęcie.
Tu Q4 zmienia się najbardziej. Zamiast jednej klatki startowej model dostaje zestaw referencji: twarze, kostiumy, rekwizyty, miejsca i obraz stylu. Do jednego generowania wchodzi do 15 obrazów i 3 klipy głosu, a Vidu Q4 składa wokół nich scenę.
Wgraj każdą postać, kostium i rekwizyt tak, jak ekipa przygotowuje plan. Miejsc przybywa z 7 w modelach referencyjnych Q3 do 15. Scena dwuosobowa mieści przód i profil obu osób, plus miejsce i styl.
Gdy dwie referencje nie zgadzają się w twarzy albo kostiumie, decyduje prompt. Wskaż każdą etykietą i napisz, co robi, na przykład: "@1 w białym gi zadaje cios, @2 trzyma gardę." Jasne etykiety ograniczają mieszanie twarzy.
Do trzech klipów głosu, po 3–12 sekund, ustala, jak postać brzmi. Repliki idą do promptu, z informacją, kto je mówi.
Referencja na wideo w Q4 przyjmuje nieruchome obrazy i dźwięk. Nie przyjmuje wideo referencyjnego do ruchu ani montażu. Żeby skopiować już nakręcony ruch, użyj modelu, który przyjmuje wideo referencyjne.
Q4 generuje dźwięk razem z obrazem. Dialog i tło wychodzą w tym samym kroku: nie trzeba eksportować niemego klipu i doklejać dźwięku później.
Ruch ust powstaje razem z głosem i twarzą, a nie jest naklejany na gotowy klip. Mimika i usta zostają przy tym, co postać naprawdę mówi.
W starszych modelach ta sama postać mogła brzmieć inaczej przy każdym generowaniu. Referencje głosu spinają głos z wybraną próbką, żeby postać serialowa brzmiała tak samo z odcinka na odcinek.
Dialog daj w cudzysłów i wskaż, kto mówi. Każda kwestia musi zmieścić się w klipie: 16 sekund to sufit, a krótsza zostawia miejsce na reakcję.
Vidu zbudowało Q4 pod cztery rodzaje pracy: seriale AI, reklamę, media społecznościowe i produkcję filmową. Tak każdy z nich używa generatora wideo AI Vidu.
Powracające postacie potrzebują tej samej twarzy i tego samego głosu w każdym odcinku. Obrazy i klipy głosu robią to wykonalnym w krótkim sezonie.
Sprawdź kilka kierunków do prezentacji albo wersje tego samego filmu produktowego na różne rynki, bez składania obsady od nowa.
Pionowe klipy na Reels, Shorts i TikTok, z dialogiem i dźwiękiem już w środku.
Ustal grę, kadr i rytm przed zdjęciami. Wyjście 4K z kolorem 10-bit wytrzymuje korekcję barwną.
Vidu Q4 jest dostępne w Topview. Oto kroki.
Opisz w prompcie wideo, które chcesz: akcję, kamerę i kto co robi.
Kliknij Generuj. Vidu Q4 składa klip z promptu i obrazów.
Obejrzyj wideo i pobierz wersję, której potrzebujesz.
To, co się zmieniło, według dokumentacji API Vidu. Pauza oznacza, że funkcji nie ma albo nie jest wymieniona dla tego modelu.
| Vidu Q4 Preview | Vidu Q3 Pro | Vidu Q3 (modele referencyjne) | Vidu Q2 | |
|---|---|---|---|---|
| Tryby generowania | Obraz na wideo, referencja na wideo | Tekst na wideo, obraz na wideo, klatka początkowa i końcowa | Referencja na wideo | Referencja na wideo* |
| Maksymalny czas | 16s | 16s | 16s | 10s |
| Obrazy referencyjne | Do 15 | — | Do 7 | Do 7 |
| Referencje głosu | Do 3 | — | Referencja głosu w Q3 Mix | — |
| Maksymalna rozdzielczość | 4K (kolor 10-bit) | 1080p | 1080p | 1080p |
| Natywny dźwięk | Tak | Tak | Tak | — |
| Artificial Analysis, obraz na wideo | #3 | #19 | — | — |
*Liczby Q2 dotyczą tylko trybu referencja na wideo.
Dwie rzeczy zostają. Sufit 16 sekund jest taki jak w Vidu Q3, a Q4 nie ma tekstu na wideo, który Q3 Pro wciąż oferuje. Jeśli potrzebne jest jedno z nich, zobacz naszą .
W rankingu Artificial Analysis dla obrazu na wideo Vidu Q4 Preview zadebiutowało na 3. miejscu, a Vidu Q3 Pro jest 19. w tym samym rankingu (stan na 8 paź 2026).
Topview stawia Vidu Q4 obok reszty pracy nad wideo.
Puść te same referencje i ten sam scenariusz przez Vidu Q4, Vidu Q3 i inne modele w jednym obszarze roboczym i zostaw klip, który działa.
Udostępnij szkice zespołowi i zamknij wersję, zanim cokolwiek wyjdzie na zewnątrz.
Zabierz wynik prosto do formatów reklamowych i społecznościowych Topview, bez przenoszenia plików między narzędziami.
Wciąż porównujesz? Zobacz przewodnik po alternatywach dla Vidu AI.
Zacznij od jednego obrazu albo od 15 referencji i 3 klipów głosu. Wygeneruj w Topview klip do 16 sekund.