Сохраняет исходные пропорции
Выход повторяет формат изображения. Вертикальный товар остаётся вертикальным, широкий кадр — широким. Не нужно кропать под каждую сеть и не срезаются края композиции.
Vidu Q4 Preview — новейшая модель AI-видео от ShengShu. Она превращает одно изображение или до 15 референсов и 3 голосовых клипа в ролики до 16 секунд с нативным аудио и выходом 2K/4K.
Vidu выпустила 7 окт. 2026 · Уже в Topview
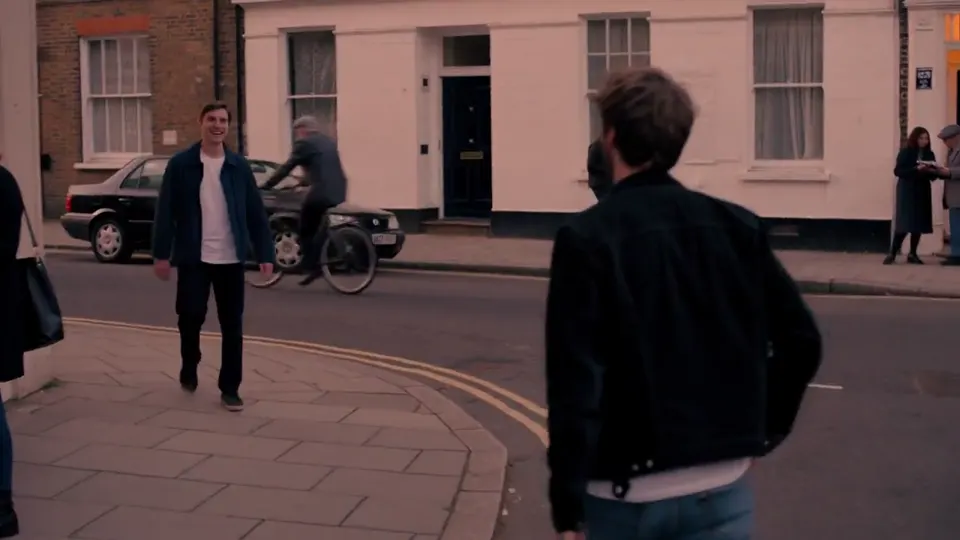
Начните с одного изображения. Опишите движение и камеру, и Vidu Q4 растянет неподвижный кадр в клип на 3–16 секунд, в 2K или 4K. Картинка держится загруженного файла, а промпт решает, что будет дальше.
Выход повторяет формат изображения. Вертикальный товар остаётся вертикальным, широкий кадр — широким. Не нужно кропать под каждую сеть и не срезаются края композиции.
Бой, бег и драка — места, где режим из изображения в видео чаще всего плывёт. Vidu пишет, что Q4 делает такое движение плавнее: меньше деформаций, рывков и артефактов. В промпте назовите действие и направление.
Взрывы, дым, частицы и энергия выходят с более естественным светом и движением. В игровом трейлере, фэнтези-шорте или раскрытии продукта именно этот эффект держит план.
Частая претензия к режиму из изображения в видео у Vidu: клип уходит от запроса. Q4 точнее следует движениям камеры и переходам, но режиссёр по-прежнему промпт: один объект, одно главное действие и одно движение камеры на план.
Здесь Q4 меняется сильнее всего. Вместо одного стартового кадра модели отдают набор референсов: лица, костюмы, предметы, локации и изображение стиля. В одну генерацию входят до 15 изображений и 3 голосовых клипа, а Vidu Q4 собирает сцену вокруг них.
Загрузите каждого персонажа, костюм и предмет так, как группа готовит площадку. Слотов стало 15 вместо 7 у референсных моделей Q3. Сцена на двоих вмещает анфас и профиль обоих, плюс локацию и стиль.
Если два референса расходятся в лице или костюме, решает промпт. Укажите каждый меткой и напишите, что он делает, например: «@1 в белом кимоно бьёт, @2 держит защиту». Ясные метки реже смешивают лица.
До трёх голосовых клипов по 3–12 секунд фиксируют, как звучит персонаж. Реплики пишутся в промпте и привязываются к тому, кто их говорит.
Режим из референса в видео в Q4 принимает неподвижные изображения и аудио. Референсное видео для движения или монтажа не принимается. Чтобы повторить уже снятое движение, нужна модель, которая принимает референсное видео.
Q4 генерирует звук вместе с картинкой. Диалог и фон выходят за один шаг: не нужно экспортировать немой клип и клеить аудио потом.
Движение губ создаётся вместе с голосом и лицом, а не накладывается на готовый клип. Мимика и рот остаются привязаны к тому, что персонаж действительно говорит.
В прошлых моделях один и тот же персонаж мог звучать по-разному при каждой генерации. Голосовые референсы фиксируют голос на выбранном образце, чтобы герой сериала звучал одинаково из серии в серию.
Диалог берите в кавычки и указывайте, кто говорит. Каждая реплика должна уместиться в клип: 16 секунд — потолок, более короткая оставляет место на реакцию.
Vidu собрала Q4 под четыре задачи: AI-сериалы, рекламу, социальные сети и кинопроизводство. Вот как каждая использует генератор AI-видео Vidu.
Возвращающимся персонажам нужны одно лицо и один голос в каждой серии. Изображения и голосовые клипы делают это возможным на коротком сезоне.
Проверьте несколько направлений для питча или версии одного продуктового ролика для разных рынков, не собирая состав заново.
Вертикальные клипы для Reels, Shorts и TikTok, диалог и звук уже внутри.
Зафиксируйте игру, кадр и ритм до съёмки. Выход 4K с цветом 10 бит выдерживает цветокоррекцию.
Vidu Q4 уже доступен в Topview. Шаги ниже.
Опишите в промпте нужное видео: действие, камеру и кто что делает.
Нажмите «Создать». Vidu Q4 собирает ролик из промпта и изображений.
Проверьте видео и скачайте нужную версию.
Что изменилось по документации API Vidu. Тире значит, что функции нет или она не указана для этой модели.
| Vidu Q4 Preview | Vidu Q3 Pro | Vidu Q3 (референсные модели) | Vidu Q2 | |
|---|---|---|---|---|
| Режимы генерации | Из изображения в видео, из референса в видео | Из текста в видео, из изображения в видео, начальный и конечный кадр | Из референса в видео | Из референса в видео* |
| Максимальная длительность | 16s | 16s | 16s | 10s |
| Референсные изображения | До 15 | — | До 7 | До 7 |
| Голосовые референсы | До 3 | — | Голосовой референс в Q3 Mix | — |
| Максимальное разрешение | 4K (цвет 10 бит) | 1080p | 1080p | 1080p |
| Нативное аудио | Да | Да | Да | — |
| Artificial Analysis, из изображения в видео | #3 | #19 | — | — |
*Цифры Q2 относятся только к режиму из референса в видео.
Две вещи не изменились. Потолок в 16 секунд тот же, что у Vidu Q3, а у Q4 нет режима из текста в видео, который у Q3 Pro ещё есть. Если нужен один из них, смотрите нашу страницу Vidu Q3.
В рейтинге Artificial Analysis для режима из изображения в видео Vidu Q4 Preview стартовал на 3-м месте, а Vidu Q3 Pro занимает 19-е в том же рейтинге (на 8 окт. 2026).
Topview ставит Vidu Q4 рядом с остальным видеопроцессом.
Прогоните одни референсы и один сценарий через Vidu Q4, Vidu Q3 и другие модели в одном рабочем пространстве и оставьте клип, который сработал.
Поделитесь черновиками с командой и зафиксируйте версию до публикации.
Заберите результат сразу в рекламные и социальные форматы Topview, не перенося файлы между инструментами.
Всё ещё сравниваете? Смотрите гид по альтернативам Vidu AI.
Начните с одного изображения или с 15 референсов и 3 голосовых клипов. Сгенерируйте в Topview ролик до 16 секунд.