คงสัดส่วนเดิม
วิดีโอออกมาตามสัดส่วนของภาพ สินค้าแนวตั้งยังเป็นแนวตั้ง ภาพกว้างยังกว้าง ไม่ต้องครอปใหม่ทุกแพลตฟอร์ม และไม่ตัดขอบองค์ประกอบทิ้ง
Vidu Q4 Preview คือโมเดลวิดีโอ AI ล่าสุดจาก ShengShu เปลี่ยนภาพเดียว หรือภาพอ้างอิงสูงสุด 15 ภาพกับคลิปเสียง 3 คลิป ให้เป็นวิดีโอยาวสูงสุด 16 วินาที พร้อมเสียงในตัว และเอาต์พุต 2K/4K
Vidu เปิดตัว 7 ต.ค. 2026 · ใช้ได้บน Topview แล้ว
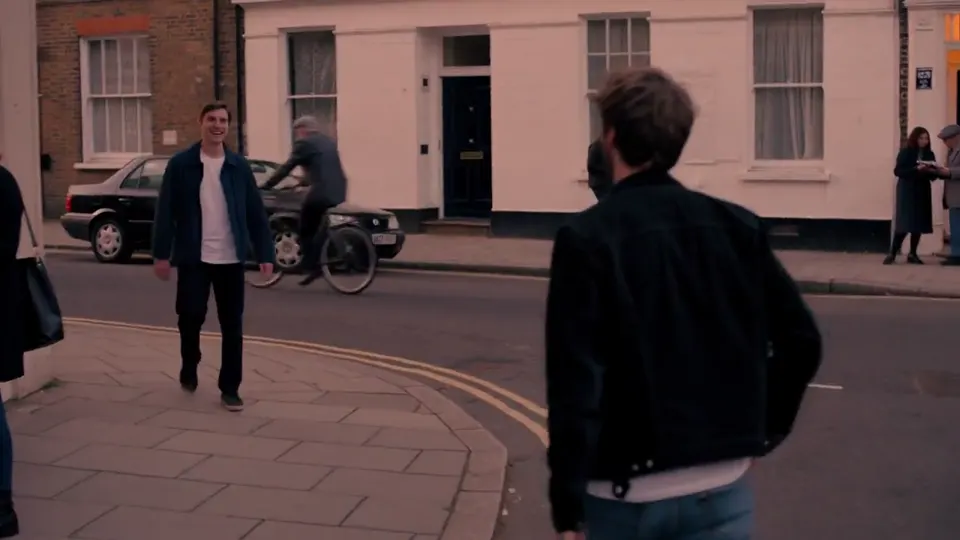
เริ่มจากภาพเดียว บอกการเคลื่อนไหวและมุมกล้อง แล้ว Vidu Q4 จะยืดเฟรมนิ่งเป็นคลิป 3–16 วินาที ที่ 2K หรือ 4K ภาพตามไฟล์ที่อัปโหลด ส่วนพรอมต์เป็นตัวกำหนดว่าจะเกิดอะไรต่อ
วิดีโอออกมาตามสัดส่วนของภาพ สินค้าแนวตั้งยังเป็นแนวตั้ง ภาพกว้างยังกว้าง ไม่ต้องครอปใหม่ทุกแพลตฟอร์ม และไม่ตัดขอบองค์ประกอบทิ้ง
ศิลปะการต่อสู้ การวิ่ง และการชก คือจุดที่รูปภาพเป็นวิดีโอเพี้ยนบ่อย Vidu บอกว่า Q4 ทำให้การเคลื่อนไหวลื่นขึ้น เพี้ยน สะดุด และอาร์ติแฟกต์น้อยลง ระบุท่าและทิศทางในพรอมต์ให้ชัด
ระเบิด ควัน อนุภาค และพลังงานออกมาพร้อมแสงและการเคลื่อนที่ที่เป็นธรรมชาติมากขึ้น ในตัวอย่างเกม หนังสั้นแฟนตาซี หรือการเปิดตัวสินค้า เอฟเฟกต์นี้คือสิ่งที่พาช็อตทั้งช็อต
คำบ่นที่พบบ่อยของรูปภาพเป็นวิดีโอ Vidu คือคลิปหลุดจากสิ่งที่สั่ง Q4 ตามการเคลื่อนกล้องและทรานซิชันได้แน่นขึ้น แต่คนกำกับการยังเป็นพรอมต์: หนึ่งตัวแบบ หนึ่งแอ็กชันหลัก และหนึ่งการเคลื่อนกล้องต่อช็อต
นี่คือจุดที่ Q4 เปลี่ยนมากที่สุด แทนที่จะส่งเฟรมเริ่มต้นภาพเดียว ให้ส่งชุดอ้างอิงทั้งใบหน้า เครื่องแต่งกาย วัตถุ สถานที่ และภาพสไตล์ ใส่ได้สูงสุด 15 ภาพกับคลิปเสียง 3 คลิปต่อการสร้างหนึ่งครั้ง แล้ว Vidu Q4 จะประกอบฉากรอบสิ่งเหล่านี้
อัปโหลดตัวละคร เครื่องแต่งกาย และวัตถุทีละชิ้น แบบทีมงานจัดเซ็ต ช่องอ้างอิงเพิ่มจาก 7 ภาพในโมเดลอ้างอิงของ Q3 เป็น 15 ภาพ ฉากสองคนใส่ได้ทั้งหน้าตรงและด้านข้างของทั้งคู่ พร้อมสถานที่และสไตล์
ถ้าภาพอ้างอิงสองภาพไม่ตรงกันที่ใบหน้าหรือเครื่องแต่งกาย พรอมต์เป็นคนตัดสิน ชี้แต่ละภาพด้วยป้าย แล้วบอกว่าทำอะไร เช่น "@1 ในชุดยูโดสีขาวชก และ @2 ตั้งการ์ด" ป้ายที่ชัดจะช่วยให้ใบหน้าไม่ปนกัน
เพิ่มคลิปเสียงได้สูงสุด 3 คลิป คลิปละ 3–12 วินาที เพื่อล็อกโทนเสียงของตัวละคร บทพูดเขียนในพรอมต์ และระบุว่าใครเป็นคนพูด
อ้างอิงเป็นวิดีโอใน Q4 รับภาพนิ่งและเสียง ไม่รับวิดีโออ้างอิงเพื่อควบคุมการเคลื่อนไหวหรือตัดต่อ ถ้าต้องการคัดลอกท่าจากฟุตเทจที่มีอยู่ ให้ใช้โมเดลที่รับวิดีโออ้างอิง
Q4 สร้างเสียงไปพร้อมกับภาพ บทสนทนาและเสียงบรรยากาศออกมาในขั้นเดียวกัน ไม่ต้องส่งออกคลิปเงียบแล้วค่อยแปะเสียงทีหลัง
ปากขยับพร้อมกับเสียงและใบหน้า ไม่ใช่การแปะทับคลิปที่ทำเสร็จแล้ว สีหน้าและปากจึงไปกับคำที่ตัวละครพูดจริง
โมเดลก่อนหน้านี้ ตัวละครคนเดิมอาจมีเสียงต่างกันทุกครั้งที่สร้าง คลิปเสียงอ้างอิงล็อกเสียงไว้กับตัวอย่างที่เลือก เพื่อให้ตัวละครซีรีส์เป็นเสียงเดิมทุกตอน
ใส่บทสนทนาในเครื่องหมายคำพูด และบอกว่าใครพูด แต่ละประโยคต้องอยู่ในความยาวของคลิป 16 วินาทีคือเพดาน และบทที่สั้นกว่าจะเหลือที่ให้ช็อตปฏิกิริยา
Vidu ออกแบบ Q4 สำหรับงานสี่แบบ: ซีรีส์ AI โฆษณา โซเชียลมีเดีย และการผลิตแนวภาพยนตร์ นี่คือวิธีที่แต่ละงานใช้ตัวสร้างวิดีโอ AI ของ Vidu
ตัวละครที่กลับมาทุกตอนต้องมีใบหน้าและเสียงเดิม ภาพอ้างอิงกับคลิปเสียงทำให้ทำต่อเนื่องได้ทั้งซีซันสั้น
ลองหลายทิศทางสำหรับพรีเซนต์ หรือทำหนังสินค้าเดียวกันหลายเวอร์ชันสำหรับตลาดต่างกัน โดยไม่ต้องสร้างนักแสดงใหม่ทุกครั้ง
คลิปแนวตั้งสำหรับ Reels, Shorts และ TikTok พร้อมบทสนทนาและเสียงอยู่ในคลิปแล้ว
จัดท่า องค์ประกอบ และจังหวะก่อนถ่ายจริง เอาต์พุต 4K สี 10 บิตรับการเกรดสีได้
Vidu Q4 ใช้ได้บน Topview แล้ว ทำตามขั้นตอนนี้
เขียนวิดีโอที่ต้องการในพรอมต์ ทั้งการเคลื่อนไหว กล้อง และใครทำอะไร
คลิกสร้าง แล้ว Vidu Q4 จะทำคลิปจากพรอมต์และรูปภาพ
ตรวจวิดีโอก่อน แล้วดาวน์โหลดเวอร์ชันที่ต้องการ
นี่คือสิ่งที่เปลี่ยนไป ตามเอกสาร API ของ Vidu ขีดหมายถึงโมเดลนั้นไม่มีฟีเจอร์นี้ หรือเอกสารไม่ได้ระบุ
| Vidu Q4 Preview | Vidu Q3 Pro | Vidu Q3 (โมเดลอ้างอิง) | Vidu Q2 | |
|---|---|---|---|---|
| โหมดการสร้าง | รูปภาพเป็นวิดีโอ, อ้างอิงเป็นวิดีโอ | ข้อความเป็นวิดีโอ, รูปภาพเป็นวิดีโอ, เฟรมต้นและเฟรมท้าย | อ้างอิงเป็นวิดีโอ | อ้างอิงเป็นวิดีโอ* |
| ความยาวสูงสุด | 16s | 16s | 16s | 10s |
| ภาพอ้างอิง | สูงสุด 15 | — | สูงสุด 7 | สูงสุด 7 |
| เสียงอ้างอิง | สูงสุด 3 | — | มีเสียงอ้างอิงใน Q3 Mix | — |
| ความละเอียดสูงสุด | 4K (สี 10 บิต) | 1080p | 1080p | 1080p |
| เสียงในตัว | มี | มี | มี | — |
| อันดับ Artificial Analysis รูปภาพเป็นวิดีโอ | #3 | #19 | — | — |
*ตัวเลขของ Q2 ใช้ได้เฉพาะโหมดอ้างอิงเป็นวิดีโอ
มีสองอย่างที่ไม่เปลี่ยน เพดาน 16 วินาทีเท่ากับ Vidu Q3 และ Q4 ไม่มีข้อความเป็นวิดีโอ ซึ่ง Q3 Pro ยังมีอยู่ ถ้าต้องการอย่างใดอย่างหนึ่ง ดูที่หน้า Vidu Q3
บนกระดานอันดับ Artificial Analysis สำหรับรูปภาพเป็นวิดีโอ Vidu Q4 Preview เปิดตัวที่อันดับ 3 และ Vidu Q3 Pro อยู่อันดับ 19 บนกระดานเดียวกัน (ณ 8 ต.ค. 2026)
Topview วาง Vidu Q4 ไว้ข้างขั้นตอนวิดีโอที่เหลือ
ส่งภาพอ้างอิงและสคริปต์ชุดเดียวกันเข้า Vidu Q4, Vidu Q3 และโมเดลอื่นในพื้นที่ทำงานเดียว แล้วเก็บคลิปที่เข้าท่าที่สุด
แชร์ฉบับร่างกับทีม แล้วล็อกเวอร์ชันก่อนเผยแพร่
นำผลลัพธ์เข้าฟอร์แมตโฆษณาและโซเชียลของ Topview ได้เลย โดยไม่ต้องย้ายไฟล์ข้ามเครื่องมือ
ยังเทียบตัวเลือกอยู่? ดูคู่มือทางเลือกแทน Vidu AI
เริ่มจากภาพเดียว หรือภาพอ้างอิงสูงสุด 15 ภาพกับคลิปเสียง 3 คลิป แล้วสร้างคลิปยาวสูงสุด 16 วินาทีบน Topview