元画像の比率を保つ
出力はアップロードした画像の形に従います。縦の商品写真は縦のまま、横長の絵は横長のままです。媒体ごとに切り直したり、構図の端を失ったりしません。
Vidu Q4 Previewは生数科技の最新AI動画モデルです。画像1枚、または参照画像最大15枚と音声リファレンス3本から、ネイティブ音声つきの最長16秒、2K/4Kの動画を生成します。
Vidu が 2026年10月7日に公開 · Topview で利用できます
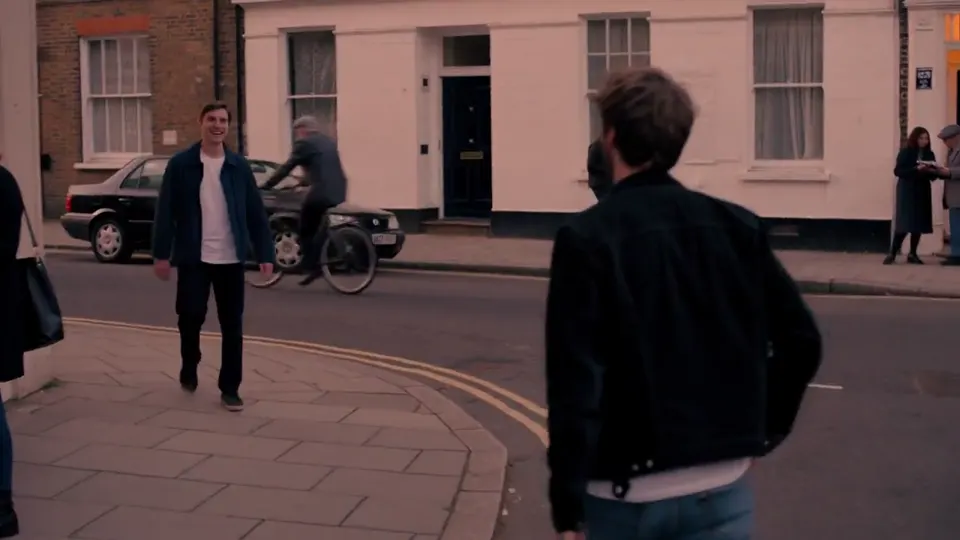
画像1枚から始めます。動きとカメラを書くと、Vidu Q4がその静止画を3〜16秒、2Kまたは4Kの動画に広げます。見た目はアップロードしたフレームのまま、次に何が起きるかをプロンプトが決めます。
出力はアップロードした画像の形に従います。縦の商品写真は縦のまま、横長の絵は横長のままです。媒体ごとに切り直したり、構図の端を失ったりしません。
格闘、走る、殴り合う場面は、画像から動画で形が崩れやすいところです。Viduによると、Q4はこの種の動きをより滑らかにし、変形、カクつき、アーティファクトを減らします。プロンプトに動作とその向きを書くと、モデルの道筋がはっきりします。
爆発、煙、パーティクル、エネルギー表現の光と動きがより自然になります。ゲームの予告、ファンタジー短編、商品の登場シーンでは、その一発がショット全体を支えます。
Viduの画像から動画でありがちな不満は、映像が依頼からずれることです。Q4はカメラワークと転換により沿いますが、舵はプロンプトです。1ショットに主体1つ、主な動作1つ、カメラワーク1つが一番読みやすい結果になります。
Q4でいちばん変わったのが参照から動画です。開始フレーム1枚ではなく、顔、衣装、小道具、場所、スタイル用の画像をまとめて渡します。1回の生成に画像最大15枚と音声リファレンス最大3本が入り、Vidu Q4はその周りにシーンを組み立てます。
撮影前の準備のように、キャラ、衣装、小道具をそれぞれ上げます。枠はQ3の参照モデルの7枚から15枚になりました。2人のシーンなら、両者の正面と横顔、場所、スタイル参照まで入ります。
顔や衣装が参照同士で食い違うときは、プロンプトが決めます。タグで各参照を指し、ショットの中で何をするか書きます。例:「@1が白い道着で突きを出し、@2が構えて受ける」。タグがはっきりしているほど、顔の取り違えは減ります。
音声クリップは最大3本、各3〜12秒です。声のサンプルが、そのキャラの聞こえ方を決めます。セリフ自体はプロンプトに書き、誰の台詞かを割り当てます。
Q4の参照から動画が受け付けるのは静止画と音声です。動きの参照や編集用の動画は受け付けません。既存映像の動きを写したいときは、動画参照に対応したモデルを使ってください。
Q4は絵と一緒に音を生成します。セリフと環境音が同じパスで出るので、無音の映像を書き出してから音を足す必要はありません。
口の動きは、声と顔と同時に生成されます。完成した映像へ後から貼るのではありません。表情と口の形は、そのキャラが実際に言っていることに結びついたままです。
以前のモデルでは、同じキャラでも生成のたびに声が変わることがありました。音声リファレンスは、選んだサンプルに声を固定します。連続もののキャラは、話数をまたいでも同じ声です。
台詞は引用符に入れ、誰のセリフかを書きます。長さはクリップに収まるように。上限は16秒なので、短めにして反応のショットを残すと扱いやすいです。
ViduがQ4に想定しているのは、AIシリーズ、広告、SNS、映画寄りの制作です。それぞれ、このAI動画ジェネレーターをどう使うかをまとめます。
続くキャラには、毎回同じ顔と同じ声が要ります。参照画像と音声クリップがあれば、短いエピソードを通してそれを保てます。
提案用に方向をいくつか試す、同じ商品映像を市場別に作る。そのたびに配役を作り直す必要はありません。
Reels、Shorts、TikTok向けの縦動画です。セリフと音は最初から入っています。
撮影前に演技、フレーミング、間を組めます。10-bitカラーの4K出力は、あとから色を調整しても持ちます。
Vidu Q4 は Topview で利用できます。手順は次のとおりです。
作りたい動画をプロンプトに書きます。動作、カメラ、誰が何をするかを入れてください。
生成をクリックします。Vidu Q4 がプロンプトと画像から動画を作ります。
動画を確認して、必要なバージョンをダウンロードします。
変わった点は、Vidu自身のAPIドキュメントに沿っています。ダッシュは、そのモデルに機能がないか、記載がないことを示します。
| Vidu Q4 Preview | Vidu Q3 Pro | Vidu Q3(参照モデル) | Vidu Q2 | |
|---|---|---|---|---|
| 生成モード | 画像から動画、参照から動画 | テキストから動画、画像から動画、開始/終了フレーム | 参照から動画 | 参照から動画* |
| 最大の長さ | 16s | 16s | 16s | 10s |
| 参照画像 | 最大15枚 | — | 最大7枚 | 最大7枚 |
| 音声リファレンス | 最大3本 | — | Q3 Mixに音声リファレンス | — |
| 最大解像度 | 4K(10-bitカラー) | 1080p | 1080p | 1080p |
| ネイティブ音声 | ○ | ○ | ○ | — |
| Artificial Analysisの画像から動画順位 | #3 | #19 | — | — |
*Q2の数値は、参照から動画モードだけのものです。
変わらない点が二つあります。16秒の上限はVidu Q3と同じです。Q4にテキストから動画はなく、Q3 Proには残っています。そちらが必要なら、Vidu Q3のページを見てください。
Artificial Analysisの画像から動画リーダーボードで、Vidu Q4 Previewは初登場3位、同じボードのVidu Q3 Proは19位です(2026年10月8日時点)。
Topview は Vidu Q4 を、いつもの動画の流れのそばに置きます。
同じ参照と脚本を、ひとつのワークスペースでVidu Q4、Vidu Q3、他のモデルに通し、合うクリップを残します。
下書きをチームと共有し、外に出す前に版を決めます。
結果をTopviewの広告用、SNS用の動画形式へそのまま渡せます。ツールの間でファイルを移す必要はありません。
ほかと比べていますか。Vidu AIの代替ガイドを見てください。