Seedance 2.5
Clips bis zu 30 Sekunden, bis zu 50 kombinierte Referenzen im genannten Topview-Workflow und detaillierte Regie für Einstellung und Audio.
Welches AI-Videomodell sollten Sie wählen?
Sowohl Seedance 2.5 als auch Wan 3.0 unterstützen AI-Video-Workflows bis zu 30 Sekunden, mit Ausgabeoptionen, die in unterstützten Topview-Workflows 1080p erreichen.
Die praktische Wahl hängt von Ihrem Briefing ab: Seedance 2.5 lässt sich für referenzlastige Produktionen und detaillierte Zeitvorgaben erwägen; Wan 3.0 lässt sich erwägen, wenn die Generierungskosten pro Sekunde Vorrang haben.
Vergleichen Sie die unterstützten Einstellungen, die vorhandenen Videos im direkten Vergleich und die modellspezifischen Abwägungen, bevor Sie generieren.
Seedance 2.5
Clips bis zu 30 Sekunden, bis zu 50 kombinierte Referenzen im genannten Topview-Workflow und detaillierte Regie für Einstellung und Audio.
Wan 3.0
Clips bis zu 30 Sekunden, bis zu 20 kombinierte Referenzen im genannten Topview-Vergleich und niedrigere veröffentlichte Referenzpreise pro Sekunde für ausgewählte Generierungsmodi.
Limits und Preise hängen von Modus, Konto und den gewählten Generierungseinstellungen ab. Prüfen Sie vor dem Absenden immer den Live-Generator.
Beide Modelle verbinden Videogenerierung und multimodale Regie. Die Tabelle trennt die Dokumentation auf Modellebene von den Einstellungen, die für den Topview-Workflow aufgeführt sind.
| Dimension | Seedance 2.5 | Wan 3.0 |
|---|---|---|
| Entwickler | ByteDance | Alibaba |
| Hauptanwendung | Längere, referenzlastige kreative Briefings | Multimodale Erstellung mit Blick auf die Generierungskosten |
| Dauer | 4s–30s, sekundengenau wählbar | 2s–30s, sekundengenau wählbar |
| Auflösung | 480p / 720p / 1080p | 480p / 720p / 1080p |
| Seitenverhältnisse | 16:9, 9:16, 3:4, 1:1, 4:3, 21:9 (zusätzlich adaptiv) | 16:9, 9:16, 1:1, 4:3, 3:4 |
| Text zu Video | Unterstützt | Unterstützt |
| Bild zu Video | Unterstützt | Unterstützt |
| Video- und Audio-Führung | In kompatiblen Workflows unterstützt | In kompatiblen Workflows unterstützt |
| Bildreferenzen | Bis zu 30 | Bis zu 10 |
| Videoreferenzen | Bis zu 10 | Bis zu 5 |
| Audioreferenzen | Bis zu 10 | Bis zu 5 |
| Kombinierte Referenzen | Bis zu 50 | Bis zu 20 |
| Audiogenerierung | In unterstützten Workflows verfügbar | In unterstützten Workflows verfügbar |
| Timing und Szenenregie | Zeitcodierte Anweisungen und sekundengenaue Dauerwahl | Einstellungs- und Szenenhinweise, abhängig vom Workflow |
| Preis | Credits variieren nach Auflösung, Dauer, Modus und Tarif Z. B. 1.5 Credits/s bei 720p | Credits variieren nach Auflösung, Dauer, Modus und Tarif Z. B. 0.5 Credits/s bei 720p |
| Geeignet für | Referenzlastiges Erzählen und detaillierte kreative Regie | Kostenbewusste Generierung und fokussierte Briefings |
Die Referenzlimits geben die Einstellungen wieder, die im Vergleich von Topview derzeit aufgeführt sind, und sind keine Garantie für jeden Anbieter oder jedes Konto. Prüfen Sie im Generator die verfügbaren Einstellungen. Die Tarifpreise stehen auf der Preisseite von Topview.
Beginnen Sie mit der Art von Video, die Sie brauchen, nicht mit dem Modellnamen. Diese Empfehlungen betreffen die Passung zum Workflow und behaupten nicht, dass ein Modell immer besser aussehende Videos erzeugt.
Seedance 2.5 und Wan 3 unterstützen beide die AI-Videogenerierung bis zu 30 Sekunden, bieten aber unterschiedliche Vorteile. Wählen Sie Seedance 2.5 für referenzlastige Projekte, präzises Timing und detaillierte Audioregie. Ziehen Sie Wan 3 für kostenbewusste Produktion, längeres Erzählen in einer Einstellung und referenzgeführte Szenenerstellung in Betracht.
Führen Sie komplexe Briefings mit bis zu 50 Referenzdateien zusammen: 30 Bilder, 10 Videos und 10 Audiodateien. Steuern Sie Figuridentität, Produktdetails, Bewegung, Umgebungen und Ton in einem Generierungs-Workflow. Wan 3 unterstützt nur 20 Referenzen.
Nutzen Sie Referenzvideos und Audiodateien von bis zu 30.2 Sekunden je Datei, vorbehaltlich der kombinierten Dauerlimits des Workflows. Steuern Sie Bewegung, Tempo und Ton mit längeren Bewegungsaufnahmen oder Musikreferenzen.
Wählen Sie eine Videodauer von 4 bis 30 Sekunden in Schritten von einer Sekunde. Nutzen Sie zeitcodierte Anweisungen, um Einstellungen, Aktionen, Übergänge und das Szenentempo innerhalb eines durchgehenden Videos zu planen.
Regieren Sie Dialog, Hintergrundmusik und Soundeffekte mit zeitcodierten Anweisungen. Koordinieren Sie Sprache, Aktion und Atmosphäre mit nativer Audiogenerierung in einem einzigen Workflow.
Wan 3.0 führt 0.30 Credits/s bei 480p, 0.50 bei 720p und 1.00 bei 1080p auf, gegenüber 0.70, 1.50 und 3.70 Credits/s für Seedance 2.5 in den veröffentlichten Referenzpreisen von Topview. Prüfen Sie das tatsächliche Credit-Angebot vor dem Generieren, denn die Tarife hängen vom gewählten Workflow und Tarif ab.
Generieren Sie eine durchgehende Videosequenz bis zu 30 Sekunden, ohne mehrere kurze Clips aneinanderzusetzen. Das eignet sich für Produktenthüllungen, ununterbrochene Kamerabewegungen und Markengeschichten, die von einer einzigen fließenden Einstellung profitieren.
Nutzen Sie Omni Reference, um Figuridentität, Requisiten und Umgebungen über eine längere Erzählung hinweg zu führen. Halten Sie die kreative Welt an visuellen Referenzen fest, während Sie Szenen und Aktionen entwickeln.
Nutzen Sie die referenzgestützte Suche im Internet, um die Videoproduktion mit zusätzlichem visuellem und kontextuellem Material zu stützen, sofern diese Funktion in Ihrem Topview-Workflow verfügbar ist.
Dasselbe Briefing. Zwei AI-Videomodelle. Neun Praxisszenarien.
Wie schneiden Seedance 2.5 und Wan 3 ab, wenn sie dieselben kreativen Anweisungen erhalten? Sehen Sie sich neun Videotests im direkten Vergleich an: filmische VFX, komplexe Action, multimodale Referenzen, dokumentarisches Erzählen, Stilwechsel, Dialog, Figureninteraktion, Tanzsynchronität und Literaturadaption.
Jeder Vergleich zeigt die Ausgaben beider Modelle neben dem ursprünglichen Prompt und, wo vorhanden, den Referenzdateien. Sehen Sie, wie jedes Modell dieselbe kreative Aufgabe löst, prüfen Sie die Details, auf die es ankommt, und finden Sie, welches Modell zu welcher Projektart besser passt.
Text zu Video · 30s · 16:9
Ein nordischer Gott schwebt über einem geborstenen Obsidian-Schrein, während goldene Blitze, schwebende Trümmer und leuchtende Runen auf einen explosiven Höhepunkt zusteuern. Die Kamera führt eine durchgehende 360-Grad-Umrundung aus, während die Figur einen gewaltigen Kriegshammer beschwört und eine starke Druckwelle auslöst.
Dieser Test verlangt von beiden Modellen, komplexe visuelle Effekte, Figurenbewegung, dynamische Kameraführung und eine durchgehende Actionfolge in einem einzigen 30-Sekunden-Video zu verbinden.
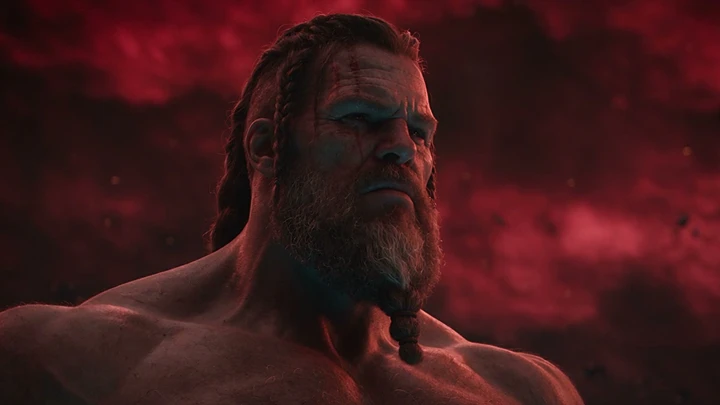
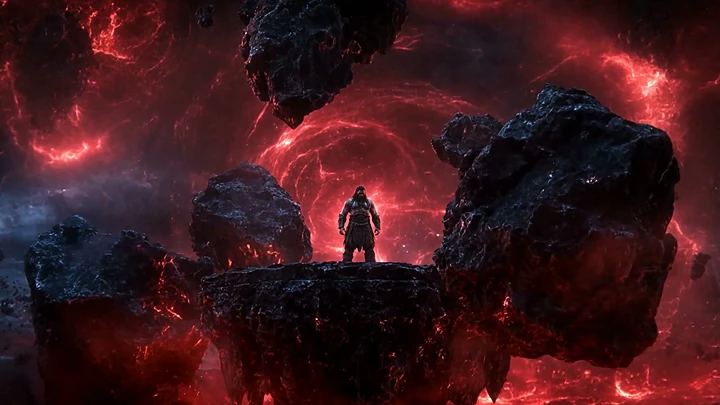
Filmische VFX-Generierung verlangt mehr als eindrucksvolle Einzelbilder. Das Modell muss Kamerabewegung, Figurenaktionen und visuelle Effekte koordinieren und eine zusammenhängende Folge halten. Dieser Test zeigt, wie jedes Modell visuell komplexe Szenen mit mehreren voneinander abhängigen Aktionen behandelt.
Seedance 2.5 hält dieses Briefing besser zusammen. Über den Clip hinweg bleibt ein bärtiger Gott auf einem geborstenen Gipfel: eine ernste Nahaufnahme, dasselbe Gesicht mit leuchtenden Augen, Blitze, die sich am Schrein aufbauen, dann die Figur in der Luft mit einem Hammer. Wan 3.0 setzt stärkere Einzeleffekte — ein rotes Portal, einen Trümmersturm, eine goldene Explosion und einen blauen Runenkreis —, aber der Gott fehlt in der Mitte des Clips, und der Hammer erscheint als Pose nach der Explosion, nicht als Fusion, der man folgen kann. Die Stichproben zeigen für keines der beiden Modelle eine abgeschlossene 360-Grad-Umrundung. Wählen Sie Seedance 2.5, wenn eine Figur und ein Ort bis zum Hammer eskalieren müssen. Wählen Sie Wan 3.0, wenn eine spektakuläre Effektaufnahme wichtiger ist als dasselbe Gesicht und derselbe Schrein.
Mehrfachreferenz · 2 Bilder · 30s · 16:9
Eine kleine Heldin, TOPVIEW BOT, kämpft gegen einen riesigen Spielzeug-Mecha namens TITAN in einer bunten Spielzeugstadt. Zwei Referenzbilder legen das genaue Aussehen beider Figuren fest, und der Prompt bestimmt den Größenunterschied, die Waffenrichtungen, die Angriffsfolgen und die durchgehende Bewegung.
Der 30-Sekunden-Kampf umfasst Raketenangriffe, Ausweichmanöver, Luftkampf, das Erklettern der Mecha-Rüstung und einen abschließenden Energieangriff.
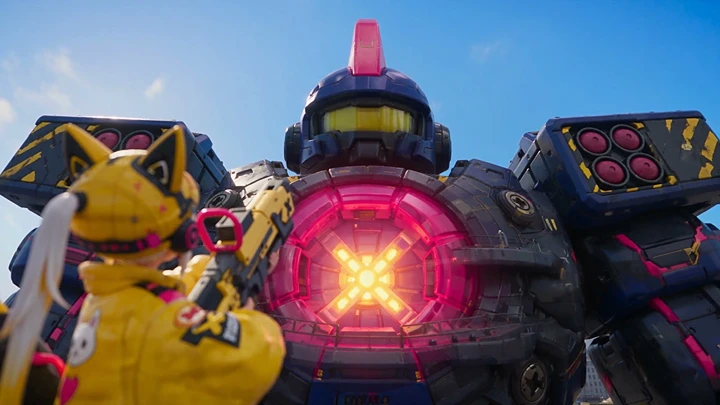
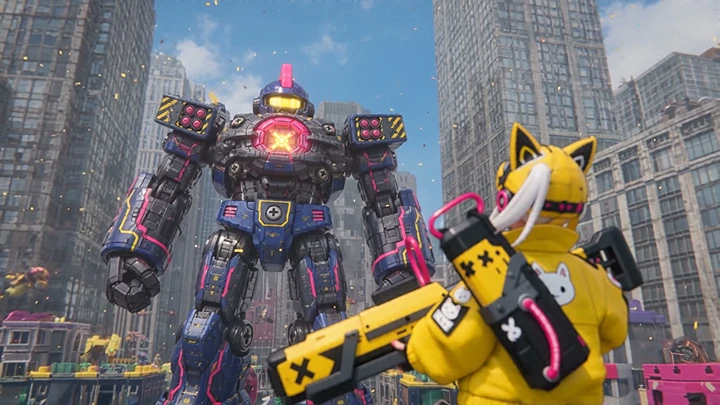
Komplexe Actionszenen fordern die AI-Videogenerierung stark. Das Modell muss Figuren konsistent halten, relative Größe verstehen, räumliche Beziehungen bewahren und mehrere Aktionen über die Zeit koordinieren. Dieser Test prüft, ob visuell ambitionierte Kampfsequenzen logisch nachvollziehbar bleiben.
Wan 3.0 trifft die Referenzblätter in diesem Kampf besser. Die Eröffnung hält die weißen Zöpfe, die Katzenohren-Kappe, die gelbe Jacke und die Kanone gegen den marineblauen Mecha, den rosa Kamm, das gelbe Visier und den rosa Brustkern lesbar, und ein späteres Frame zeigt Raketen in der Luft, bevor sie wieder auf der Rüstung ist. Seedance 2.5 gewinnt die Größenlesung in der Faust-Einstellung, in der sie winzig gegen die Hand ist, fällt dann aber auf Straßenniveau, und Gesicht und Waffe sind schwer zu prüfen, sobald die Kamera aufzieht. Seedance endet mit einer rosa Explosion, bei der die Schützin angeschnitten ist; Wan endet mit ihr klein gegen das Visier. Wählen Sie Wan 3.0, wenn die Figurenblätter und der Raketenschlag erkennbar bleiben müssen. Wählen Sie Seedance 2.5, wenn der Kontrast zwischen riesig und winzig wichtiger ist als eine saubere Referenzübereinstimmung.
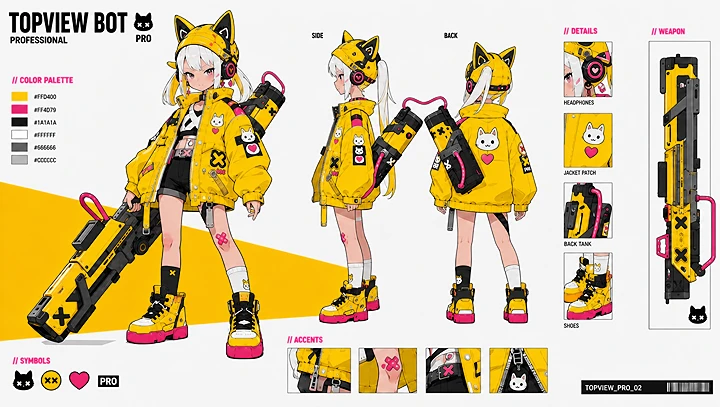
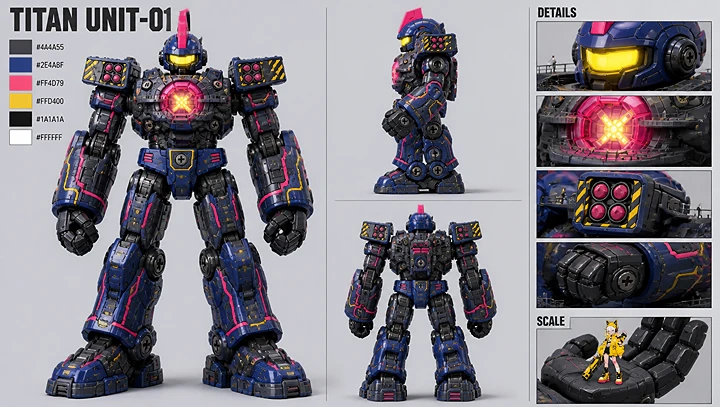
Mehrfachreferenz · 3 Bilder · 30s · 16:9
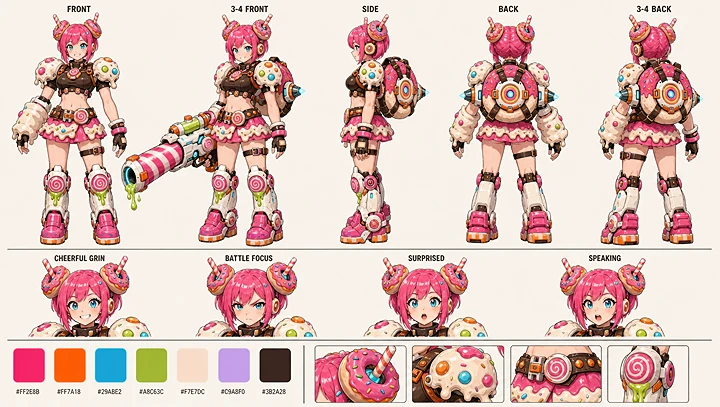
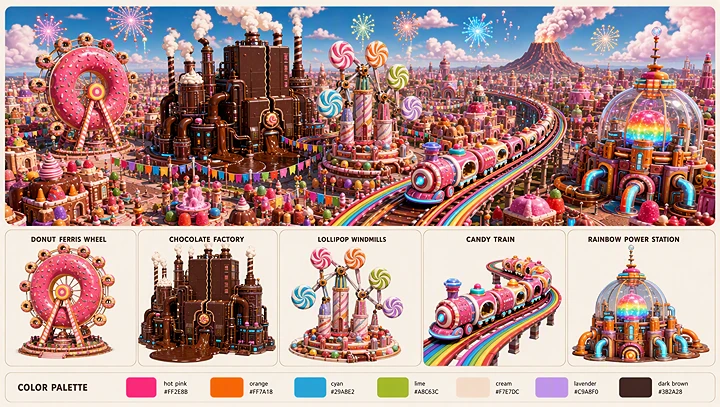
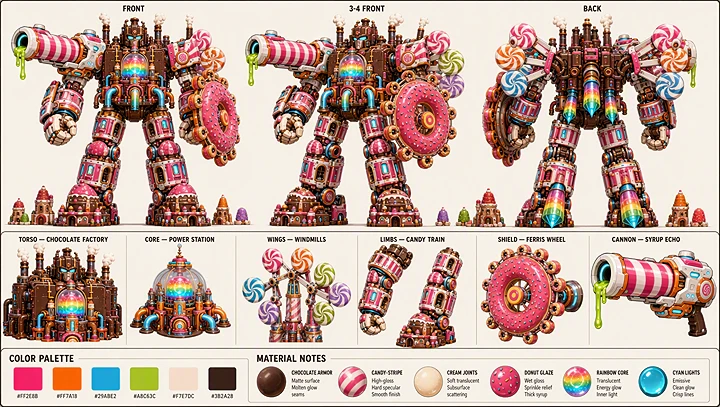
Ein buntes Candy Kingdom steht vor einer eskalierenden Bedrohung, und die Heldin SUGAR POP muss die Stadt verteidigen, bevor sich ihre Wahrzeichen zu einem riesigen Candy Super Mecha verbinden.
Drei Referenzblätter legen das Aussehen der Heldin, die Umgebung von Candy Kingdom samt Wahrzeichen und den fertig zusammengesetzten Mecha fest. Der Prompt verlangt, dass beide Modelle diese Designs bewahren und eine vollständige 30-Sekunden-Actiongeschichte generieren.
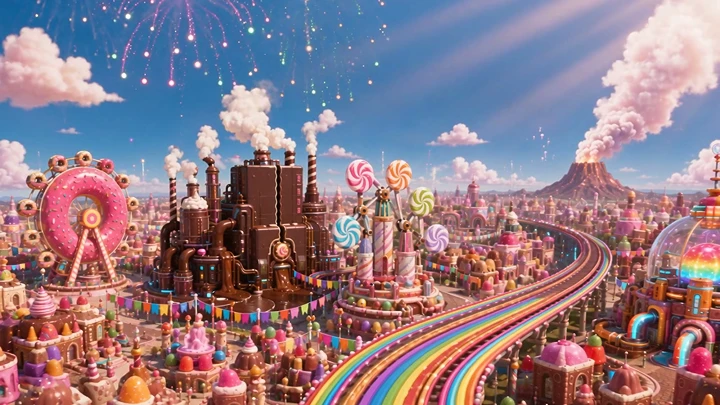
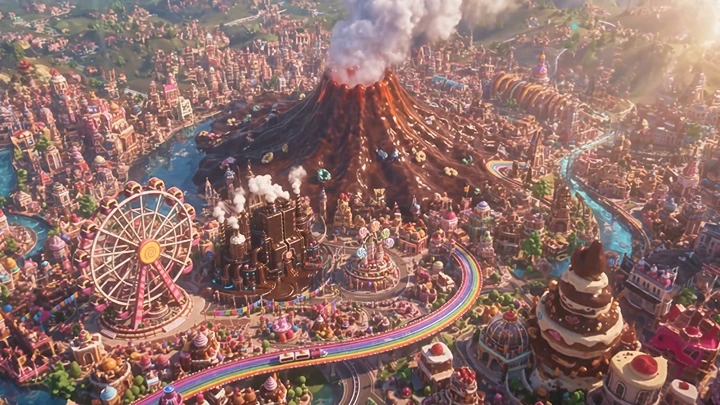
Generierung mit mehreren Referenzen verlangt, dass das Modell versteht, wie getrennte visuelle Eingaben zusammenhängen. Es muss nicht nur einzelne Objekte wiedergeben, sondern Identität bewahren, Designelemente verbinden und eine konsistente kreative Welt über wechselnde Szenen halten.
Dieser Test hilft einzuschätzen, wie zuverlässig jedes Modell mehrere Referenzbilder in ein längeres, strukturiertes Video überträgt.
Seedance 2.5 ist das stärkere Mehrfachreferenz-Ergebnis. Die Nahaufnahme hält Sugar Pops rosa Bob, die blauen Augen und die Bonbon-Haarstücke; die Mitte des Clips startet getrennte Bonbon-Wahrzeichen; und der Roboter in der Totale entspricht dem Mecha-Blatt, mit gestreifter Schulterkanone, Donut-Unterarmschild und Bonbongliedmaßen in einem Körper. Das Ende ist ein farbiger Strahl, und dieser Roboter bleibt im Bild. Wan 3.0 eröffnet mit dem klareren Candy Kingdom — Riesenrad, Vulkan und Bonbonstraßen — und ist der Clip, der das Dessertmonster über der Stadt zeigt. Die späteren Frames bleiben bei einem Bonbonzug und einem unscharfen Robotergesicht, sodass der zusammengesetzte Mecha nie so einrastet, wie es das Designblatt vorgibt. Wählen Sie Seedance 2.5, wenn Figur, Kombination und fertiger Mecha in einem Video erhalten bleiben müssen. Wählen Sie Wan 3.0, wenn Königreich und Monster zuerst lesbar sein müssen.
Text zu Video · 30s · 16:9
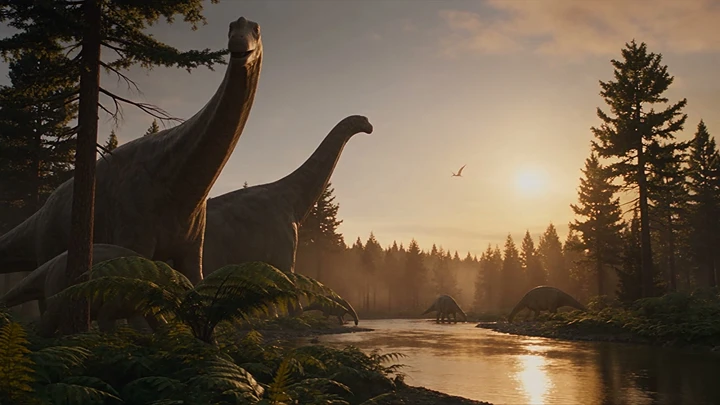
Eine naturkundliche Dokumentation zeigt die letzten Momente eines prähistorischen Ökosystems: von einem friedlichen, dinosaurierreichen Tal über einen katastrophalen Einschlag, eine Druckwelle und Vulkanausbrüche bis zu einer aschebedeckten Erde.
Der Prompt verbindet einen präzise getimten englischen Voice-over mit dokumentarischer Bildsprache, großmaßstäblichen Umweltereignissen, realistischer Tierbewegung und einem ruhigen orbitalen Ende.
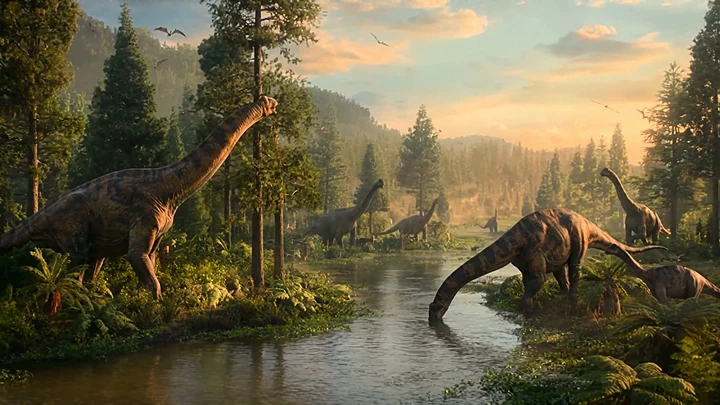
Dokumentarische Videogenerierung hängt von genauer Vermittlung ab, nicht nur von filmischen Bildern. Erzählung, Szenenzeit, visuelles Erzählen und Umweltkontinuität müssen zusammen eine vollständige Folge vermitteln.
Dieser Test prüft, wie jedes Modell gesprochene Erzählung über 30 Sekunden mit komplexen visuellen Ereignissen koordiniert.
Wan 3.0 trägt die Bildgeschichte weiter. Die Frames gehen von einem goldenen Flusstal zu einer frontalen Stampede unter einer Staubwand, einem Ausbruch, einem gefallenen Tier in der Asche und einer grauen Erde im Orbit. Seedance 2.5 geht ebenfalls vom sonnigen Tal zu einer laufenden Herde, einer Flut mit einem kleinen Stegosaurier und einem aschgrauen Sauropoden, bleibt aber noch weit im Clip im friedlichen Tal, und das letzte Stichproben-Frame ist konturloses Grau statt Orbit. Die Flut und das kleine Tier gegen die Landschaft sind bei Seedance klarer. Diese Frames bestätigen nicht den gesprochenen Wortlaut, das Tempo oder die Pausen. Wählen Sie Wan 3.0, wenn das Video den Zusammenbruch und das orbitale Ende erreichen muss. Wählen Sie Seedance 2.5, wenn Tal und Flut naturalistisch bleiben sollen, und prüfen Sie danach, ob Ihre eigene Generierung den Orbit erreicht.
Text zu Video · 30s · 16:9
Eine Tänzerin führt eine durchgehende Choreografie aus und durchquert mehrere visuelle Welten. Das Video beginnt in einer realistischen europäischen Straße und wechselt zu Cyberpunk, Schwarz-Weiß-Stummfilm, 3D-Animation und Ölmalerei.
Jede Verwandlung ändert Umgebung und Outfit, während Identität, Choreografie und musikalischer Rhythmus der Tänzerin konsistent bleiben sollen. Die Folge endet damit, dass alle vier alternativen Welten in einer Schlusskomposition zusammen erscheinen.
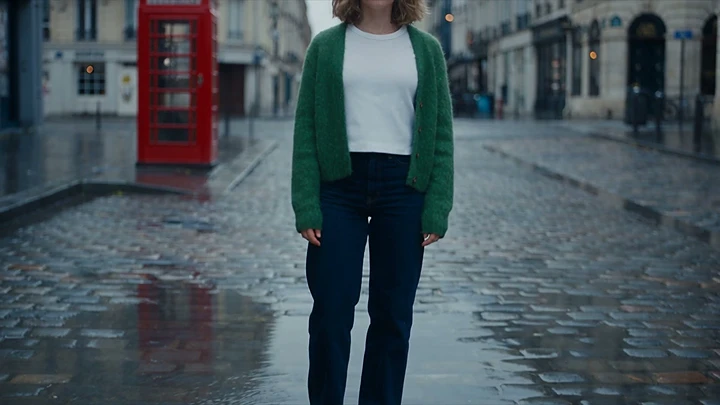
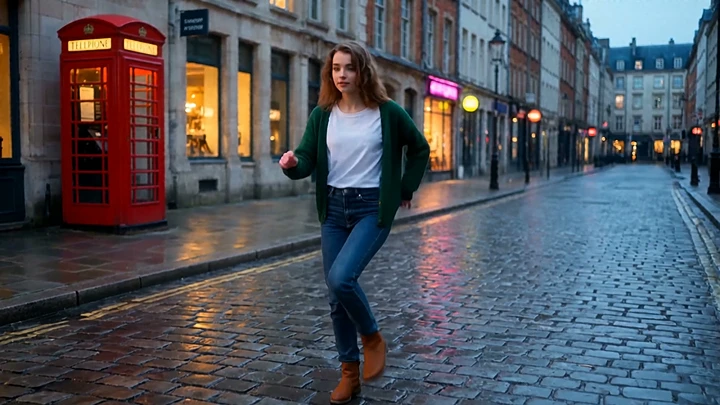
Stilwechsel verlangt, dass das Modell visuelles Aussehen von Identität und Bewegung trennt. Umgebung und künstlerische Behandlung dürfen sich stark ändern, die zugrunde liegende Figur und Aktion müssen aber verständlich bleiben.
Dieser Test untersucht, wie jedes Modell koordinierte Verwandlungen über mehrere visuelle Stile in einer durchgehenden kreativen Folge behandelt.
Seedance 2.5 deckt mehr der verlangten Welten ab. Die Stichproben zeigen die nasse europäische Straße und die grüne Strickjacke, ein neonfarbenes Cyberpunk-Outfit, ein Schwarz-Weiß-Stummfilm-Frame mit Letterbox, eine sternenübersäte Ölmal-Wendung im blauen Kleid und danach den ursprünglichen Look, umgeben von vier getrennten Feldern. Wan 3.0 tanzt in der Straßen- und Cyberpunk-Passage klarer, und der 3D-Animationsmoment im gelben Kleid ist eine volle Szene, nicht ein Bild in einem Feld. Die Stummfilmwelt erscheint in Wans Stichproben nicht, und das Ende sind vier getrennte Bilder statt eines Plakats mit der Tänzerin in der Mitte. Wählen Sie Seedance 2.5, wenn die Stilliste und das Vier-Welten-Ende der Punkt des Briefings sind. Wählen Sie Wan 3.0, wenn lesbare Choreografie und die Cartoon-Welt wichtiger sind als das Stummfilmsegment.
Mehrfachreferenz · 3 Bilder · 15s · 16:9
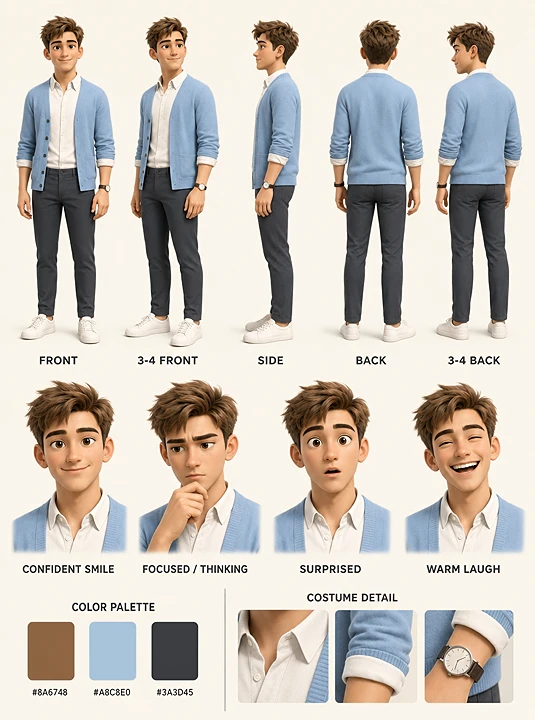
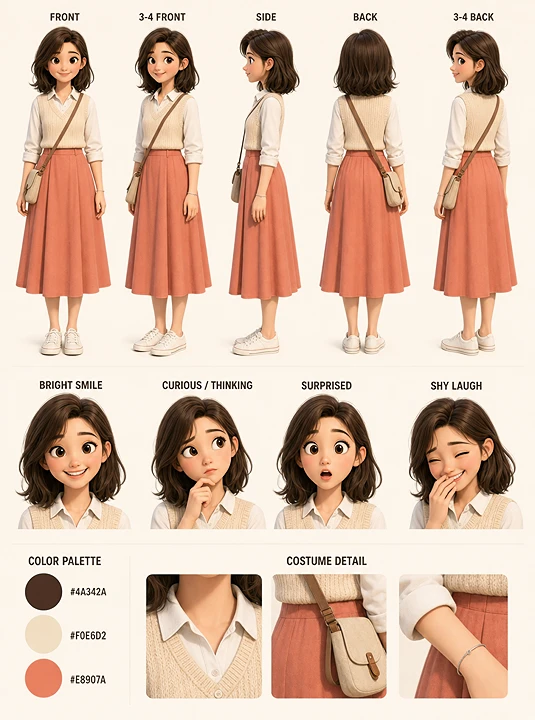
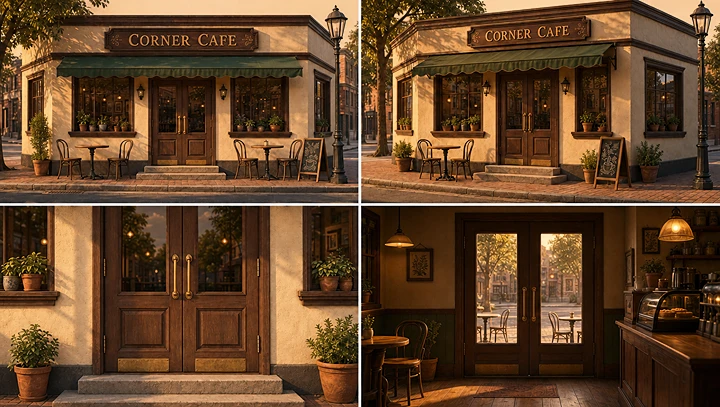
Zwei stilisierte Animationsfiguren, HAORAN und XIAOYU, treffen sich unerwartet vor einem Café, tauschen vier englische Dialogzeilen und betreten gemeinsam das Gebäude.
Drei Referenzbilder legen die Figuren und die Café-Umgebung fest. Der Prompt verlangt genauen Dialog, natürliche Mimik, konsistente Figurendesigns und eine bestimmte Tür-Aktion.
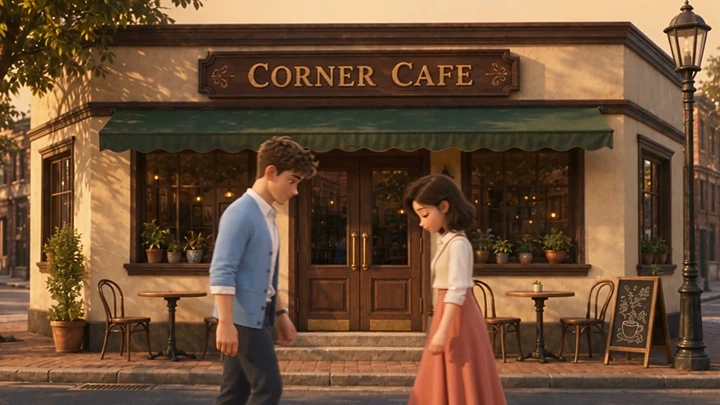
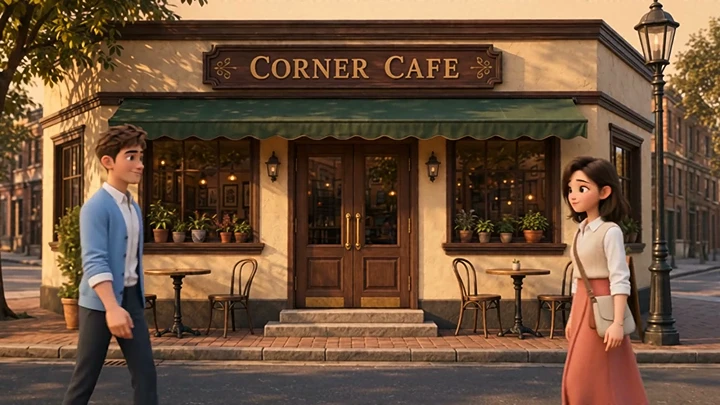
Dialogszenen verbinden mehrere anspruchsvolle Aufgaben: Sprachgenerierung, Lippensynchronität, Figurenkonsistenz, emotionales Spiel und koordinierte körperliche Interaktion.
Ein überzeugendes Ergebnis hängt davon ab, dass diese Elemente zusammenwirken. Dieser Test hilft einzuschätzen, wie wirksam jedes Modell figurengetragenes Erzählen umsetzt.
Beide Clips halten die Referenzdesigns: die blaue Strickjacke, die cremefarbene Weste, der lachsfarbene Rock und die Markise von Corner Cafe. Die Münder sind im Gespräch offen, aber Standbilder können die vier Zeilen oder echte Lippensynchronität nicht bestätigen. Der sichtbare Unterschied ist die Tür. Das letzte Frame von Wan 3.0 zeigt ihn mit der Messingklinke, während sie durch die offene Tür geht. Seedance 2.5 führt das Paar zum Eingang und hinein, ohne einen klaren Moment, in dem die Tür nach außen offen gehalten wird. Wählen Sie Wan 3.0 für dieses Briefing, wenn die Eingangsaktion zum Prompt passen muss. Beide Modelle taugen, wenn die beiden Figuren und das Café konsistent bleiben sollen; hören Sie die Zeilen, bevor Sie eine Aufnahme festlegen.
Text zu Video · 15s · 16:9
Eine Gruppe ausdrucksstarker Plüsch-Tierfiguren macht gemeinsam eine chaotische Autofahrt. Im fahrenden Fahrzeug führt jede Figur eine andere Aktion aus, während unerwartete Ereignisse eine Kette komischer Reaktionen auslösen.
Die Szene umfasst einen singenden Shiba-Inu-Fahrer, eine Katze beim Selfie, eine Ente, die sich ins Bild drängt, wandernde Hüte, hüpfende Mitfahrer, fliegende Objekte und koordinierte Gruppenreaktionen.
Der Prompt verlangt einen festen Kamerawinkel und eine durchgehende Plüsch-Filz-Darstellung über die 15-Sekunden-Sequenz.
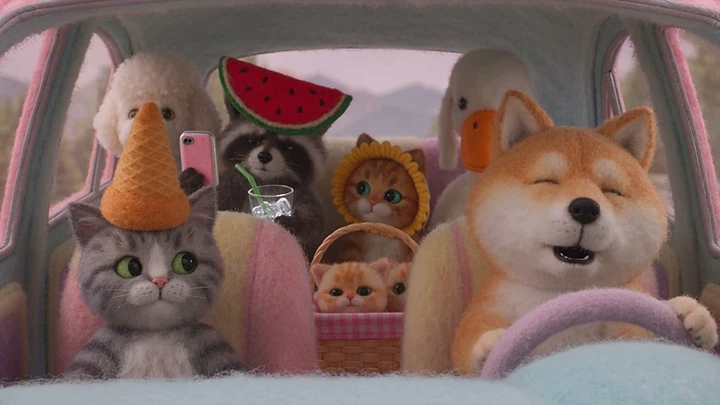
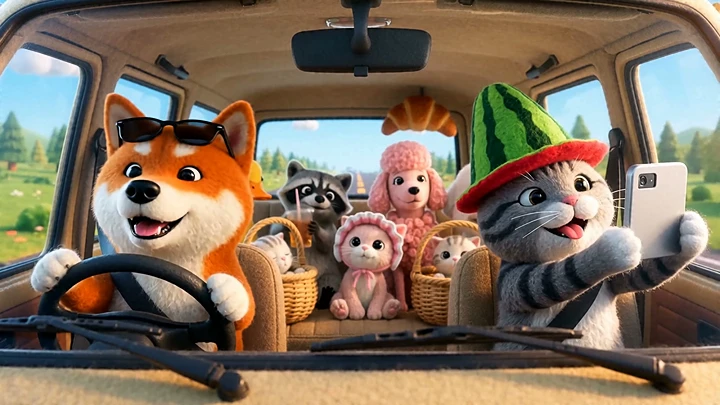
Spiel mit mehreren Figuren prüft, ob ein Modell mehrere unabhängige Aktionen in einer gemeinsamen Umgebung führen kann.
Die Herausforderung ist nicht nur, viele Figuren gleichzeitig zu erzeugen, sondern ihre Identitäten zu bewahren, ihre Interaktionen zu koordinieren und logische Ursache-Wirkung-Beziehungen in der Szene zu halten.
Seedance 2.5 hält den verriegelten Innenraum. Dieselbe Windschutzscheiben-Sicht zeigt den Shiba am Lenkrad mit offenem Maul, die Katze mit Melonenhut und die Ente. Der Hals der Ente kommt nach vorn, aber der Hutwechsel, das Auffangen der Traube und der abschließende Daumen hoch sind nicht sichtbar. Wan 3.0 zeigt mehr von diesen Gags: ein Croissant auf einem Kopf, den Pudel an den weißen Hund gedrückt, ein mürrisches Kätzchen im Korb und einen Daumen hoch vom Fahrer. Die Kamera verlässt auch den festen Winkel, schneidet von der ganzen Kabine auf die Rückbank und in den Korb, und Hüte sowie Sitzordnung verschieben sich. Wählen Sie Seedance 2.5, wenn eine feste Kamera und eine stabile Besetzung zählen. Wählen Sie Wan 3.0, wenn die komische Kettenreaktion wichtiger ist als ein einziger ununterbrochener Winkel.
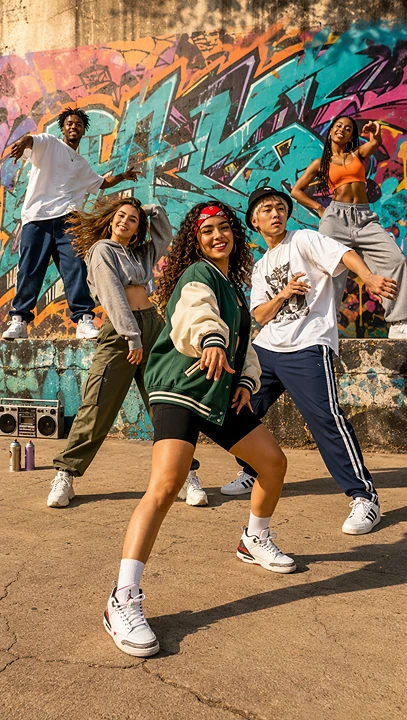
Mehrfachreferenz · 1 Bild + Audio · 15s · 9:16
Fünf Tänzer führen eine koordinierte Streetdance-Routine auf einem graffiti-bedeckten Platz aus. Ein Referenzbild legt ihr Aussehen fest, eine Audioreferenz die Choreografie.
Die Routine beginnt in V-Formation und wechselt in eine horizontale Linie. Der Prompt verlangt, dass alle fünf Tänzer ihre Identität behalten, den Formationswechsel abschließen und ihre Bewegungen in einer durchgehenden Einstellung mit der Originalmusik synchronisieren.
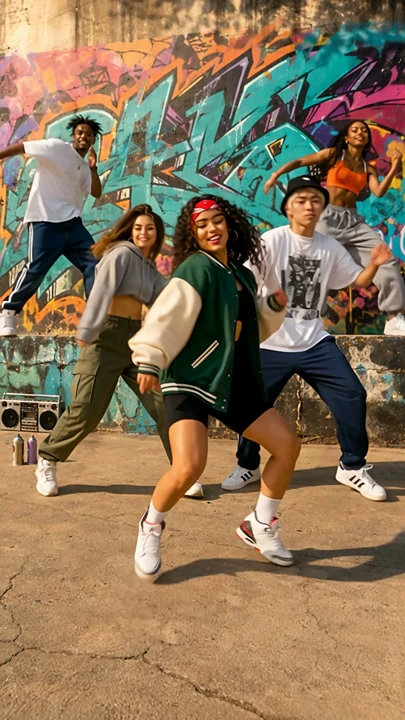
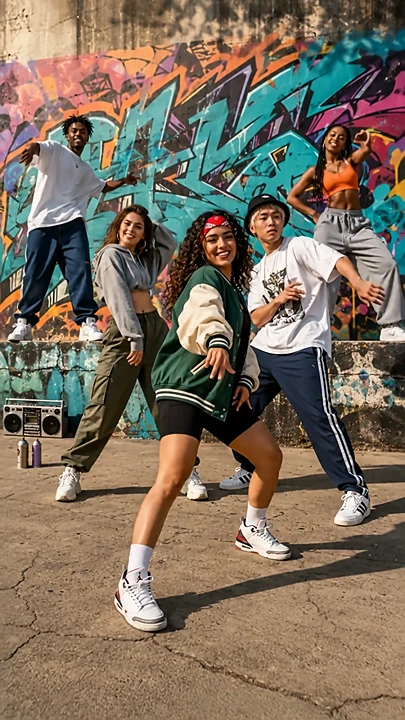
Tanzgenerierung verlangt präzise Abstimmung von visueller Bewegung, Figurenidentität, Gruppenposition und Audio-Timing.
Eine ansprechende Tanzfolge kann trotzdem scheitern, wenn die Darsteller die Synchronität verlieren oder die Formation falsch wechselt. Dieser Test prüft, ob jedes Modell mehrere Subjekte mit einer externen Musikreferenz koordinieren kann.
Wan 3.0 eröffnet näher am Referenzfoto: fünf Tänzer, die grüne Varsity-Jacke vorn und eine V-ähnliche Haltung vor der Graffiti-Wand. Auf halbem Weg verschwindet diese Gruppe, und ein Tänzer füllt den Platz, bevor ein späteres Frame mit einer lockereren Menge zurückkehrt. Seedance 2.5 hält in jeder Stichprobe eine Gruppe, einschließlich der grünen Jacke, aber spätere Frames fügen Personen hinzu und zeigen keinen sauberen Wechsel von der startenden V-Formation in eine horizontale Linie derselben fünf. Standbilder können nicht bestätigen, dass einer der Clips auf dem Originalbeat bleibt oder das Audio unangetastet lässt. Wählen Sie Seedance 2.5, wenn alle Tänzer im Bild bleiben müssen. Wählen Sie Wan 3.0, wenn die erste Einstellung zur Referenz passen muss, und sehen Sie sich die Mitte des Clips an, bevor Sie den Formationswechsel akzeptieren.
Text zu Video · 15s · 16:9
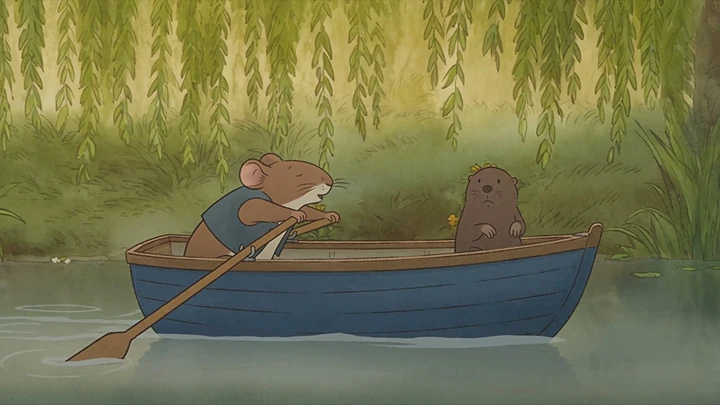
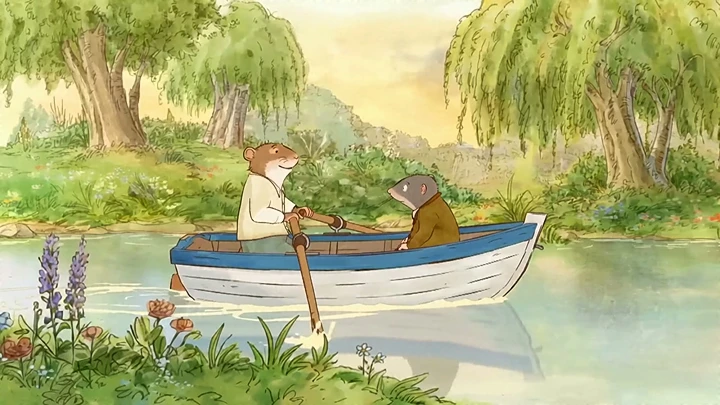
Eine kurze Szene aus The Wind in the Willows von Kenneth Grahame wird als edwardianische Aquarell-Animation adaptiert.
Eine Wasserratte rudert ein blau-weißes Boot einen friedlichen Fluss entlang, während ein Maulwurf im Heck sitzt. Als die Ratte im Gespräch versinkt, stößt das Boot ans Ufer, und der Ruderer kippt nach hinten, bevor er sich wieder aufrichtet.
Der Test verlangt von beiden Modellen, eine bestimmte literarische Folge wiederzugeben und dabei Rollen, körperliche Aktionen und ein konsistentes illustriertes Aussehen zu halten.
Literaturadaption verlangt, dass das Modell geschriebenes Erzählen in eine klare visuelle Folge überträgt.
Die Herausforderung ist nicht nur, ansprechende Bilderbuchbilder zu erzeugen. Das Ergebnis soll Figurenrollen, Ursache-Wirkung-Beziehungen und die wesentlichen Ereignisse bewahren, die die Originalszene erkennbar machen.
Dieser Test hilft einzuschätzen, wie treu jedes Modell eine detaillierte literarische Passage in ein kurzes Video überträgt.
Seedance 2.5 folgt der Passage weiter. Die Ratte rudert, während der Maulwurf im Heck sitzt, dann liegt die Ratte auf dem Rücken mit den Füßen in der Luft und setzt sich wieder auf. Das Boot liest sich als einheitlich blau, nicht als außen blau und innen weiß, und der Bug, der ans Ufer stößt, wird durch den Sturz nahegelegt, nicht gezeigt. Wan 3.0 trifft das Boot besser — außen blau, innen weiß — und hält ein stetigeres edwardianisches Aquarell, während sie unter den Weiden rudern. Die späten Frames kippen das Boot zu den Blumen und kehren dann zum ruhigen Rudern zurück, sodass der Sturz mit den Fersen in der Luft und das Wiederaufrichten fehlen. Wählen Sie Seedance 2.5, wenn Aufprall und Sturz lesbar sein müssen. Wählen Sie Wan 3.0, wenn das gemalte Boot und der ruhige Fluss wichtiger sind als die Pointe.
"Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)
Originalquelle: Kenneth Grahame, The Wind in the Willows (1908), Kapitel I. Gemeinfreier Text, verfügbar über Project Gutenberg.
9Diese neun Vergleiche im direkten Gegenüber zeigen, wie Seedance 2.5 und Wan 3 auf konkrete Briefings reagieren. Ergebnisse können je nach Generierung, Einstellung und Referenzeingabe variieren. Vergleichsurteile sollten sich auf die gezeigten Ausgaben und die dokumentierten Bewertungskriterien stützen.
Unsere Bewertung fragt, ob jede Ausgabe die ursprüngliche kreative Aufgabe löst.
Jeder Vergleich nutzt denselben vorgesehenen Prompt und dieselben Quelldateien. Ist eine Einstellung bei einem Modell nicht verfügbar, sollte dieser Unterschied dokumentiert und nicht als identische Testbedingung behandelt werden.
Wir prüfen, ob die verlangten Subjekte, Aktionen, die Szenenreihenfolge und die Enden in der Ausgabe erscheinen. Fehlende Schlüsselereignisse zählen als Einschränkung, auch wenn das Video poliert wirkt.
Bei bildgeführten Fällen vergleichen wir Figuren, Produkte, Outfits, Requisiten und Orte mit dem Ausgangsmaterial. Genauere Wiedergabe ist nicht unbedingt dasselbe wie attraktivere Gestaltung.
Wir prüfen Kamerapfade, Körperbewegung, Objektinteraktionen und das Verhältnis aufeinanderfolgender Einstellungen.
Wir achten auf Identitätsdrift, abrupte Rücksetzungen und inkonsistente räumliche Beziehungen.
Bei audiogeführten Fällen prüfen wir gesprochene Wörter, Sprecherzuordnung, Lippensynchronität, Tonsignale und Beat-Abstimmung, wenn die relevanten Quelldateien vorliegen.
Ein belastbarer Leistungsvergleich braucht Einreichungsprotokolle für jeden Versuch, einschließlich fehlgeschlagener Generierungen, Wiederholungen und Moderationsablehnungen.
Unser geplanter Benchmark nutzt drei Generierungen pro Modell bei einfacheren Aufgaben und fünf Generierungen pro Modell bei komplexeren Aufgaben, insgesamt 74 Generierungsversuche über beide Modelle.
Jedes abgeschlossene Video wird unabhängig mit einer vorab festgelegten Bewertungsrubrik beurteilt.
Um nicht nur visuell attraktive Ergebnisse herauszupicken, wird die repräsentative Benchmark-Ausgabe nach ihrer Nähe zum Median der blinden Qualitätsnote für dieses Modell und dieses Szenario gewählt.
Verschiedene Modelle können identische Anweisungen unterschiedlich auslegen.
Eine Ausgabe kann in der Komposition stärker sein, während eine andere eine Figur oder eine Aktion genauer bewahrt. Das bessere Modell für ein Projekt ist das, das den geforderten Qualitätsstandard zu akzeptablen Kosten erfüllt.
Vergleichen Sie dieselben Ausgabeeinstellungen, nicht nur den niedrigsten beworbenen Tarif.
Beide Modelle nutzen Topview-Credits, aber die tatsächliche Belastung hängt von Modellvariante, Workflow, Dauer, Auflösung und Kontotarif ab.
Das Credit-Angebot des Generators vor dem Absenden ist die relevanteste Zahl für Ihr Projekt.
| Auflösung | Seedance 2.5 in Topview | Wan 3.0 in Topview |
|---|---|---|
| 480p | 0.70 Credits/s | 0.30 Credits/s |
| 720p | 1.50 Credits/s | 0.50 Credits/s |
| 1080p | 3.70 Credits/s | 1.00 Credits/s |
Wenn eine Ausgabe mehrere Versuche braucht, bevor sie nutzbar ist, gehören diese Versuche zu den tatsächlichen Produktionskosten.
Vergleichen Sie verbrauchte Credits insgesamt, Ausgabequalität und die Zahl akzeptabler Ergebnisse, nicht nur den beworbenen Preis pro Sekunde.
Seedance 2.5 · Wan 3.0
Besseres AI-Video beginnt mit dem passenden Modell für die Aufgabe.
Wählen Sie Seedance 2.5 für referenzlastige Regie und detaillierte kreative Steuerung, oder sehen Sie sich Wan 3.0 an, wenn Ihr Briefing zu den verfügbaren Eingaben passt und Sie Generierungskosten vergleichen wollen.
Halten Sie Prompt und Referenzen gleich, prüfen Sie die Ausgaben und wählen Sie nach dem Ergebnis, nicht allein nach dem Modellnamen.