Topview
    • MCP/Skill
    • Plugin
    • API
    • Precios
    1. Home
    2. Seedance 2 5 Vs Wan 3

    Anuncios IA

    Agente de vídeo IAVídeo para anuncios IAVídeo de producto IAVídeo UGC IAURL a Video

    Avatar IA

    Generador de avatar IAAvatar de productoDiseñar mi avatarSincronización Labial IA

    Vídeo IA

    Generador de Video IADrama StudioIntercambio de Cuerpo en Video IAEscalador de Video IAEliminador de Marca de Agua IATikTok Watermark RemoverSora Watermark RemoverSubtitle RemoverControl de Movimiento IASincronización Labial IAURL a Video

    Imagen IA

    Generador de Imagen IAIntercambio de Rostro IAIntercambio de Personaje IAEscalador de Imagen IAInpaint IAEditor de Texto de Imagen IAEditor de Ángulo de FotoReiluminación IAFotografía de Producto IAPrueba Virtual IAGenerador de Storyboard IAExtraer paleta de coloresImagen a prompt

    Voz IA

    Voz en offClonación de voz IAGenerador de música IA

    3D

    3D World Generator3D Shot Composer

    Casos de uso

    PublicidadMarketing de afiliadosComercio electrónicoMarcas DTCTransmisión en vivo con IA

    Recursos

    BlogPrograma de afiliadosCentro de aprendizajeAlternativasAPI

    Empresa

    Topview StudioPolítica de privacidadTérminos
    Topview

    © 2026 TOPVIEW PTE. LTD.

    Singapore: 20 Collyer Quay #20-03, Singapore 049319
    Los Angeles: 15970 Los Serranos CC Dr #251, Chino Hills, CA 91709

    Wan 3.0 vs Seedance 2.5

    ¿Qué modelo de video AI te conviene?

    Tanto Seedance 2.5 como Wan 3.0 admiten flujos de trabajo de video AI de hasta 30 segundos, con opciones de salida que alcanzan 1080p en los flujos de trabajo de Topview compatibles.

    La elección práctica depende de tu brief: Seedance 2.5 merece considerarse para producciones con muchas referencias e instrucciones de temporización detalladas; Wan 3.0 merece considerarse cuando el costo de generación por segundo es una prioridad.

    Compara los ajustes compatibles, los videos lado a lado que ya existen y las compensaciones de cada modelo antes de generar.

    Probar Seedance 2.5

    Seedance 2.5

    Clips de hasta 30 segundos, hasta 50 referencias combinadas en el flujo de trabajo de Topview indicado y dirección detallada de plano y de audio.

    Wan 3.0

    Clips de hasta 30 segundos, hasta 20 referencias combinadas en la comparativa de Topview indicada y tarifas de referencia publicadas por segundo más bajas en modos de generación seleccionados.

    Los límites y los precios dependen del modo, de la cuenta y de los ajustes de generación que elijas. Revisa siempre el generador en vivo antes de enviar una tarea.

    Comparativa de Seedance 2.5 y Wan 3.0, especificación por especificación

    Ambos modelos combinan generación de video y dirección multimodal. La tabla separa la documentación a nivel de modelo de los ajustes indicados para el flujo de trabajo de Topview.

    DimensiónSeedance 2.5Wan 3.0
    DesarrolladorByteDanceAlibaba
    Uso principalBriefs creativos más largos y con muchas referenciasCreación multimodal con atención al costo de generación
    Duración4s–30s, seleccionable por segundo2s–30s, seleccionable por segundo
    Resolución480p / 720p / 1080p480p / 720p / 1080p
    Relaciones de aspecto16:9, 9:16, 3:4, 1:1, 4:3, 21:9 (más la opción adaptativa)16:9, 9:16, 1:1, 4:3, 3:4
    Texto a videoCompatibleCompatible
    Imagen a videoCompatibleCompatible
    Guía de video y audioCompatible en flujos de trabajo compatiblesCompatible en flujos de trabajo compatibles
    Referencias de imagenHasta 30Hasta 10
    Referencias de videoHasta 10Hasta 5
    Referencias de audioHasta 10Hasta 5
    Referencias combinadasHasta 50Hasta 20
    Generación de audioDisponible en flujos de trabajo compatiblesDisponible en flujos de trabajo compatibles
    Temporización y dirección de escenaInstrucciones con código de tiempo y selección de duración por segundoIndicaciones de plano y de escena, según el flujo de trabajo
    PrecioLos créditos varían según la resolución, la duración, el modo y el plan P. ej. 1.5 créditos/s en 720pLos créditos varían según la resolución, la duración, el modo y el plan P. ej. 0.5 créditos/s en 720p
    Ideal paraNarración con muchas referencias y dirección creativa detalladaGeneración atenta al costo y briefs creativos concretos

    Los límites de referencia reflejan los ajustes que figuran ahora en la comparativa de Topview, y no una garantía para todos los proveedores o todas las cuentas. Consulta el generador para ver los ajustes disponibles. Los precios de los planes están en la página de precios de Topview.

    ¿Qué modelo te conviene en esta comparativa?

    Empieza por el tipo de video que necesitas, no por el nombre del modelo. Estas recomendaciones hablan del encaje con el flujo de trabajo: no afirman que un modelo produzca siempre videos de mejor aspecto.

    Seedance 2.5 y Wan 3 admiten la generación de video AI de hasta 30 segundos, pero ofrecen ventajas distintas. Elige Seedance 2.5 para proyectos con muchas referencias, temporización precisa y dirección de audio detallada. Considera Wan 3 para una producción atenta al costo, relatos más largos en una sola toma y creación de escenas guiada por referencias.

    Elige Seedance 2.5 cuando...

    Necesitas combinar hasta 50 referencias multimodales

    Reúne briefs creativos complejos con hasta 50 recursos de referencia: 30 imágenes, 10 videos y 10 archivos de audio. Orienta la identidad del personaje, los detalles del producto, el movimiento, los entornos y el sonido dentro de un mismo flujo de generación. Wan 3 solo admite 20 referencias.

    Quieres usar referencias de video y de audio más largas

    Usa videos y archivos de audio de referencia de hasta 30.2 segundos cada uno, sujetos a los límites de duración combinada del flujo de trabajo. Orienta el movimiento, el ritmo y el sonido con tomas de movimiento más largas o con referencias musicales.

    Necesitas un control de video preciso, segundo a segundo

    Elige una duración de 4 a 30 segundos, en incrementos de un segundo. Usa instrucciones con código de tiempo para planear planos, acciones, transiciones y el ritmo de la escena dentro de un video continuo.

    Quieres sincronizar diálogo, música y efectos de sonido

    Dirige el diálogo, la música de fondo y los efectos de sonido con instrucciones con código de tiempo. Coordina el habla, la acción y la atmósfera con generación de audio nativa en un solo flujo de trabajo.

    Elige Wan 3.0 cuando...

    Quieres costos de generación más bajos y más predecibles

    Wan 3.0 figura con 0.30 créditos/seg a 480p, 0.50 a 720p y 1.00 a 1080p, frente a 0.70, 1.50 y 3.70 créditos/seg de Seedance 2.5 en los precios de referencia publicados en Topview. Revisa la cotización real de créditos antes de generar, porque las tarifas dependen del flujo de trabajo y del plan seleccionados.

    Necesitas un plano de video continuo de hasta 30 segundos

    Crea una secuencia de video continua de hasta 30 segundos sin unir varios clips cortos. Sirve para revelados de producto, movimientos de cámara sin interrupción e historias de marca que se benefician de un solo plano fluido.

    Quieres mantener un mundo coherente con Omni Reference

    Usa Omni Reference para orientar la identidad de los personajes, los objetos y los entornos a lo largo de un relato más extenso. Mantén el mundo creativo anclado a referencias visuales mientras desarrollas escenas y acciones.

    Necesitas creación de referencia a video asistida por búsqueda en internet

    Usa el descubrimiento de referencias asistido por búsqueda en internet para apoyar la creación de video con material visual y contextual adicional, cuando esta función esté disponible en tu flujo de trabajo de Topview.

    Probar Seedance 2.5

    Seedance 2.5 vs Wan 3: comparativa de videos lado a lado

    El mismo brief creativo. Dos modelos de video AI. Nueve escenarios reales.

    ¿Cómo se comparan Seedance 2.5 y Wan 3 cuando reciben las mismas instrucciones creativas? Explora nueve pruebas de video lado a lado: VFX cinematográficos, acción compleja, referencias multimodales, relato documental, cambios de estilo, diálogo, interacción entre personajes, sincronización de baile y adaptación literaria.

    Cada comparación muestra las salidas de ambos modelos junto con el prompt original y los recursos de referencia cuando corresponden. Mira cómo afronta cada modelo el mismo reto creativo, revisa los detalles que importan y explora qué modelo encaja mejor con cada tipo de proyecto.

    01. Espectáculo de VFX — efectos cinematográficos y continuidad del movimiento

    Texto a video · 30s · 16:9

    Qué hemos probado

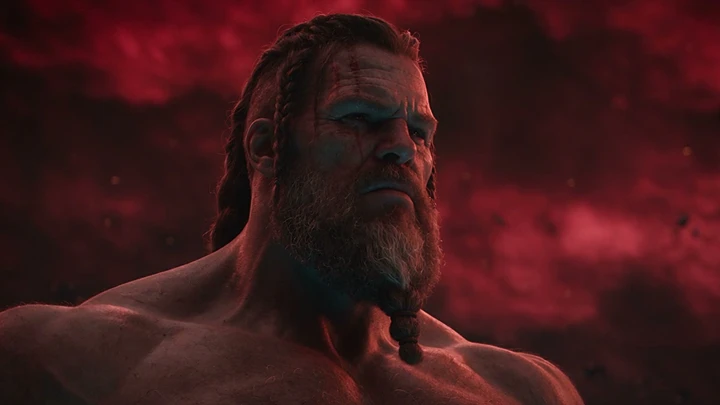
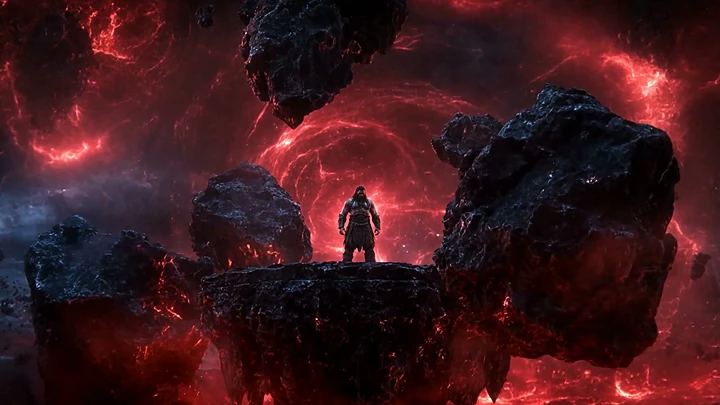
    Un dios nórdico se mantiene sobre un santuario de obsidiana fracturado mientras rayos dorados, escombros flotantes y runas luminosas avanzan hacia un clímax explosivo. La cámara hace una órbita continua de 360 grados mientras el personaje invoca un martillo de combate enorme y libera una onda expansiva potente.

    Esta prueba pide a ambos modelos que combinen efectos visuales complejos, movimiento del personaje, dirección de cámara dinámica y una secuencia de acción continua dentro de un solo video de 30 segundos.
    Salidas de video lado a lado

    Seedance 2.5 — 01. Espectáculo de VFX — efectos cinematográficos y continuidad del movimiento
    Seedance 2.5
    Wan 3 — 01. Espectáculo de VFX — efectos cinematográficos y continuidad del movimiento
    Wan 3

    Qué comparar

    • Continuidad de cámara: ¿La cámara completa el movimiento de 360 grados solicitado, sin saltos bruscos ni cambios de escena inesperados?
    • Secuencia de VFX: ¿Los rayos, los escombros flotantes, la formación del martillo y la onda expansiva aparecen en el orden previsto?
    • Consistencia del personaje: ¿El dios nórdico mantiene un rostro reconocible, proporciones corporales y apariencia a lo largo de la acción?
    • Coherencia visual: ¿Los efectos interactúan de forma natural con el personaje y con el entorno?

    Por qué importa esta prueba

    La generación de VFX cinematográficos exige más que fotogramas sueltos llamativos. El modelo tiene que coordinar el movimiento de cámara, las acciones del personaje y los efectos visuales, y mantener una secuencia coherente. Esta prueba ayuda a ver cómo maneja cada modelo escenas visualmente complejas con varias acciones que dependen unas de otras.

    Nuestro veredicto

    Seedance 2.5 mantiene mejor unido este brief. A lo largo del clip, un mismo dios barbado permanece en un mismo pico fracturado: un primer plano solemne, el mismo rostro con ojos luminosos, rayos que se acumulan sobre el santuario y, después, la figura en el aire con un martillo. Wan 3.0 logra efectos sueltos más fuertes —un portal rojo, una tormenta de escombros, una explosión dorada y un círculo de runas azul—, pero el dios desaparece en la mitad del clip y el martillo aparece como una pose después de la explosión, no como una fusión que se pueda seguir. Los fotogramas muestreados no muestran una órbita de 360 grados completa en ninguno de los dos modelos. Elige Seedance 2.5 cuando un personaje y un lugar tengan que escalar hasta el martillo. Elige Wan 3.0 cuando un plano de efectos espectacular importe más que mantener el mismo rostro y el mismo santuario.

    Ver el prompt completo
    A high-concept mythological action VFX cinematic spectacle shot on Sony Venice 2 with Cine Alta 8K sensor and Leica Summilux-C lenses, featuring photorealistic golden lightning arc flashes, dynamic ray-traced particle physics, floating terrestrial debris, and glowing ancient divine runes illuminated by hyper-detailed volumetric atmosphere. The continuous, seamless 360-degree whip-pan camera begins in a low-angle orbital sweep around a muscular, bearded Norse god suspended in mid-air above a fractured obsidian mountain shrine under a tempestuous crimson sky. His initial solemn and stoic composure dramatically shifts into furious rage as his eyes burst into blinding blue plasma energy, casting vibrant specular highlights across his weathered skin and braided hair. As the camera accelerates its continuous spiral rotation around the god, he lets out a guttural, thunderous roar, raising his right hand to summon violent streaks of celestial lightning that erupt from swirling storm clouds. The raw electrical arcs violently pull floating stone fragments and divine liquid metal together into a swirling vortex, instantly fusing them into a massive, glowing, runic-engraved battle hammer in his fist. Upon gripping the weapon, he detonates a massive radial gravity shockwave that instantly pulverizes the surrounding floating boulders into fine stardust particles and ripples through the thick atmosphere, leaving the ancient fractured shrine beneath him pulsing with deep blue subterranean magic. The unbroken dynamic shot completes its orbital loop to settle into a dramatic wide hero framing of the god hovering amidst the dissipating energy dust, legendary, majestic, thunderous, and escalating from tense stillness to an overwhelming explosive climax.
    1

    02. Combate contra un jefe — acción compleja y consistencia espacial

    Multirreferencia · 2 imágenes · 30s · 16:9

    Qué hemos probado

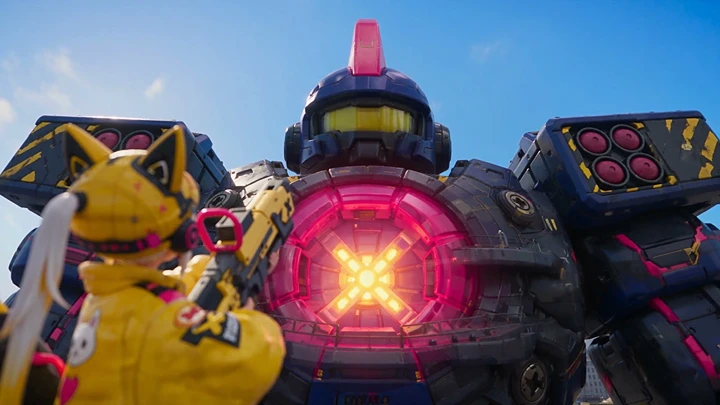
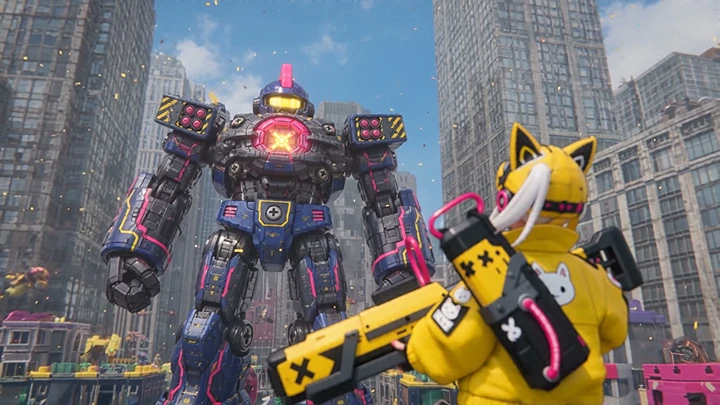
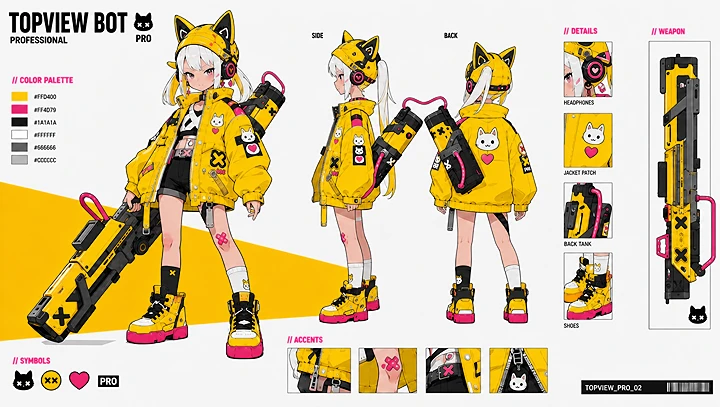
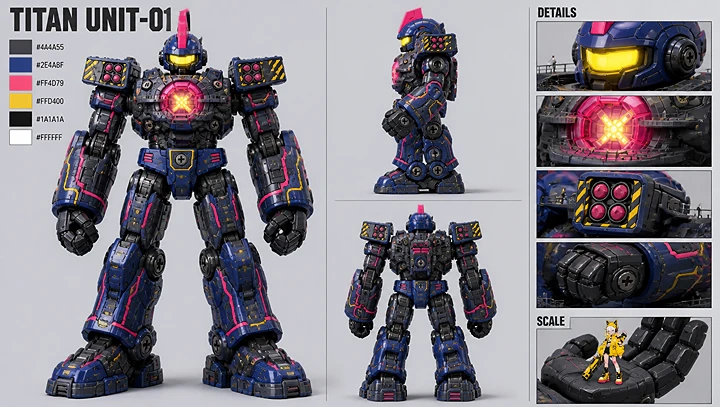
    Una heroína pequeña, TOPVIEW BOT, combate contra un mecha de juguete gigante llamado TITAN en una ciudad de juguetes de colores. Dos imágenes de referencia definen la apariencia exacta de ambos personajes, y el prompt precisa su escala relativa, la dirección de las armas, las secuencias de ataque y el movimiento continuo.

    El combate de 30 segundos incluye ataques con misiles, maniobras de evasión, combate en el aire, un ascenso por la armadura del mecha y un ataque de energía final.
    Salidas de video lado a lado

    Seedance 2.5 — 02. Combate contra un jefe — acción compleja y consistencia espacial
    Seedance 2.5
    Wan 3 — 02. Combate contra un jefe — acción compleja y consistencia espacial
    Wan 3

    Qué comparar

    • Fidelidad a la referencia del personaje: ¿TOPVIEW BOT y TITAN conservan los diseños que muestran sus imágenes de referencia?
    • Consistencia de escala: ¿La heroína sigue siendo mucho más pequeña que el mecha gigante durante todo el combate?
    • Continuidad de la acción: ¿Los movimientos y los eventos de combate siguen una secuencia coherente, sin teletransportes inesperados ni reinicios de escena?
    • Razonamiento espacial: ¿Los personajes mantienen posiciones, direcciones y distancias lógicas durante la pelea?
    • Precisión de las armas: ¿Los misiles y los rayos de energía salen de las armas correctas y viajan hacia los objetivos previstos?

    Por qué importa esta prueba

    Las escenas de acción compleja exigen mucho a la generación de video AI. El modelo tiene que mantener personajes consistentes, entender la escala relativa, conservar las relaciones espaciales y coordinar varias acciones a lo largo del tiempo. Esta prueba examina si las secuencias de combate visualmente ambiciosas siguen siendo comprensibles.

    Nuestro veredicto

    Wan 3.0 se ajusta mejor a las hojas de referencia en este combate. Su apertura mantiene legibles las coletas blancas, la gorra con orejas de gato, la chaqueta amarilla y el cañón frente al mecha azul marino, la cresta rosa, la visera amarilla y el núcleo rosa del pecho, y un fotograma posterior muestra misiles en el aire antes de que ella vuelva a la armadura. Seedance 2.5 gana la lectura de escala en el plano del puño, donde ella es diminuta frente a la mano, pero baja al nivel de la calle y su rostro y su arma son difíciles de comprobar cuando la cámara abre el plano. Seedance termina en una explosión rosa con quien dispara fuera de cuadro; Wan termina con ella pequeña frente a la visera. Elige Wan 3.0 cuando las hojas de personaje y el momento de los misiles tengan que seguir siendo reconocibles. Elige Seedance 2.5 cuando el contraste entre lo gigante y lo diminuto importe más que una coincidencia limpia con la referencia.
    Ver el prompt completo y las referencias

    Recursos de referencia

    Ref. de imagen 1 — diseño de personaje de TOPVIEW BOT
    Ref. de imagen 1 — diseño de personaje de TOPVIEW BOT
    Ref. de imagen 2 — diseño del mecha TITAN
    Ref. de imagen 2 — diseño del mecha TITAN
    Toy-world giant boss battle CG, 30s, one continuous unbroken take, seamless continuation from the previous shot. No scene reset, no intro, no establishing shot, no pause, no boss defeat pose. Reference inputs: <<<Image1>>> = TOPVIEW BOT, the small agile girl. <<<Image2>>> = TITAN, the giant boss mech. These names always refer to these images. Each image is the sole visual source for its character's design; match exactly, do not redesign; images override any conflicting text. The previous clip governs pose, momentum, lighting and camera state at frame one. First frame continues the previous ending: TOPVIEW BOT already standing on TITAN's chest armor platform, facing its glowing head at close range above a massive toy city; camera, lighting, pose, wind and momentum carry over seamlessly. TOPVIEW BOT lock (all details per <<<Image1>>> ): a human girl — silver-white twin tails, pink X cheek bandage, yellow cat-ear cap (headwear only), bright yellow oversized jacket, yellow-and-black toy cannon with pink handle, pink cable to her back tank. NO tail of any kind. Palette: bright yellow, hot pink, black, white, grey. TITAN lock (all details per <<<Image2>>> ): hundred-meter toy mech, glossy plastic and diecast, navy-and-grey armor, pink mohawk crest, glowing yellow eye visor, glowing pink X chest core, quad-tube pink shoulder missile pods, segmented giant fists. Weapon set, all must appear: HOMING missiles that track TOPVIEW BOT mid-air, giant fist strikes, sustained yellow visor beam, chest-core energy pulse, toy drones from hidden panels. Scale chain (every frame): TOPVIEW BOT is a child-sized human, small enough to stand inside TITAN's palm (as in the reference sheets). TITAN is 100m tall, matching the grey skyscrapers behind. Toy structures reach only TITAN's shins. On TITAN's body she is smaller than a single armor plate; one fingertip is larger than her whole body. Wide frames include a nearby scale reference (armor seam, screw head, debris). She is NEVER building-sized. Energy source rule (entire 30s): every energy effect has exactly one origin. Yellow beams ONLY from TITAN's visor. Pink-yellow blasts ONLY from her cannon muzzle, traveling along her barrel line. No beams from the sky, off-screen, or multiple directions. Aim rule (every shot): shooting is a four-beat sequence rendered in full — she STOPS, PLANTS her feet or braces mid-air, AIMS both-handed until the barrel line from hands to the named target is clearly visible, then FIRES along that line. Never fires while running, never at empty air. Environment: giant toy city battlefield — building blocks, gift boxes, toy trains, Ferris wheels, teddy bears, plastic debris; realistic grey skyscrapers behind, bright blue sky, floating confetti. Spatial continuity (entire 30s): she never leaves TITAN's body or the air around it. When separated, they face EACH OTHER — never the same direction side by side. When she is ON TITAN's body, TITAN tracks her ONLY by turning its head and visor; torso and legs stay planted in one orientation for the entire film, changing only by slow visible rotation, never flipping or snapping. She never turns her back to TITAN; dodges are sideways or sliding, eyes and cannon toward the threat. Every segment starts exactly where the last ended: same position, facing, camera. No teleporting for either character. Timeline (every beat is an exchange; state carries across boundaries): 0–5s | Face-off. Over-the-shoulder staging: camera low behind TOPVIEW BOT — her back and twin tails in the foreground, past her shoulder TITAN's glowing head facing her; her figure tiny on the vast chest armor plain. Muzzle aimed at the yellow visor, barrel line visible, NOT lowered. TITAN's visor flares and locks on; head tilts down toward her, servos grinding, missile hatches snap open. She narrows her stance, muzzle on the visor. Camera: slow push-in past her shoulder toward the visor, one move. End: chest center, facing each other, cannon aimed; camera low behind her shoulder. 5–10s | Salvo and sweep. Homing missiles spiral from the shoulder pods toward her while TITAN's open hand sweeps across its own chest to swat her. She dives sideways, slides flat under the sweeping fingers. As the hand pulls back for a second sweep she springs up, STOPS, plants her feet, aims — barrel line to the open palm — and fires two shots INTO the palm, staggering the hand; missiles blast toy debris around her. Camera: swings with her dive into fast lateral tracking, wide lens, heavy motion blur, the giant hand crossing the foreground; settles for the firing beat, then resumes; no cuts. End: chest edge, facing TITAN's head, missiles airborne behind her. 10–15s | Airborne duel. A near-miss explosion hurls her off TITAN. The missiles curve up after her as one tight cluster; the visor fires a sustained yellow beam tracking her. She spins around the beam and stabilizes at the top of her arc facing TITAN. She hangs one beat: braced mid-air, both hands on the grip, muzzle leveled at the cluster — one straight barrel line — then fires a single full-power blast from her muzzle along that line, detonating the cluster in a chain reaction. Camera: carried by the blast into one continuous 360-degree orbit around her, toy city far below; design locked to <<<Image1>>> through every angle. End: top of her arc, facing TITAN, its forearm already rising toward her; torso unmoved. 15–20s | Arm ride. TITAN raises its forearm before its chest to swat her — she angles her fall and lands ON the raised forearm, facing up-arm toward the head. Torso and legs stay planted; TITAN slowly draws the forearm inward toward its own face, visor tracking her, carrying her closer to its head. Its other fist hammers down onto the forearm; she slides forward under the descending fist, dust blasting up. Toy drones dive at her from both sides — she does NOT shoot them; she weaves between them at full sprint and two drones collide chasing her, tumbling off the arm. The in-drawn arm reaches the shoulder; she leaps onto the shoulder armor. Camera: falls with her onto the arm, stays low behind her run as the arm visibly draws inward, drones whipping past the lens, extreme scale contrast. End: on the shoulder, helmet looming above, TITAN's head turned toward her, torso unmoved. 20–25s | Climb to the strike. She leaps from the shoulder toward the helmet. TITAN overcharges its pink X core — rhythmic pulses race up its body, she times her jumps between pulses; its head thrashes in place, body planted. The overcharge exhausts: pulses stop, the visor dims — her window. She lands on the mohawk crest, plants both feet above the visor, flips the cannon downward and jams the muzzle against the visor's top edge — barrel pointing straight down into TITAN's head, both hands on the grip, cable taut — holding as the cannon charges at her muzzle, the only energy light in frame. Camera: one continuous crane rise around the thrashing TITAN, each pulse pushing the frame wider, settling as pulses die. End: braced on the helmet, muzzle pressed to the dimmed visor, fully charged. 25–30s | Blast and continuation. She pulls the trigger: ONE massive beam fires from her muzzle straight down through the visor — sole origin her cannon, sole direction downward along her barrel. Light bursts outward from INSIDE the helmet seams. TITAN's final act — its near fist rises toward its own helmet to crush her, too late: the helmet cracks and TITAN breaks apart into thousands of toy blocks, every fragment from <<<Image2>>> 's materials and colors, no new parts. She kicks off the collapsing helmet, leaps through the fist's shadow and falling debris — blocks tumbling past many times her size — lands on a tumbling block still moving forward. Camera: pushes in close along her barrel line for the beam, then follows her leap through the debris, same take, cutting during action. No victory pose, no freeze frame. Style: AAA game boss battle trailer, stylized anime-inspired 3D CG, glossy toy materials, Ratchet & Clank + Astro Bot + Hi-Fi Rush feeling; high saturation, cinematic lighting, strong rim light, physical debris simulation, constant motion blur, dynamic camera, 24fps anamorphic widescreen. Audio, three distinct layers: BGM: fast electronic rock, heavy drums, synth brass, toy-box chimes, building throughout; ducks under major attacks; cuts off mid-action. TOPVIEW BOT SFX (bright, high-frequency): plastic footsteps, rising cannon charge whine, sharp discharge pops, chime accents on jumps. TITAN SFX (heavy, low-frequency): servo motors, hydraulic hisses, missile hatch clacks, salvo whooshes, beam hum, sub-bass core pulses, groaning diecast, massive fist thuds with plastic rattle. Environment: explosions with toy-brick scatter, debris rain, drone collision crunches. Negative: static camera, slow pacing, scene reset, character redesign, deviation from <<<Image1>>> or <<<Image2>>> , giant girl, shrunken mech, 180-degree body snap, wrist spinning, beams from the sky, firing while running, cat tail, blue jacket, bunny ears, extra limbs, distorted face, bad hands, subtitles, text, watermark, UI, realistic military weapons, gore, dark desaturated colors, black screen, slow-motion ending.
    2

    03. Razonamiento con referencias — consistencia entre imágenes y construcción de mundo

    Multirreferencia · 3 imágenes · 30s · 16:9

    Qué hemos probado

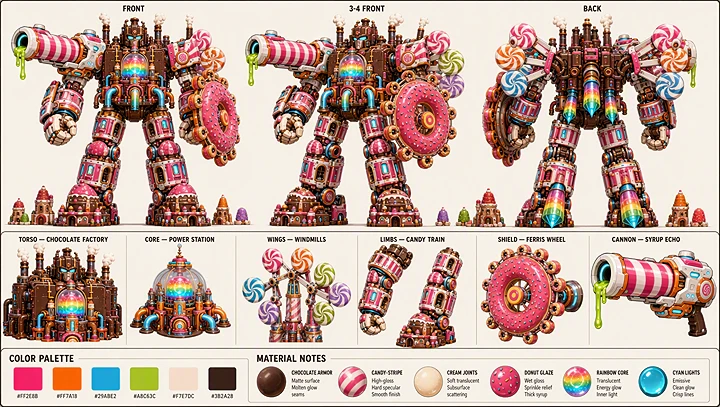
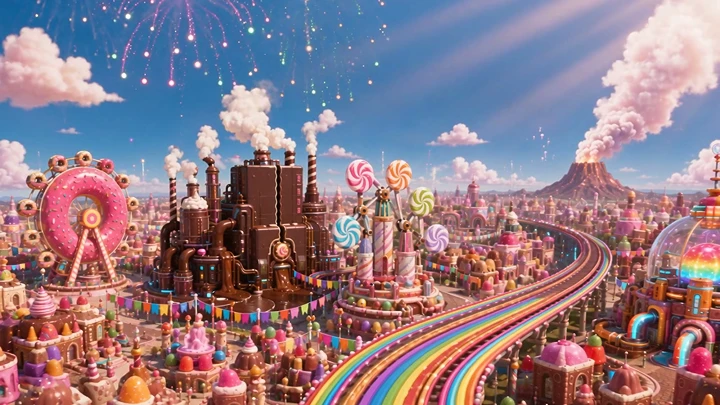
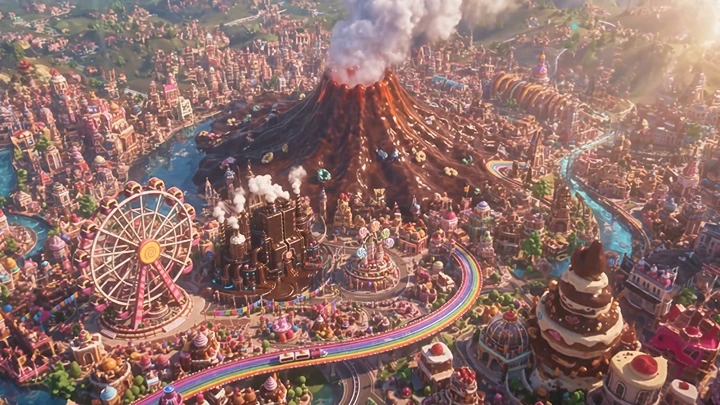
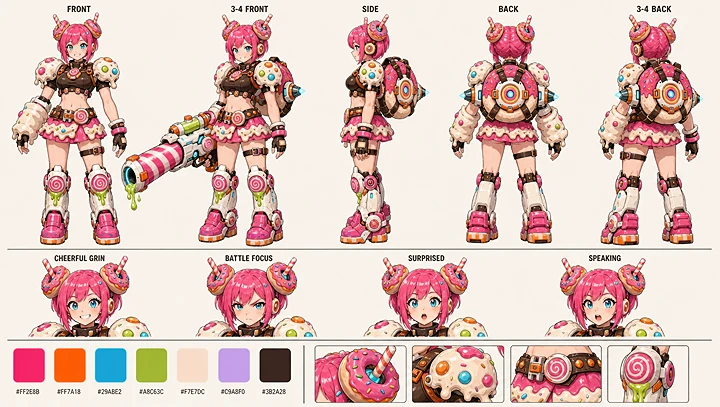
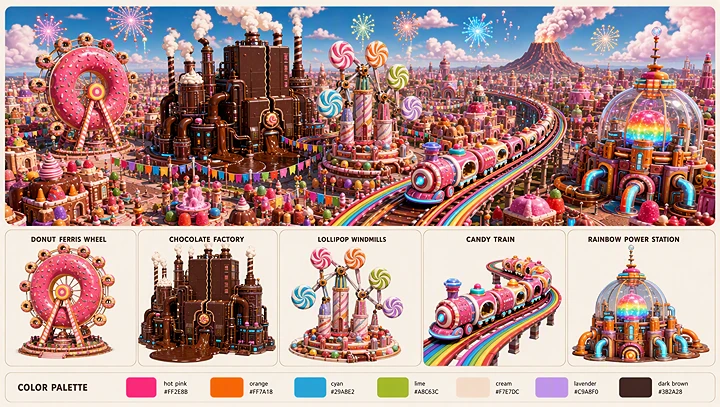
    Un colorido Candy Kingdom enfrenta una amenaza que crece, y la heroína SUGAR POP debe defender la ciudad antes de que sus hitos se combinen en un Candy Super Mecha gigante.

    Tres hojas de referencia definen la apariencia de la heroína, el entorno de Candy Kingdom y sus hitos, y el mecha final ensamblado. El prompt exige que ambos modelos conserven estos diseños mientras generan una historia de acción completa de 30 segundos.
    Salidas de video lado a lado

    Seedance 2.5 — 03. Razonamiento con referencias — consistencia entre imágenes y construcción de mundo
    Seedance 2.5
    Wan 3 — 03. Razonamiento con referencias — consistencia entre imágenes y construcción de mundo
    Wan 3

    Qué comparar

    • Identidad del personaje: ¿SUGAR POP mantiene los rasgos faciales, el peinado, la ropa y los accesorios de la referencia?
    • Fidelidad del entorno: ¿Los hitos de Candy Kingdom son reconocibles y coherentes con el diseño de ciudad aportado?
    • Integración de varias referencias: ¿El modelo puede combinar las referencias de personaje, entorno y mecha en un relato coherente?
    • Transformación de objetos: ¿Los hitos indicados se combinan en el Candy Super Mecha y conservan el diseño previsto de cada componente?
    • Cierre de la historia: ¿El video avanza por el conflicto, la transformación, el combate y el final previstos?

    Por qué importa esta prueba

    La generación con varias referencias exige que el modelo entienda cómo se relacionan entradas visuales separadas. Además de reproducir objetos sueltos, tiene que conservar la identidad, combinar elementos de diseño y mantener un mundo creativo coherente entre escenas que cambian.

    Esta prueba ayuda a evaluar con qué fiabilidad traduce cada modelo varias imágenes de referencia a un video más largo y estructurado.

    Nuestro veredicto

    Seedance 2.5 es el resultado multirreferencia más sólido. Su primer plano conserva el bob rosa de Sugar Pop, los ojos azules y los accesorios de caramelo en el pelo; el centro del clip lanza hitos de caramelo por separado; y el robot en plano abierto coincide con la hoja del mecha, con el cañón de hombro a rayas, el escudo de antebrazo en forma de dónut y las extremidades de caramelo en un mismo cuerpo. El final es un haz de color con ese robot todavía en cuadro. Wan 3.0 abre con el Candy Kingdom más claro —noria, volcán y calles de caramelo— y es el clip que muestra el monstruo de postre sobre la ciudad. Sus fotogramas posteriores se quedan en un tren de caramelo y en un rostro de robot borroso, así que el mecha ensamblado nunca encaja como especifica la hoja de diseño. Elige Seedance 2.5 cuando el personaje, la combinación y el mecha terminado tengan que sobrevivir en un mismo video. Elige Wan 3.0 cuando el reino y el monstruo tengan que leerse primero.
    Ver el prompt completo y las referencias

    Recursos de referencia

    Ref. de imagen 1 — hoja de personaje de SUGAR POP
    Ref. de imagen 1 — hoja de personaje de SUGAR POP
    Ref. de imagen 2 — hoja de entorno de Candy Kingdom
    Ref. de imagen 2 — hoja de entorno de Candy Kingdom
    Ref. de imagen 3 — diseño de Candy Super Mecha
    Ref. de imagen 3 — diseño de Candy Super Mecha
    [REFERENCE IMAGES — visual source of truth] <<<Image1>>> = SUGAR POP character sheet: face, hair, outfit, syrup cannon, donut pack. All heroine appearances match @image1 exactly; it overrides any conflicting text below. <<<Image2>>> = CANDY KINGDOM city sheet: skyline layout and the five landmarks (donut ferris wheel, chocolate factory, lollipop windmills, candy train, rainbow power station). All city views and combining buildings match @image2. <<<Image3>>> = CANDY SUPER MECHA sheet: the assembled 300m mecha. All mecha shots match @image3 exactly — component placement, donut shield on left forearm, syrup cannon on right shoulder. Use reference images for design only — do NOT copy their sheet layouts, labels, or color swatches into any frame. [CHARACTER LOCK — identical in every frame, matching <<<Image1>>> ] One cheerful girl hero, young adult in her early 20s, slim athletic build, bright confident smile. Hair: short glossy hot-pink bob with soft bangs, twin side buns wrapped in candy-ring hairpieces (pink/orange/cyan glaze with sprinkles), two candy-stick antennae angled up, syrup highlights. Face: large cyan-blue eyes, thick lashes, small pink blush marks, pale skin. Outfit: dark brown cropped armor top, bare midriff; oversized cream-frosting shoulder pauldrons with candy gems (pink/orange/cyan/lime); short layered frosting skirt with scalloped drip hem and candy trim; brown studded belt with candy buckles; puffy cream gauntlet on right arm, black fingerless glove on left; black thigh strap; chunky white-pink candy mech leg armor with lollipop-disc knees and glaze drips; hot-pink platform boots with orange candy-stripe soles. Weapon: oversized syrup cannon, pink-white candy-stripe barrel, glossy white/orange sci-fi housing, cyan lights, lime syrup dripping from muzzle — as in @image1. Backpack: donut-shaped pack with pink glaze, yellow-pink center ring, side thrusters, doubles as spinning shield — as in @image1. Palette: hot pink #FF2E8B, orange #FF7A18, cyan #29ABE2, lime #A8C63C, cream #F7E7DC, lavender #C9A8F0, dark brown #3B2A28. Same face, hair, armor, cannon in all shots. No costume change, no lookalike characters. [SHOT SEQUENCE — 30s, continuous escalation] 0-2s: Sweeping crane shot over Candy Kingdom festival matching <<<Image2>>> : donut ferris wheel, gumdrop rooftops, rainbow parade, candy fireworks, warm sunny light. 2-4s: Ground shakes. Whip-pan to syrup volcano erupting; colossal dessert monster of molten chocolate, cake slabs and gnashing candy teeth climbs out, swallowing an ice-cream tower. Monster design consistent for the entire video. 4-6s: Low-angle hero reveal: Sugar Pop (<<<Image1>>> ) boosts in on donut-pack thrusters, lands hard on a lollipop platform, cannon snapping into firing position, cream splash on impact. 6-9s: High-speed chase cam beside her as she sprints and boost-dashes across cotton-candy clouds and rainbow rails, firing rainbow candy shells and jelly missiles; camera rolls with her. 9-11.5s: Tracking past monster flank: she unloads a cream shockwave, glaze exploding across its body, but it absorbs the candy energy, glowing brighter and swelling larger. 11.5-14s: Aerial pull-back: monster towers over skyline, engulfing a chocolate district. Tight close-up of her determined eyes, hard cut. 14-17s: CITY COMBINATION. Rapid montage of the five landmarks from <<<Image2>>> : donut ferris wheel DISC detaches — its A-frame base stays on the ground; chocolate factory splits, lollipop windmills fold, candy train coils, rainbow power station ignites. Buildings launch skyward. 17-20s: Orbiting crane shot: the candy structures lock together in midair, forming the 300m candy super mecha exactly matching <<<Image3>>> ; final piece slams into chest with rainbow flash. 20-22s: Interior beat: she (<<<Image1>>> ) leaps into cockpit, candy controls light up. Wide low angle: mecha eyes ignite cyan, cream fists clench, donut shield spins on left forearm, rainbow thrusters flare — all per @image3. 22-26s: Titan clash. Fast alternating shots: mecha cream-fist uppercut; monster chocolate slam blocked by spinning donut shield; syrup energy cannon charges on right shoulder — mecha stays on-model with <<<Image3>>> throughout. Impacts spray candy shards, rainbow particles and cream fireworks. 26-28.5s: Ultimate attack: mecha crosses arms, chest core blooms, colossal rainbow beam pierces sky and wraps monster completely. Darkness dissolves into color; camera pushes through light. 28.5-30s: Kingdom restored matching <<<Image2>>> , festival resumes, confetti and candy petals falling. Fast push-in to syrup volcano crater in distance: two enormous eyes slowly open in darkness — same eye design as the monster. Cut mid-motion. [STYLE / TECH] Hyper-saturated stylized 3D animation with anime shading, glossy candy subsurface materials, syrup gloss and soft-cream translucency. Blend Super Sentai combining sequences, Gundam mecha weight/paneling, Wreck-It Ralph candy density, Kirby cuteness, Disney lighting. Rainbow bloom, sugar-dust particles, sprinkle debris, glaze splashes, volumetric sunbeams, anamorphic flares, punchy motion blur, brief speed ramps on impacts. 24fps cinematic shutter, 2.39:1 widescreen, crane/drone/handheld chase cameras, camera always moving. Joyful heroic energy, scale escalating every few seconds. [NEGATIVE] static camera, freeze frame, fade to black, slow-motion ending, victory pose ending, character inconsistency, hair/eye color change, costume change, cannon design change, duplicate lookalike girls, mecha deviating from <<<Image3>>> , ferris wheel base attached to the mecha shield, monster design changing mid-video, reference sheet layouts or labels appearing in frame, dark or desaturated grading, horror/grotesque gore, blood, realistic photo style, off-model face, warped hands, extra fingers, text artifacts, watermark, logo overlay, blurry, low detail, dialogue close-ups, idle empty frames. [AUDIO] Uplifting orchestral-electro sentai theme with brass hits, candy chimes, bell layers, huge riser into 17s, mecha servo clanks, gooey syrup splats, deep booms on titan impacts, sparkling twinkle on final beam. No dialogue.
    3

    04. Narración documental — relato y alineación entre audio y imagen

    Texto a video · 30s · 16:9

    Qué hemos probado

    Un documental de historia natural retrata los últimos momentos de un ecosistema prehistórico: pasa de un valle tranquilo lleno de dinosaurios a un impacto catastrófico, una onda expansiva, erupciones volcánicas y una Tierra cubierta de ceniza.

    El prompt combina una voz en off en inglés cronometrada con precisión, cinematografía de estilo documental, eventos ambientales a gran escala, movimiento animal realista y un final orbital en calma.
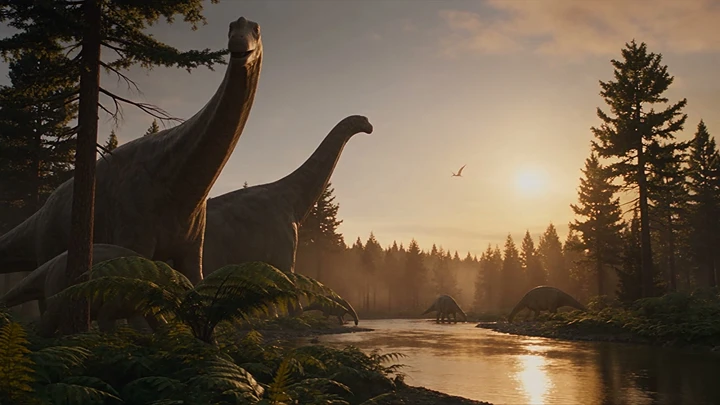
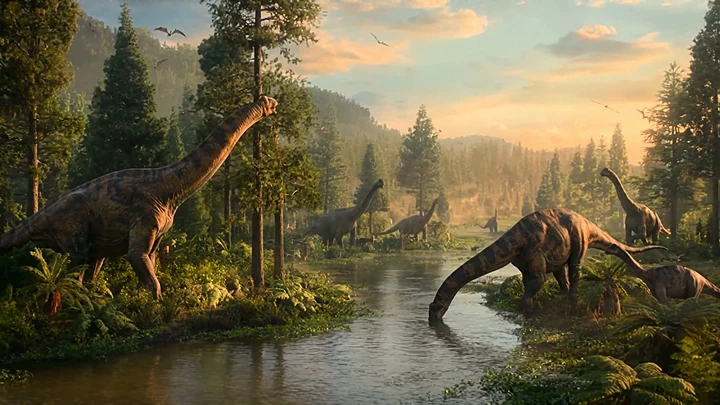
    Salidas de video lado a lado

    Seedance 2.5 — 04. Narración documental — relato y alineación entre audio y imagen
    Seedance 2.5
    Wan 3 — 04. Narración documental — relato y alineación entre audio y imagen
    Wan 3

    Qué comparar

    • Precisión de la narración: ¿La voz en off generada sigue el guion aportado, con la redacción, el ritmo y las pausas previstos?
    • Sincronización de audio e imagen: ¿Las imágenes corresponden a los eventos narrados en los momentos adecuados?
    • Progresión de la escena: ¿La historia avanza de forma coherente desde el valle tranquilo hasta el impacto, la destrucción ambiental y la vista orbital final?
    • Movimiento y escala: ¿Los dinosaurios, la onda expansiva, los eventos volcánicos y los efectos ambientales mantienen un movimiento creíble y una escala relativa creíble?
    • Estilo documental: ¿El material conserva la luz natural, el grano de película, la profundidad atmosférica y el tratamiento visual realista solicitados?

    Por qué importa esta prueba

    La generación de video documental depende de una comunicación precisa, no solo de imágenes cinematográficas. La narración, el tiempo de las escenas, el relato visual y la continuidad ambiental tienen que funcionar juntos para comunicar una secuencia completa.

    Esta prueba examina cómo coordina cada modelo la narración hablada con eventos visuales complejos a lo largo de 30 segundos.

    Nuestro veredicto

    Wan 3.0 lleva más lejos la historia en imágenes. Los fotogramas pasan de un valle fluvial dorado a una estampida de frente bajo un muro de polvo, una erupción, un animal caído entre la ceniza y una Tierra gris en órbita. Seedance 2.5 también va del valle soleado a una manada en carrera, una inundación con un estegosaurio pequeño y un saurópodo gris ceniza, pero sigue en el valle tranquilo bien avanzado el clip, y su último fotograma muestreado es un gris sin rasgos, no una órbita. La inundación, y el animal pequeño frente al paisaje, se leen con más claridad en Seedance. Estos fotogramas no confirman la redacción hablada, el ritmo ni las pausas. Elige Wan 3.0 cuando el video tenga que llegar al colapso y al final orbital. Elige Seedance 2.5 cuando el valle y la inundación tengan que seguir siendo naturalistas, y comprueba después si tu propia generación llega a la órbita.

    Ver el prompt completo
    Duration: 30s | Aspect ratio: 16:9 ━━ STYLE & FILM LANGUAGE ━━ [P0] Natural history documentary footage. Muted natural color grade, natural sunlight only. Voice-over narration only — no on-screen speaker, no subtitles, no text anywhere in frame. [P1] Shot on 35mm film with extreme telephoto lenses: visible film grain, lifted blacks, atmospheric haze softening distant layers, heat shimmer above sun-warmed ground, occasional out-of-focus foliage crossing the foreground, subtle handheld drift as if filmed from a concealed hide. [P2] Anamorphic lens characteristics: gentle horizontal flare on the impact flash, oval bokeh in defocused foregrounds. Dust motes drifting through backlit air. ━━ NARRATION (voice-over audio generation) ━━ [P0] Generate an English voice-over narration as the primary audio layer. Voice: deep male documentary narrator, low register, calm gravity. Pacing: slow and measured, unhurried, clear pauses between sentences. [P0] The narration text below is AUDIO CONTENT ONLY — a spoken voice-over. It must NEVER appear as on-screen text, subtitles, captions, or lettering in any frame. [P0] Narration script, timed to the visual segments: [0–6s, over the golden valley] "For a hundred and sixty million years... they ruled the Earth." [6–8s] SILENCE — no narration; only the fireball roar and impact. [8–15s, over the shockwave] "The impact unleashed a shockwave that swallowed the continent at the speed of sound." [15–22s, over the eruptions and floods] "Volcanoes erupted in chains. Floods tore through the valleys, devouring their ancient home." [22–26s, over the ash] "And as the ash swallowed the last light of the sun..." [26–27.5s] SILENCE — no narration; the lone Brachiosaurus collapses. [27.5–30s, over the orbital view] "...an age was over. And the universe — never noticed." [P1] Ambient sound follows the visuals: herd calls, river and insect hum in segment one; roaring dust wall and stampede thunder in segment two; eruptions, fire rain hiss and floodwater in segment three; fading to near-total silence in orbit — only the final narration line over stillness. No music. ━━ PHYSICS & SCALE RULES (apply to all segments) ━━ [P0] Animals move with visible weight: ground tremor on footfalls, slow inertia in long necks and tails, momentum carried through turns. Massive distant objects move with slow parallax. [P1] Every frame contains a scale reference smaller than the main subject: ferns, bird-sized pterosaurs, tree canopies, individual boulders. [P2] Skin behavior under motion: loose hide swaying on flanks, muscle groups shifting under weight-bearing legs, nostril condensation in cooler dawn air. ━━ [0–8s] SEGMENT 1: THE LAST GOLDEN HOUR ━━ [P0] Golden-hour Jurassic river valley. Three adult Brachiosaurus of visibly different sizes at staggered depths: the nearest angled three-quarter toward camera feeding on conifer crowns, a second facing away drinking at the river, a juvenile half-hidden behind foreground ferns. NOT identical individuals, NOT evenly spaced, NOT all in side profile. A distant fireball grows in the sky trailing smoke, then a blinding white impact flash on the horizon. [P1] A few Stegosaurus graze in the hazy midground, partially overlapping each other; small pterosaurs circle the tallest neck like gulls around a ship mast. Long warm shadows stretch across the valley floor; river surface carries broken golden reflections. [P2] The nearest Brachiosaurus tears a branch, needles falling; its throat visibly swallows. When the fireball appears, animals lift heads at different moments — not synchronized — nostrils flaring, the juvenile stepping closer to an adult. The impact flash momentarily whites out the right third of frame and throws hard rim-light on every silhouette. ━━ [8–15s] SEGMENT 2: THE SHOCKWAVE ━━ [P0] The camera sits low in the escape path: mixed dinosaur species charge head-on toward and past the lens at different gaits, bodies overlapping, the nearest blurring as they cross frame — NOT side-passing, NOT parallel to camera. Behind them a sonic dust wall fills two-thirds of frame height, advancing with slow massive parallax. [P1] A ring-shaped shockwave visibly flattens the conifer forest row by row before the dust wall; whole trees cartwheel airborne. Ground debris — branches, gravel, torn fronds — streams past the lens. Pterosaurs scatter overhead faster than the ground animals below. [P2] Individual variation inside the stampede: one Stegosaurus stumbles and recovers, a juvenile weaves between adult legs, panicked eye-whites visible on the nearest animal for two frames as it thunders past. The dust wall's leading edge curls and boils, backlit orange by the burning horizon behind it. ━━ [15–22s] SEGMENT 3: PLANETARY FURY ━━ [P0] Chain-erupting volcanoes hurl lava columns and fire rain across the horizon; flash floods and mudflows tear through the valley, sweeping individual Stegosaurus of different sizes at different depths, some facing camera mid-struggle. Creatures occupy under five percent of frame — tiny against planetary-scale forces. [P1] Layered composition: erupting volcano chain in far background, arcing incandescent bombs and fire rain in midground, churning brown floodwater with uprooted trees in foreground. Steam bursts where lava bombs strike water. [P2] The flood carries a torn conifer crown past the lens close enough to defocus; a struggling Stegosaurus grasps footing on a boulder, loses it, is carried around a bend. Ashfall begins as scattered gray flakes drifting into the top of frame. ━━ [22–30s] SEGMENT 4: THE UNIVERSE NEVER NOTICED ━━ [P0] Ash thickens until color drains from orange to monochrome gray. One lone Brachiosaurus, angled three-quarter toward camera, collapses slowly — front legs buckling first, neck settling last, dust billowing on impact. The camera rises vertically through the ash layer into orbit: Earth a dim gray-veiled sphere against a static, silent starfield. Stars do not move, do not twinkle; nothing reacts. [P1] During the ascent the frame passes through seconds of pure featureless gray inside the ash layer, then breaks abruptly into black clarity — the chaos below replaced by absolute stillness. The gray-shrouded Earth occupies the lower third of the final frame, small, off-center. [P2] Ash flakes settle on the fallen animal's back in close view before the ascent begins; its flank rises and falls once, shallowly, then stops. In orbit, thin sunlight grazes the ash shroud's edge — the only warm tone left, fading. ━━ CAMERA PLAN ━━ [P0] Low-angle wide establishing → static low shot facing the oncoming stampede → handheld chaos → slow continuous vertical pull-out to space. [P1] Segment 1 uses slow lateral drift with telephoto compression; Segment 2 stays locked as subjects grow from distant to frame-filling; Segment 3 handheld with impact shake on eruption beats; Segment 4 decelerating rise, easing to full stillness on the final orbital frame. ━━ AVOID ━━ [P0] Avoid: narration text appearing on screen, subtitles, captions, karaoke-style lyrics, text overlays, identical cloned animals, duplicated individuals, uniform spacing, all animals in side profile, cartoon look, meteor reappearing after impact, moving or twinkling stars, background music. [P1] Avoid: over-saturated colors, HDR bloom, glossy plastic skin, video-game render look, perfectly smooth gimbal glide, default slow-motion, over-sharpened detail, synchronized herd movement, humans, buildings, modern objects.
    4

    05. Cambio de estilo — transformación visual y consistencia del personaje

    Texto a video · 30s · 16:9

    Qué hemos probado

    Una bailarina interpreta una rutina continua mientras recorre varios mundos visuales. El video empieza en una calle europea realista y pasa a ciberpunk, cine mudo en blanco y negro, animación 3D y estilos de pintura al óleo.

    Cada transformación cambia el entorno visual y la ropa, mientras la identidad de la bailarina, la coreografía y el ritmo musical deben mantenerse. La secuencia termina con los cuatro mundos alternativos juntos en una composición final.
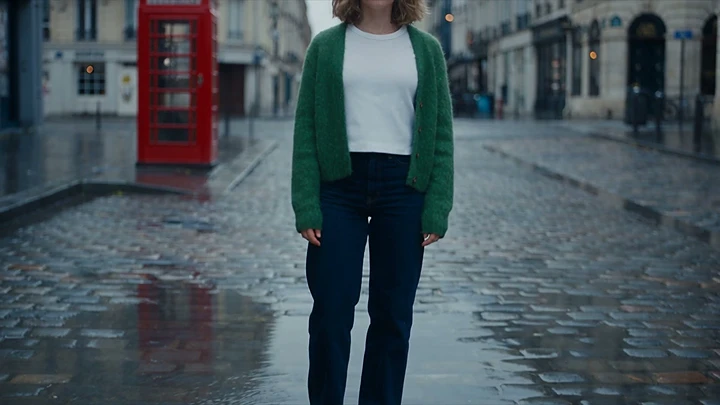
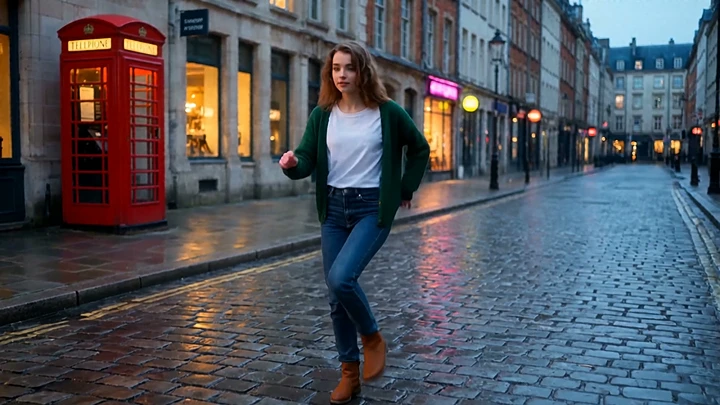
    Salidas de video lado a lado

    Seedance 2.5 — 05. Cambio de estilo — transformación visual y consistencia del personaje
    Seedance 2.5
    Wan 3 — 05. Cambio de estilo — transformación visual y consistencia del personaje
    Wan 3

    Qué comparar

    • Consistencia del personaje: ¿La bailarina sigue siendo reconocible entre estilos artísticos y representaciones distintas?
    • Precisión del estilo: ¿Cada segmento refleja con claridad el estilo visual solicitado, sin mezclas no previstas?
    • Tiempo de las transiciones: ¿Las transformaciones visuales ocurren en los momentos indicados y se alinean con los movimientos previstos?
    • Continuidad del movimiento: ¿La coreografía continúa de forma natural entre mundos visuales distintos?
    • Composición final: ¿El final combina con éxito los cuatro estilos distintos en la composición de varios paneles solicitada?

    Por qué importa esta prueba

    El cambio de estilo exige que el modelo separe la apariencia visual de la identidad del sujeto y del movimiento. El entorno y el tratamiento artístico pueden cambiar mucho, pero el personaje y la acción de fondo tienen que seguir siendo comprensibles.

    Esta prueba explora cómo maneja cada modelo transformaciones coordinadas entre varios estilos visuales dentro de una secuencia creativa continua.

    Nuestro veredicto

    Seedance 2.5 cubre más de los mundos solicitados. Las muestras muestran la calle europea mojada y el cárdigan verde, un atuendo ciberpunk de neón, un fotograma de cine mudo en blanco y negro con bandas, un giro a pintura al óleo estrellada con un vestido azul y, después, el aspecto original rodeado de cuatro paneles separados. Wan 3.0 baila con más claridad en la calle y en las secciones ciberpunk, y su momento de animación 3D con vestido amarillo es una escena completa, no una imagen dentro de un panel. El mundo de cine mudo no aparece en las muestras de Wan, y el final son cuatro imágenes separadas, no un cartel con la bailarina en el centro. Elige Seedance 2.5 cuando la lista de estilos y el final de cuatro mundos sean el objetivo del brief. Elige Wan 3.0 cuando una coreografía legible y el mundo de dibujos importen más que el segmento de cine mudo.

    Ver el prompt completo
    A 30-second creative dance short film, "The Same Dance in Parallel Worlds": one female lead performs a single uninterrupted dance from start to finish; each time the world switches to a new art style, her outfit changes with it, but the choreography flows on seamlessly — one dance traveling through four parallel worlds. The overall feel combines beat-synced outfit-change transitions with cinematic quality; cuts land crisp, movement stays silky. [CHARACTER LOCK] Female lead: European woman in her mid-20s, light-brown shoulder-length curly hair, medium build. Her facial proportions, hairstyle silhouette, and body shape remain 100% consistent through every switch; her outfit is the ONLY element allowed to change, locked per segment as described below. She is a fictional original character and does not resemble any real person. Only this one female lead appears in the entire film — no doubles or copies of her (except her images inside the panes and the poster). 0-5s: Photorealistic cinematic look. Early morning in an old European city street, wet cobblestones reflecting gray-blue daylight, a red telephone box in the blurred background. She wears a green knit cardigan, white T-shirt, and dark-blue jeans, standing mid-street, tapping a toe to the beat, then easing into the dance — swaying side to side, her arm carving the first arc, a spin with her hair swinging out. Medium shot with a slow push-in, subtle handheld feel. 5-9s: On the instant of that hair-swinging spin, the world switches to cyberpunk — a neon pink-purple rainy night, text-free geometric neon tubes flickering in the rain. Her outfit becomes a silver reflective techwear cropped jacket, black tapered pants, and glowing shoe soles; hairstyle unchanged. The choreography picks up the previous arm arc without a seam, shifting into robotic waves and popping hits, raindrops flinging off her movements as beads of light. The camera orbits her in a small arc. 9-12s: A crouch-and-rise move triggers the next switch — the frame becomes a 1930s black-and-white silent film: the entire image fully black-and-white with no color at all, a 4:3 letterboxed frame, film grain and scratches, a slight hand-cranked stutter. Her outfit becomes a 1920s fringe dress; hairstyle unchanged. Riding the momentum of the rise, her steps flow into a fast Charleston kick sequence, fringe flying with every move, as she laughs a big, soundless laugh. Locked-off camera, mimicking a vintage cine camera. 12-16s: A leap-and-land triggers the switch — the world turns into 3D-animated-feature quality: bright saturated colors, soft volumetric light, a rounded storybook town. She becomes a big-eyed cartoon-proportioned version of herself; her outfit becomes a bright-yellow puffy short dress; hairstyle silhouette unchanged. The landing connects seamlessly into light spinning leaps, a little bird circling her, petals lifting with her skirt. The camera rises and rotates playfully. 16-20s: Her skirt sweeping across the foreground triggers the switch — the frame becomes thick post-impressionist oil paint: a night sky of swirling star-and-moon impasto strokes, streetlight halos in stacked gold. Her silhouette is built from oil strokes; her outfit becomes a deep-blue floor-length gown, its hem spreading like flowing brushwork; hairstyle unchanged. The dance opens into grand sweeping arm arcs and continuous turns, every movement trailing colored brushstroke ribbons in the air. The camera slowly pulls back, strokes streaming with her. 20-25s: The camera keeps pulling back; she returns to photorealistic quality and her original green-cardigan look, still turning at the center of a dark void, never stopping. Around her, four glass-like painted panes float in a fixed 2×2 grid, stationary, each pane distinctly different and never repeating, each freezing her signature pose from that world: the top-left pane holds the cyberpunk world — her in the silver techwear jacket frozen on a popping hit, neon pink-purple rainy night behind; the top-right pane holds the black-and-white silent-film world — the entire pane pure black-and-white with no color, her in the fringe dress frozen mid-Charleston-kick, film grain; the bottom-left pane holds the 3D-animation world — the cartoon-proportioned her in the yellow puffy dress frozen mid-spinning-leap, storybook town; the bottom-right pane holds the oil-paint world — her in the deep-blue gown frozen mid-turn with sweeping arms, swirling star-and-moon night sky. She completes two final turns at the center as light from the four panes falls on her from four directions. 25-30s: The four panes converge and merge into her at once; the light contracts as her spin decelerates to a close, and the frame locks into a poster-style composition — the photorealistic her at center in a curtain-call pose: one hand over her heart, the other extended back and outward, a bowing curtsy with head gently lowered, rim light tracing her silhouette. The background behind her is divided by clean cross-shaped split lines into four quadrants: top-left the cyberpunk neon rainy night, top-right the pure black-and-white film-grain street, bottom-left the bright animated storybook town, bottom-right the swirling impasto oil-paint night sky — each quadrant fully holding its own style with crisp boundaries, no bleeding between them. Freeze frame. Sound design: Ambient layer: 0-5s morning street ambience and the tap of her footwork; at every switch the ambience transforms in sync — rain and electric hum for the cyberpunk section, ambience fully stripped to silence for the silent-film section, light birdsong and rustling petals for the animation section, wind for the oil-paint section; through 20-30s it settles into airy reverb with her breathing and the turn of her steps. Music layer: one dance track runs through the entire film with a beat that never stops — only the instrumentation changes per world: a light electronic beat for the realistic opening, synthwave layers joining in the cyberpunk section, the silent-film section snapping instantly to a lone vintage silent-movie piano (beat unchanged), bright orchestration for the animation section, strings swelling through the oil-paint section, building after 20s to the climax, and one clean resolving chord on the curtain-call freeze; every style switch lands precisely on a downbeat. Voice layer: no dialogue, no narration, no voice-over anywhere in the film. [KEY RESTRICTIONS] The female lead is a fictional original character and must not resemble any real celebrity, dancer, or public figure. No brand logos or trademarks may appear; neon lights render only as geometric tube shapes and must not form any text or letters. No clearly legible text or subtitles anywhere in the film; silent-film intertitle cards are expressed only as decorative graphic frames. [NEGATIVE CONSTRAINTS] Facial drift, altered facial structure, or changes to the hairstyle silhouette; the dance breaking, skipping frames, or moves failing to connect across switches; outfits changing mid-segment (outfits change exactly once, at each style-switch instant); duplicated or repeated content across the four panes; any color appearing inside the black-and-white pane; styles bleeding, mixing, or blurring across quadrant boundaries; extra doubles of her appearing outside the panes and poster imagery; deformed or extra fingers; clipping, flickering, ghosting; watermarks, garbled text; abrupt hard cuts without a physical trigger action.
    5

    06. Escena de diálogo — sincronización labial e interacción entre personajes

    Multirreferencia · 3 imágenes · 15s · 16:9

    Qué hemos probado

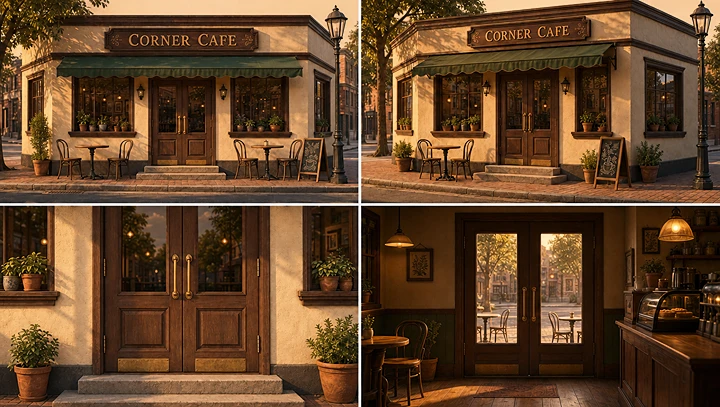
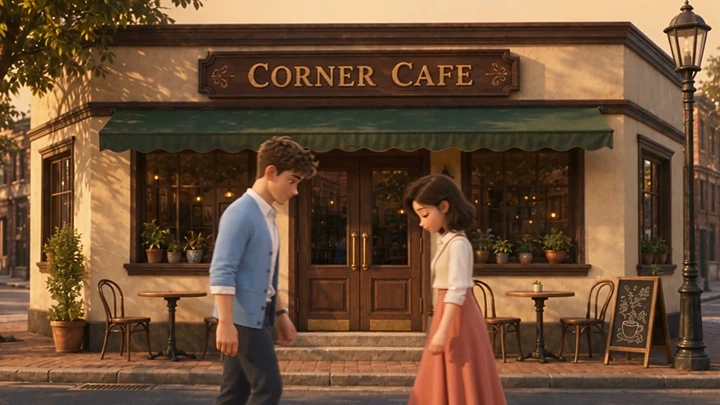
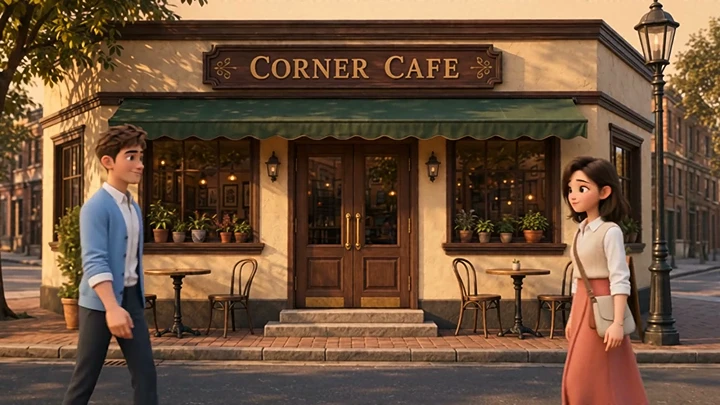
    Dos personajes animados estilizados, HAORAN y XIAOYU, se encuentran por sorpresa fuera de un café, intercambian cuatro líneas de diálogo en inglés y entran juntos al edificio.

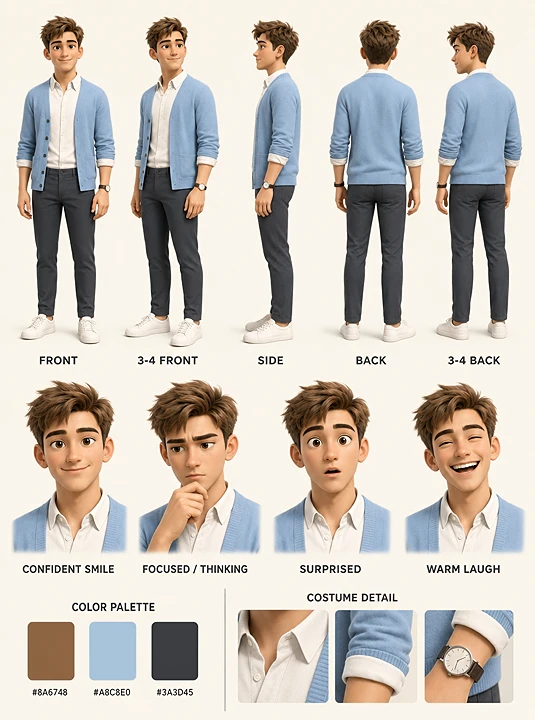
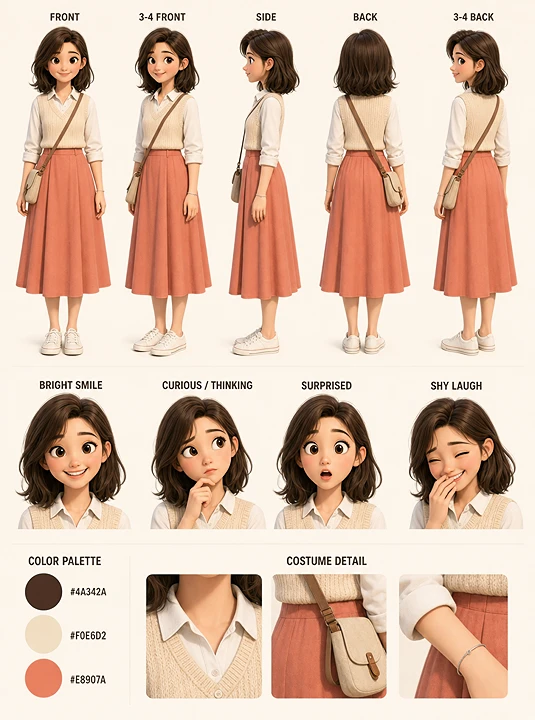
    Tres imágenes de referencia definen a los personajes y el entorno del café. El prompt exige diálogo preciso, expresiones faciales naturales, diseños de personaje consistentes y una acción concreta de abrir la puerta.
    Salidas de video lado a lado

    Seedance 2.5 — 06. Escena de diálogo — sincronización labial e interacción entre personajes
    Seedance 2.5
    Wan 3 — 06. Escena de diálogo — sincronización labial e interacción entre personajes
    Wan 3

    Qué comparar

    • Precisión del diálogo: ¿Las líneas indicadas se pronuncian bien, en el orden previsto y por los personajes correctos?
    • Sincronización labial: ¿Los movimientos de la boca corresponden de forma natural al habla generada?
    • Consistencia de los personajes: ¿HAORAN y XIAOYU conservan los rasgos faciales, la ropa y el estilo de animación de la referencia?
    • Interpretación facial: ¿Las expresiones y los gestos coinciden con el contexto emocional de la conversación?
    • Precisión de la acción: ¿HAORAN abre hacia fuera la puerta correcta y deja que XIAOYU entre primero, como se indica?

    Por qué importa esta prueba

    Las escenas de diálogo reúnen varias tareas exigentes: generación de habla, sincronización labial, consistencia de los personajes, interpretación emocional e interacción física coordinada.

    Un resultado convincente depende de que estos elementos funcionen juntos. Esta prueba ayuda a evaluar con qué eficacia maneja cada modelo un relato impulsado por personajes.

    Nuestro veredicto

    Ambos clips conservan los diseños de referencia: el cárdigan azul, el chaleco crema, la falda salmón y el toldo de Corner Cafe. Las bocas están abiertas durante la conversación, pero los fotogramas fijos no pueden confirmar las cuatro líneas ni una sincronización labial real. La puerta es la diferencia visible. El último fotograma de Wan 3.0 lo muestra sosteniendo el tirador de latón mientras ella cruza el vano abierto. Seedance 2.5 lleva a la pareja hasta la entrada y al interior, sin un momento claro en el que la puerta se sostenga abierta hacia fuera. Elige Wan 3.0 para este brief cuando la acción de la entrada tenga que coincidir con el prompt. Cualquiera de los dos modelos sirve cuando la prioridad es mantener consistentes a los dos personajes y al café; escucha las líneas antes de cerrar una toma.
    Ver el prompt completo y las referencias

    Recursos de referencia

    Ref. de imagen 1 — personaje de HAORAN
    Ref. de imagen 1 — personaje de HAORAN
    Ref. de imagen 2 — personaje de XIAOYU
    Ref. de imagen 2 — personaje de XIAOYU
    Ref. de imagen 3 — entorno del café
    Ref. de imagen 3 — entorno del café
    Pixar-style 3D animation, style locked to <<<Image3>>> , <<<Image1>>> and <<<Image2>>> — render everything exactly in their look. HAORAN, the young man from <<<Image1>>> , and XIAOYU, the young woman from <<<Image2>>> , run into each other on the sidewalk in front of the café from <<<Image3>>> , both breaking into surprised, warm smiles. XIAOYU says: "Haoran? What a coincidence!" He laughs: "First time seeing you since graduation!" She replies: "Come on in, coffee's on me." He answers: "Let's go." They walk up the steps together; HAORAN pulls the right door leaf outward by its brass handle — hinges on the outer edge — and holds it open as XIAOYU steps inside, then follows her in as the door swings shut behind them. Soft rounded stylized character proportions, subsurface scattering on skin, large expressive animated eyes, warm golden-hour cinematic lighting, gentle squash-and-stretch motion. The camera tracks them from across the street with a slow push-in. Dialogue in English with accurate lip sync, no subtitles. Avoid photorealistic faces, live-action look, 2D cel-shaded style, any style shift mid-clip, doors opening inward, sliding doors, or extra background characters entering frame.
    6

    07. Actuación de conjunto — coordinación entre varios personajes e interacción con objetos

    Texto a video · 15s · 16:9

    Qué hemos probado

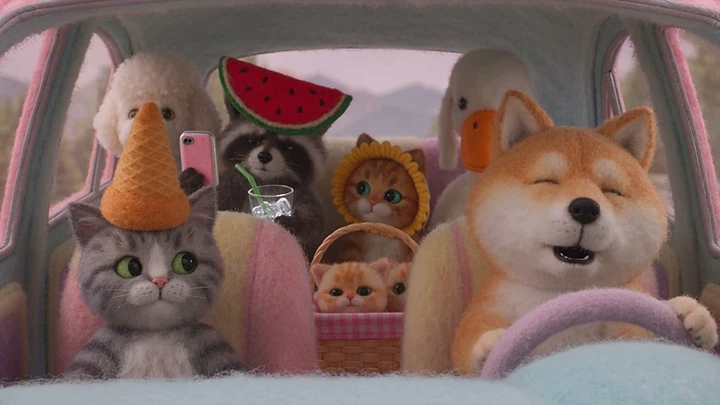
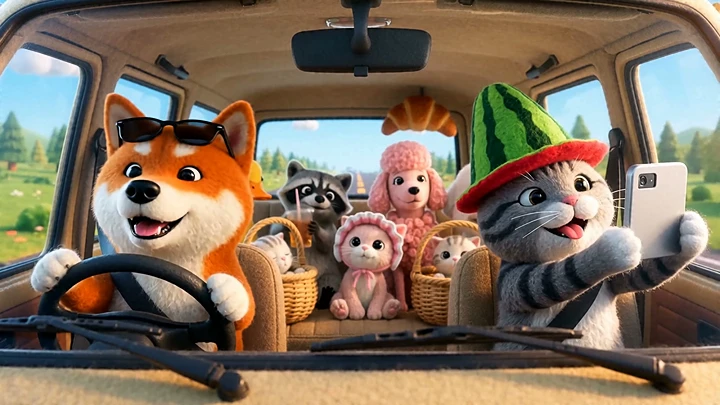
    Un grupo de personajes animales expresivos, de estilo peluche, hace un viaje en carretera caótico. Dentro del vehículo en movimiento, cada personaje realiza una acción distinta mientras eventos inesperados encadenan reacciones cómicas.

    La escena incluye un Shiba Inu conductor que canta, un gato que se hace un selfie, un pato que se cuela en la foto, sombreros que cambian de sitio, pasajeros que rebotan, objetos que vuelan y reacciones de grupo coordinadas.

    El prompt pide un ángulo de cámara fijo y un render de fieltro tipo peluche consistente durante toda la secuencia de 15 segundos.
    Salidas de video lado a lado

    Seedance 2.5 — 07. Actuación de conjunto — coordinación entre varios personajes e interacción con objetos
    Seedance 2.5
    Wan 3 — 07. Actuación de conjunto — coordinación entre varios personajes e interacción con objetos
    Wan 3

    Qué comparar

    • Reconocimiento de personajes: ¿Cada animal sigue siendo visualmente distinto y reconocible durante toda la escena?
    • Acciones individuales: ¿Los personajes realizan las acciones asignadas, en lugar de repetir movimientos idénticos?
    • Interacción con objetos: ¿Los sombreros, las bebidas, las uvas y otros objetos pasan entre personajes de la forma prevista?
    • Continuidad de causa y efecto: ¿Los giros y los baches del vehículo provocan reacciones coherentes en todo el grupo?
    • Consistencia de la escena: ¿El modelo mantiene la posición fija de la cámara, la disposición de los personajes y el estilo visual de fieltro tipo peluche?

    Por qué importa esta prueba

    La actuación con varios personajes pone a prueba la capacidad del modelo para gestionar varias acciones independientes dentro de un entorno compartido.

    El reto no es solo generar muchos personajes a la vez, sino conservar sus identidades, coordinar sus interacciones y mantener relaciones lógicas de causa y efecto en la escena.

    Nuestro veredicto

    Seedance 2.5 mantiene el interior bloqueado. La misma vista del parabrisas sostiene al shiba al volante con la boca abierta, al gato con sombrero de sandía y al pato. El cuello del pato avanza, pero el intercambio de sombreros, la captura de la uva y el pulgar hacia arriba final no se ven. Wan 3.0 muestra más de esos gags: un cruasán sobre una cabeza, el caniche pegado al perro blanco, un gatito gruñón en la cesta y un pulgar hacia arriba del conductor. La cámara también abandona el ángulo bloqueado: corta de la cabina completa al asiento trasero y al interior de la cesta, y los sombreros y los asientos se reordenan. Elige Seedance 2.5 cuando importen una cámara fija y un reparto estable. Elige Wan 3.0 cuando la cadena de reacciones cómicas importe más que un solo ángulo sin interrupciones.

    Ver el prompt completo
    Hyper-realistic wool-felt plush texture, cottagecore pastel palette, matching the reference image exactly. Fixed camera locked at this exact interior angle, no cuts, no camera movement. A hilarious and heartwarming 15-second road trip scene bursting with individual personality. [0-4s] The shiba inu driver is having the time of her life — head bobbing to music, singing loudly with mouth wide open, one paw drumming the steering wheel. The watermelon-hat cat films a selfie video, the duck photobombs by suddenly stretching its neck into frame with a loud honk, the cat rolls its eyes dramatically. The raccoon shakes its iced drink like a cocktail, ice cubes rattling. [4-8s] Sharp left turn! A comedic chain reaction: the croissant hat slides off the grey cat's head and lands on the bonnet kitten's face, covering its eyes — the kitten flails its tiny paws in confusion. The poodle slides across the back seat and squishes the bichon against the window, both bursting into laughter. The duck slides sideways with a deadpan expression, completely unbothered, like it has seen everything. [8-12s] Bumpy road! Everything bounces — a grape pops out of the picnic basket, flies through the air, and the raccoon catches it in its mouth mid-bounce, looking extremely proud of itself. One kitten in the pink basket gets bounced awake, grumpily grabs the edge of the basket, gives everyone an annoyed squint, then dramatically flops back down into the basket. The goldfish leaps out of the sloshing water and splashes back in. [12-15s] The road smooths out into warm golden light. All animals perk up, bright-eyed and alert, turning toward the camera with big open-eyed smiles — the shiba driver glances back with a wide grin and a thumbs-up paw, eyes sparkling; the croissant cat retrieves its hat, puts it on backwards without noticing, and blinks curiously at the camera; the bonnet kitten hiccups a tiny flower petal and giggles with wide shining eyes. Everyone stays awake, lively and energetic, eyes wide open, looking around cheerfully as sunset light glows on their fur. Every animal has exaggerated theatrical acting with natural fur physics — wide eyes, flattened ears, wagging tails, puffed cheeks, dramatic reactions, while rendering stays fully realistic plush-felt style throughout. All characters keep their eyes open and alert throughout, except the basket kittens. Blurred mountain scenery streams past the windows, tree shadows flicker across the interior.
    7

    08. Baile grupal y sincronía con el ritmo — coreografía y sincronización musical

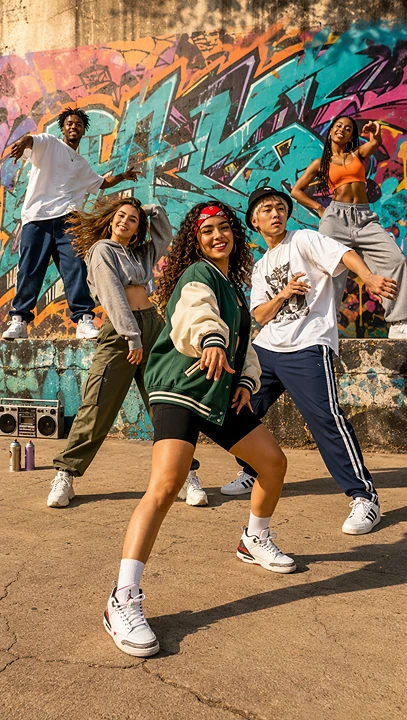
    Multirreferencia · 1 imagen + audio · 15s · 9:16

    Qué hemos probado

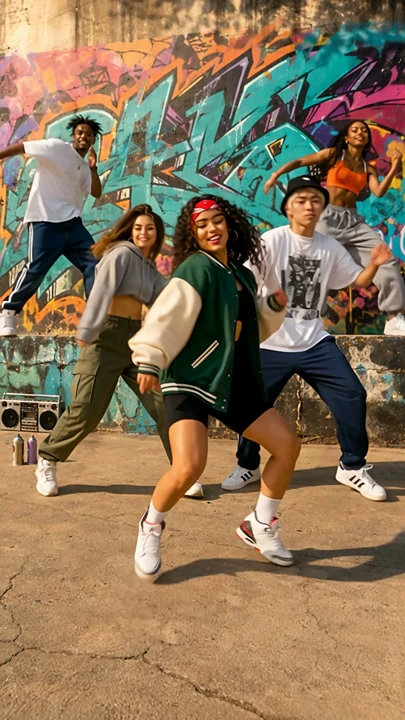
    Cinco bailarines interpretan una rutina coordinada de baile callejero en una plaza cubierta de grafitis, con una imagen de referencia para definir su apariencia y una referencia de audio para orientar la coreografía.

    La rutina empieza en formación de V y pasa a una línea horizontal. El prompt exige que los cinco bailarines conserven su identidad, completen el cambio de formación y sincronicen sus movimientos con la música original en un solo plano continuo.
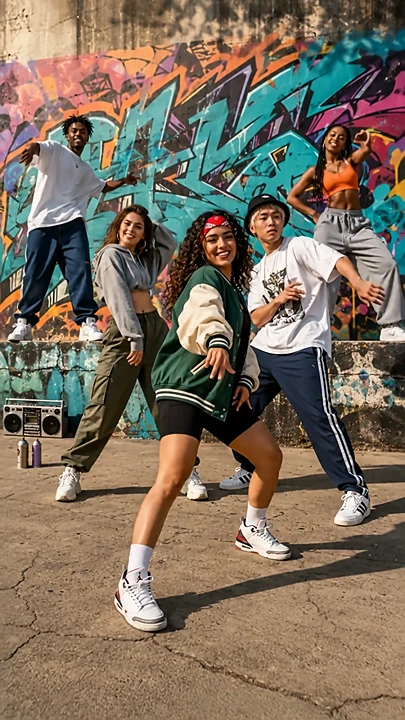
    Salidas de video lado a lado

    Seedance 2.5 — 08. Baile grupal y sincronía con el ritmo — coreografía y sincronización musical
    Seedance 2.5
    Wan 3 — 08. Baile grupal y sincronía con el ritmo — coreografía y sincronización musical
    Wan 3

    Qué comparar

    • Sincronización con el ritmo: ¿Los movimientos de los bailarines se alinean con el tiempo y el ritmo del audio de referencia?
    • Precisión de la formación: ¿El grupo pasa con éxito de la formación en V inicial a la línea horizontal solicitada?
    • Consistencia de los bailarines: ¿Los cinco bailarines conservan rostros, peinados y ropa reconocibles?
    • Coordinación del movimiento: ¿Los movimientos individuales siguen siendo naturales y están sincronizados en todo el grupo?
    • Conservación del audio: ¿El video generado conserva el audio original, sin música de reemplazo inesperada ni efectos de sonido añadidos?

    Por qué importa esta prueba

    La generación de baile exige una coordinación precisa entre el movimiento visual, la identidad de los personajes, la posición del grupo y el tiempo del audio.

    Una secuencia de baile atractiva puede fallar igualmente si los intérpretes pierden la sincronización o si la formación cambia de forma incorrecta. Esta prueba examina si cada modelo puede coordinar varios sujetos con una referencia musical externa.

    Nuestro veredicto

    Wan 3.0 abre más cerca de la foto de referencia: cinco bailarines, la chaqueta varsity verde delante y una postura parecida a la V contra el muro de grafitis. A mitad, ese grupo desaparece y un solo bailarín llena la plaza, antes de que un fotograma posterior vuelva con un grupo más suelto. Seedance 2.5 mantiene un grupo en cada muestra, incluida la chaqueta verde, pero los fotogramas posteriores añaden personas y no muestran un cambio limpio de la V inicial a una sola línea horizontal de los mismos cinco. Las imágenes fijas no pueden confirmar que alguno de los clips se mantenga en el ritmo original o deje el audio intacto. Elige Seedance 2.5 cuando todos los bailarines tengan que permanecer en cuadro. Elige Wan 3.0 cuando el primer plano tenga que coincidir con la referencia, y mira el centro del clip antes de aceptar el cambio de formación.
    Ver el prompt completo y las referencias

    Recursos de referencia

    Ref. de imagen 1 — cinco bailarines y formación inicial
    Ref. de imagen 1 — cinco bailarines y formación inicial
    Ref. de audio — pista de ritmo original
    The five dancers from <<<Image1>>> , keeping each dancer's exact face, hairstyle and outfit, perform street dance in the graffiti plaza, choreographed to the music in <<<Audio1>>> , every move landing on the beat. Formation change is required: starting in the V-formation from <<<Image1>>> , midway through the clip all five dancers travel to new positions — the center dancer moves to the back as the other four sweep forward into one horizontal line, finishing the routine in this new formation. Camera movement mirrors the music's rhythm and energy. Continuous single take. Use the ORIGINAL audio from <<<Audio1>>> unchanged; audio reference only, not visual reference. Avoid generated music, added sound effects, cuts, face distortion, identity swapping, subtitles, dancers standing in place for the whole clip.
    8

    09. Adaptación literaria — precisión narrativa y consistencia de cuento ilustrado

    Texto a video · 15s · 16:9

    Qué hemos probado

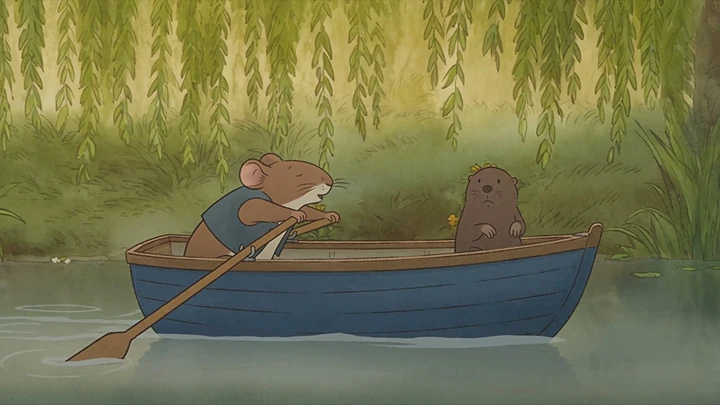
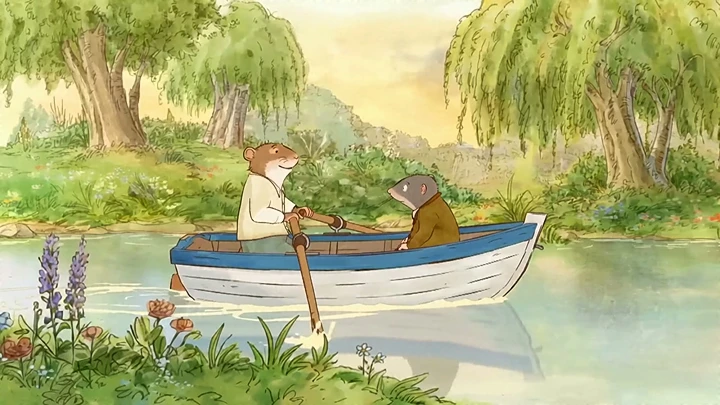
    Una escena breve de The Wind in the Willows, de Kenneth Grahame, se adapta a una animación en estilo de acuarela eduardiana.

    Una rata de agua rema en un bote azul y blanco por un río tranquilo mientras un topo se sienta en la popa. Cuando la rata se absorbe en la conversación, el bote choca contra la orilla y el remero cae hacia atrás antes de recuperarse.

    La prueba pide a ambos modelos que reproduzcan una secuencia literaria concreta y mantengan los roles de los personajes, las acciones físicas y una apariencia ilustrada consistente.
    Salidas de video lado a lado

    Seedance 2.5 — 09. Adaptación literaria — precisión narrativa y consistencia de cuento ilustrado
    Seedance 2.5
    Wan 3 — 09. Adaptación literaria — precisión narrativa y consistencia de cuento ilustrado
    Wan 3

    Qué comparar

    • Precisión narrativa: ¿La salida sigue la secuencia descrita en el pasaje original?
    • Roles de los personajes: ¿La rata rema el bote mientras el topo permanece en la posición indicada?
    • Continuidad de la acción: ¿El bote choca contra la orilla y produce la reacción física prevista?
    • Estilo visual: ¿El video mantiene la estética de acuarela eduardiana solicitada de principio a fin?
    • Consistencia de la escena: ¿El bote, la orilla, los personajes y el entorno siguen siendo visualmente coherentes?

    Por qué importa esta prueba

    La adaptación literaria exige que el modelo traduzca un relato escrito a una secuencia visual clara.

    El reto no es solo producir imágenes atractivas de cuento. El resultado debe conservar los roles de los personajes, las relaciones de causa y efecto y los eventos esenciales que hacen reconocible la escena original.

    Esta prueba ayuda a evaluar con qué fidelidad convierte cada modelo un pasaje literario detallado en un video corto.

    Nuestro veredicto

    Seedance 2.5 sigue el pasaje más lejos. La rata rema mientras el topo se sienta en la popa; después la rata queda boca arriba con los pies en el aire y luego vuelve a sentarse. El bote se lee como azul uniforme, y no azul por fuera y blanco por dentro, y el golpe de la proa contra la orilla queda implícito en la caída, no se muestra. Wan 3.0 coincide mejor con el bote —azul por fuera, blanco por dentro— y sostiene una acuarela eduardiana más estable mientras reman bajo los sauces. Sus fotogramas finales inclinan el bote hacia las flores y después vuelven al remo en calma, así que faltan la caída con los talones en el aire y la recuperación. Elige Seedance 2.5 cuando el choque y la caída tengan que leerse. Elige Wan 3.0 cuando el bote pintado y el río tranquilo importen más que el remate.

    Ver el prompt completo y el pasaje original
    A fifteen-second continuous shot, Edwardian pastoral watercolor style, soft riverside light. A water rat sculls a small rowing boat, painted blue outside and white within, along a gentle river, with a mole seated in the stern, exactly as the original text describes: "Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)
    "Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)

    Fuente original: Kenneth Grahame, The Wind in the Willows (1908), capítulo I. Texto de dominio público disponible en Project Gutenberg.

    9

    Estas nueve comparaciones lado a lado muestran cómo responden Seedance 2.5 y Wan 3 a briefs creativos concretos. Los resultados pueden variar entre generaciones, ajustes y referencias de entrada. Los veredictos comparativos deben basarse en las salidas mostradas y en los criterios de evaluación documentados.

    Cómo evaluamos la comparativa de Seedance 2.5 y Wan 3.0

    Nuestro enfoque de evaluación se centra en si cada salida resuelve la tarea creativa original.

    Briefs creativos equivalentes

    Cada comparación usa el mismo prompt previsto y los mismos recursos de origen. Si un ajuste no está disponible en un modelo, esa diferencia debe documentarse, y no tratarse como una condición de prueba idéntica.

    Ajuste al prompt

    Comprobamos si los sujetos, las acciones, el orden de las escenas y los finales solicitados aparecen en la salida. La ausencia de eventos clave cuenta como limitación aunque el video se vea pulido.

    Consistencia con la referencia

    En los casos guiados por imagen, comparamos personajes, productos, ropa, objetos y lugares con su material de origen. Una reproducción más precisa no equivale necesariamente a un estilo más atractivo.

    Continuidad de movimiento y de historia

    Revisamos recorridos de cámara, movimiento del cuerpo, interacciones con objetos y la relación entre planos sucesivos.

    Buscamos deriva de identidad, reinicios bruscos y relaciones espaciales inconsistentes.

    Diálogo, música y sonido

    En los casos guiados por audio, comprobamos las palabras habladas, a quién se atribuyen, la sincronización labial, las señales sonoras y la alineación con el ritmo cuando los archivos de origen relevantes están disponibles.

    Fiabilidad de la generación

    Una comparación fiable del rendimiento exige registros de envío de cada intento, incluidas las generaciones fallidas, los reintentos y los rechazos de moderación.

    Cómo se seleccionan los clips

    Nuestro benchmark previsto usa tres generaciones por modelo en tareas más simples y cinco generaciones por modelo en tareas más complejas, con un total de 74 intentos de generación entre ambos modelos.

    Cada video completado se evalúa de forma independiente con una rúbrica de puntuación definida de antemano.

    Para evitar quedarse solo con los resultados visualmente más atractivos, la salida representativa del benchmark se elige por su proximidad a la puntuación mediana de calidad en evaluación ciega de ese modelo y ese escenario.

    Cómo interpretar los resultados

    Modelos distintos pueden interpretar de forma distinta unas instrucciones idénticas.

    Una salida puede destacar en composición mientras otra conserva mejor un personaje o una acción. El mejor modelo para un proyecto es el que cumple el estándar de calidad exigido a un costo aceptable.

    ¿Cuánto cuesta generar en esta comparativa?

    Compara los mismos ajustes de salida, no solo la tarifa anunciada más baja.

    Ambos modelos usan créditos de Topview, pero el cargo real depende de la variante del modelo, el flujo de trabajo, la duración, la resolución y el plan de la cuenta.

    La cotización de créditos del generador antes del envío es la cifra más relevante para tu proyecto.

    Referencias de precio

    ResoluciónSeedance 2.5 en TopviewWan 3.0 en Topview
    480p0.70 créditos/seg0.30 créditos/seg
    720p1.50 créditos/seg0.50 créditos/seg
    1080p3.70 créditos/seg1.00 créditos/seg

    Por qué la generación más barata no siempre es el proyecto más barato

    Si una salida necesita varios intentos antes de ser utilizable, el costo real de producción incluye esos intentos.

    Compara el total de créditos consumidos, la calidad de la salida y la cantidad de resultados aceptables, no solo el precio por segundo anunciado.

    Profundiza en cada modelo de la comparativa

    Generador de video AI Seedance 2.5

    Explora referencias multimodales, ajustes de video disponibles, ejemplos y flujos creativos más largos.

    Explorar Seedance 2.5

    Generador de video AI Wan 3.0

    Revisa los modos de generación de Wan 3.0, las referencias compatibles y los ajustes disponibles en Topview.

    Explorar Wan 3.0

    API de Seedance 2.5

    Llama a Seedance 2.5 desde la REST API de Topview cuando un producto necesita generación de video en su propio flujo de trabajo. Envía tareas de texto a video, de imagen a video o con referencias, y consulta el trabajo asíncrono hasta que el clip esté listo. La página de la API indica las tarifas por segundo de Business en 480p, 720p y 1080p.

    Abrir la API de Seedance 2.5

    API de Wan 3.0

    Llama a Wan 3.0 desde la REST API de Topview cuando el costo de generación y una tarifa por segundo publicada importan en tu propio producto. Envía tareas de texto a video o de imagen a video, añade entradas de referencia cuando el modo en vivo las acepte y consulta el trabajo asíncrono para obtener el resultado.

    Abrir la API de Wan 3.0

    Seedance 2.5 vs Seedance 2.0

    Compara dos versiones de Seedance, sus flujos de trabajo y los ejemplos lado a lado que ya existen.

    Comparar versiones de Seedance

    Cómo usar Seedance 2.5

    Sigue un tutorial pensado para quien empieza: elegir un modo de generación, escribir prompts y generar un video.

    Leer el tutorial

    Seedance 2.5 vs MiniMax H3

    Compara duración, resolución, referencias y audio nativo, y genera con cualquiera de los dos modelos en Topview.

    Comparar Seedance 2.5 y MiniMax H3

    Wan 3.0 vs MiniMax H3

    Compara duración, resolución, referencias y audio, y genera con cualquiera de los dos modelos en Topview.

    Comparar Wan 3.0 y MiniMax H3

    Preguntas frecuentes de la comparativa

    La diferencia principal en Topview está en el énfasis del flujo de trabajo. El flujo indicado de Seedance 2.5 admite un conjunto combinado de referencias más amplio e instrucciones de temporización detalladas. Wan 3.0 admite generación multimodal y tiene tarifas de referencia publicadas más bajas en tablas de precio seleccionadas. Ninguno es automáticamente mejor para todos los prompts.

    No para todas las tareas. Seedance 2.5 puede ser un mejor punto de partida para proyectos con muchas referencias o con una dirección muy precisa. Wan 3.0 puede merecer una prueba cuando tu brief encaje con sus entradas disponibles y el costo de generación sea importante. Compara salidas en condiciones equivalentes antes de elegir.

    Ambos admiten generación de video de hasta 30 segundos en sus flujos de trabajo documentados. Las duraciones disponibles pueden variar según el modo o la cuenta. Consulta el generador antes de planear una entrega en la que el tiempo sea crítico.

    La comparativa publicada de Topview indica 480p, 720p y 1080p tanto para Seedance 2.5 como para Wan 3.0. Las exportaciones de mayor resolución hechas con servicios externos de escalado no deben confundirse con los ajustes de generación nativos.

    La comparativa de Topview indica ahora hasta 50 referencias combinadas para Seedance 2.5 y hasta 20 para Wan 3.0, con límites separados para imagen, video y audio. Son ajustes propios de cada flujo de trabajo. Confirma los límites en el generador que elijas.

    Ambos tienen flujos de trabajo documentados con capacidad de audio. Las opciones de sonido reales dependen del modelo, del modo y de los ajustes de la cuenta. Revisa el diálogo, los efectos de sonido y la sincronización en el resultado generado.

    Las tablas de referencia publicadas de Topview muestran tarifas por segundo más bajas para Wan 3.0 Prime I2V/T2V que los ejemplos indicados de Seedance 2.5 Business en 480p, 720p y 1080p. Sin embargo, estas tablas tienen condiciones distintas de plan y de flujo de trabajo. Compara siempre las cotizaciones de créditos en vivo para el mismo video solicitado.

    Alibaba Cloud incluye entradas de archivo y de enlace entre las capacidades del modelo Wan 3.0. Eso no significa que todos los flujos de trabajo de Topview acepten documentos o páginas web. Confirma las opciones de entrada en el generador que elijas antes de depender de ellas.

    Son ejemplos lado a lado que ya existen y muestran cómo ambos modelos manejan briefs creativos concretos. Sin registros de generación completos, no deben tratarse como clasificaciones estadísticamente representativas. Las conclusiones de un benchmark controlado exigen ejecuciones de prueba documentadas, ajustes equivalentes, reglas de selección y evaluaciones.

    Topview da acceso a modelos de video AI compatibles dentro de su plataforma de creación. Abre el generador correspondiente, confirma el modelo seleccionado y revisa los ajustes y los créditos disponibles antes de generar.

    Las cuentas que cumplan los requisitos pueden recibir créditos de prueba, pero el acceso gratuito no significa generación ilimitada. Los ajustes de prueba disponibles, el acceso a modelos, las opciones de exportación y los requisitos de créditos se muestran en el flujo de trabajo actual de Topview.

    Seedance 2.5 · Wan 3.0

    Abre el modelo de la comparativa que encaja con tu brief

    Un mejor video AI empieza con el modelo adecuado para el trabajo.

    Elige Seedance 2.5 para una dirección con muchas referencias y un control creativo detallado, o explora Wan 3.0 cuando tu brief encaje con sus entradas disponibles y quieras comparar costos de generación.

    Mantén el mismo prompt y las mismas referencias, revisa las salidas y elige según el resultado, no solo por el nombre del modelo.

    Probar Seedance 2.5

    Los nombres de modelos y marcas de terceros son marcas comerciales de sus respectivos propietarios. Topview ofrece acceso a modelos AI compatibles a través de su plataforma independiente y no es el desarrollador de esos modelos de terceros.