Seedance 2.5
Clip fino a 30 secondi, fino a 50 riferimenti combinati nel flusso Topview indicato e direzione dettagliata di inquadratura e audio.
Quale modello video AI scegliere?
Sia Seedance 2.5 sia Wan 3.0 supportano flussi video AI fino a 30 secondi, con opzioni di output fino a 1080p nei flussi Topview supportati.
La scelta pratica dipende dal tuo brief: Seedance 2.5 merita di essere considerato per produzioni ricche di riferimenti e istruzioni di timing dettagliate; Wan 3.0 merita di essere considerato quando la priorità è il costo di generazione al secondo.
Confronta le impostazioni supportate, i video affiancati già disponibili e i compromessi specifici di ciascun modello prima di generare.
Seedance 2.5
Clip fino a 30 secondi, fino a 50 riferimenti combinati nel flusso Topview indicato e direzione dettagliata di inquadratura e audio.
Wan 3.0
Clip fino a 30 secondi, fino a 20 riferimenti combinati nel confronto Topview indicato e tariffe di riferimento al secondo pubblicate più basse per alcune modalità di generazione.
Limiti e prezzi dipendono dalla modalità, dall'account e dalle impostazioni di generazione selezionate. Controlla sempre il generatore live prima di inviare un'attività.
Entrambi i modelli uniscono generazione video e direzione multimodale. La tabella distingue la documentazione a livello di modello dalle impostazioni indicate per il flusso Topview.
| Dimensione | Seedance 2.5 | Wan 3.0 |
|---|---|---|
| Sviluppatore | ByteDance | Alibaba |
| Caso d'uso principale | Brief creativi più lunghi e ricchi di riferimenti | Creazione multimodale con attenzione al costo di generazione |
| Durata | 4s–30s, selezionabile al secondo | 2s–30s, selezionabile al secondo |
| Risoluzione | 480p / 720p / 1080p | 480p / 720p / 1080p |
| Proporzioni | 16:9, 9:16, 3:4, 1:1, 4:3, 21:9 (più adattivo) | 16:9, 9:16, 1:1, 4:3, 3:4 |
| Da testo a video | Supportato | Supportato |
| Da immagine a video | Supportato | Supportato |
| Guida video e audio | Supportata nei flussi compatibili | Supportata nei flussi compatibili |
| Riferimenti immagine | Fino a 30 | Fino a 10 |
| Riferimenti video | Fino a 10 | Fino a 5 |
| Riferimenti audio | Fino a 10 | Fino a 5 |
| Riferimenti combinati | Fino a 50 | Fino a 20 |
| Generazione audio | Disponibile nei flussi supportati | Disponibile nei flussi supportati |
| Timing e direzione della scena | Istruzioni con codice temporale e selezione della durata al secondo | Indicazioni di inquadratura e scena, in base al flusso |
| Prezzi | I crediti variano per risoluzione, durata, modalità e piano Es. 1.5 crediti/s a 720p | I crediti variano per risoluzione, durata, modalità e piano Es. 0.5 crediti/s a 720p |
| Ideale per | Storytelling ricco di riferimenti e direzione creativa dettagliata | Generazione attenta ai costi e brief creativi mirati |
I limiti dei riferimenti riflettono le impostazioni attualmente indicate nel confronto di Topview, non una garanzia valida per ogni fornitore o account. Controlla il generatore per le impostazioni disponibili. I prezzi dei piani sono sulla .
Parti dal tipo di video che ti serve, non dal nome del modello. Queste indicazioni riguardano l'adattamento al flusso di lavoro, non l'affermazione che un modello produca sempre video più belli.
Seedance 2.5 e Wan 3 supportano entrambi la generazione di video AI fino a 30 secondi, ma offrono vantaggi diversi. Scegli Seedance 2.5 per progetti ricchi di riferimenti, timing preciso e direzione audio dettagliata. Valuta Wan 3 per una produzione attenta ai costi, storytelling in un'unica ripresa più lunga e creazione di scene guidata dai riferimenti.
Riunisci brief creativi complessi con fino a 50 asset di riferimento: 30 immagini, 10 video e 10 file audio. Guida identità del personaggio, dettagli del prodotto, movimento, ambienti e suono in un unico flusso di generazione. Wan 3 supporta solo 20 riferimenti.
Usa video e file audio di riferimento fino a 30.2 secondi ciascuno, nei limiti di durata combinata del flusso. Guida movimento, ritmo e suono con riprese di movimento più lunghe o riferimenti musicali.
Scegli una durata da 4 a 30 secondi, con incrementi di un secondo. Usa istruzioni con codice temporale per pianificare inquadrature, azioni, transizioni e ritmo della scena in un video continuo.
Dirigi dialoghi, musica di sottofondo ed effetti sonori con istruzioni a codice temporale. Coordina parlato, azione e atmosfera con la generazione audio nativa in un unico flusso.
Wan 3.0 indica 0.30 crediti/sec a 480p, 0.50 a 720p e 1.00 a 1080p, a fronte di 0.70, 1.50 e 3.70 crediti/sec per Seedance 2.5 nel listino di riferimento pubblicato da Topview. Controlla il preventivo crediti reale prima di generare: le tariffe dipendono dal flusso e dal piano selezionati.
Crea una sequenza video continua fino a 30 secondi senza unire più clip brevi. Adatta a reveal di prodotto, movimenti di camera ininterrotti e storie di brand che funzionano meglio in un'unica ripresa fluida.
Usa Omni Reference per guidare identità dei personaggi, oggetti di scena e ambienti lungo una narrazione più lunga. Tieni il mondo creativo ancorato ai riferimenti visivi mentre sviluppi scene e azioni.
Usa la ricerca di riferimenti assistita da internet per supportare la creazione video con materiale visivo e contestuale aggiuntivo, dove questa funzione è disponibile nel tuo flusso Topview.
Stesso brief creativo. Due modelli video AI. Nove scenari reali.
Come si confrontano Seedance 2.5 e Wan 3 con le stesse istruzioni creative? Esplora nove test video affiancati su VFX cinematografici, azione complessa, riferimenti multimodali, storytelling documentario, cambi di stile, dialoghi, interazioni tra personaggi, sincronizzazione della danza e adattamento letterario.
Ogni confronto presenta gli output di entrambi i modelli insieme al prompt originale e agli asset di riferimento, quando presenti. Guarda come ciascun modello affronta la stessa sfida creativa, esamina i dettagli che contano e valuta quale modello si adatta meglio a ogni tipo di progetto.
Da testo a video · 30s · 16:9
Un dio norreno resta sospeso sopra un santuario di ossidiana fratturato, mentre fulmini dorati, detriti fluttuanti e rune luminose costruiscono un climax esplosivo. La camera esegue un'orbita continua di 360 gradi mentre il personaggio evoca un enorme martello da battaglia e rilascia una potente onda d'urto.
Questo test chiede a entrambi i modelli di combinare effetti visivi complessi, movimento del personaggio, direzione dinamica della camera e una sequenza d'azione continua in un unico video di 30 secondi.
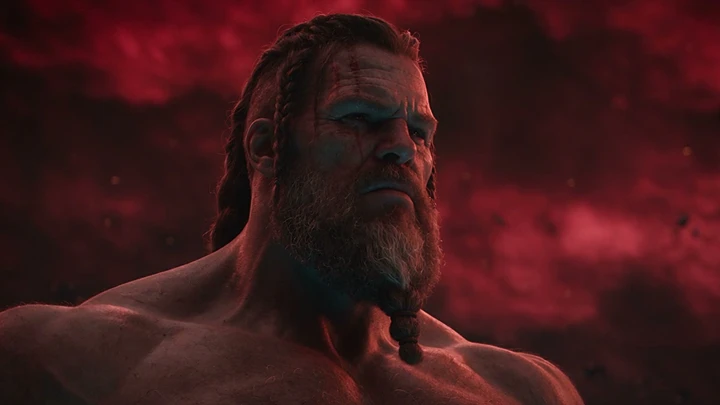
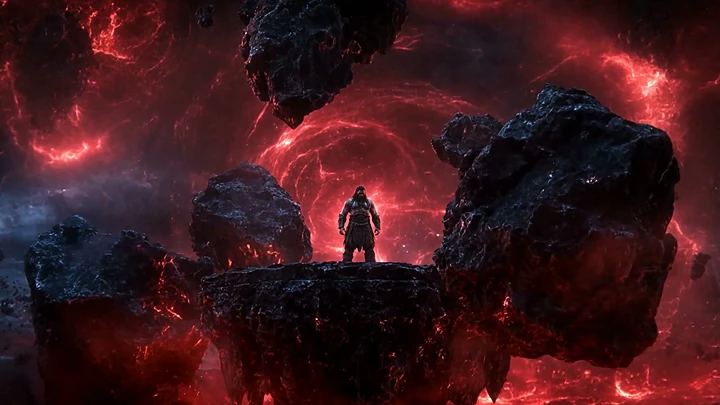
La generazione di VFX cinematografici richiede più di singoli fotogrammi impressionanti. Il modello deve coordinare movimento della camera, azioni del personaggio ed effetti visivi mantenendo una sequenza coerente. Questo test aiuta a vedere come ciascun modello gestisce scene visivamente complesse con più azioni dipendenti.
Seedance 2.5 tiene insieme meglio questo brief. Nel clip, un solo dio barbuto resta su un'unica vetta fratturata: un primo piano solenne, lo stesso volto con occhi luminosi, fulmini che si accumulano sul santuario, poi la figura in aria con un martello. Wan 3.0 produce effetti singoli più forti — un portale rosso, una tempesta di detriti, un'esplosione dorata e un cerchio di rune blu — ma il dio manca nel mezzo del clip e il martello compare come una posa dopo l'esplosione, non come una fusione che si può seguire. I fotogrammi campionati non mostrano un'orbita di 360 gradi completata per nessuno dei due modelli. Scegli Seedance 2.5 quando un personaggio e un luogo devono crescere fino al martello. Scegli Wan 3.0 quando un'inquadratura di effetti spettacolare conta più che restare sullo stesso volto e sullo stesso santuario.
Multi riferimento · 2 immagini · 30s · 16:9
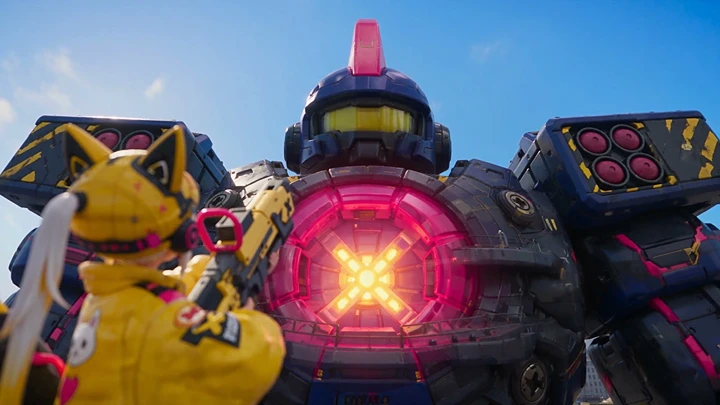
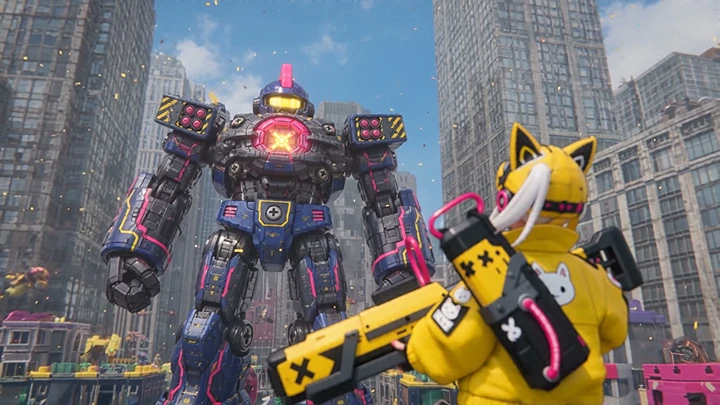
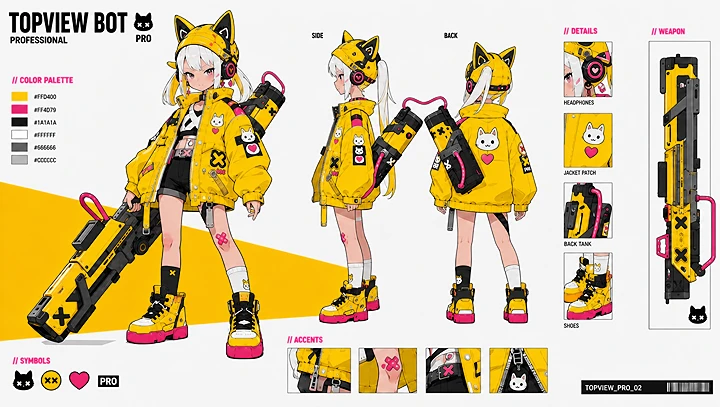
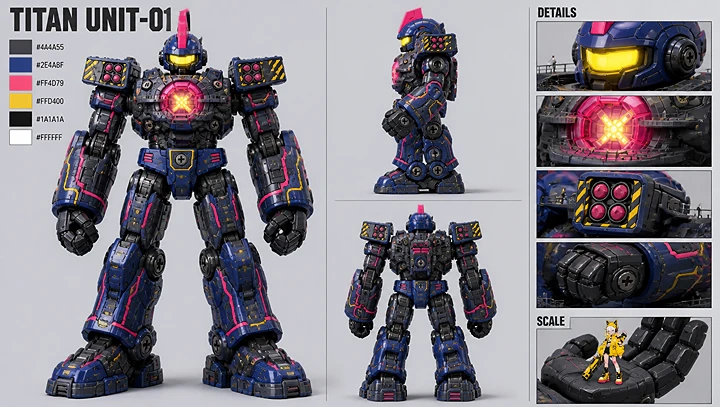
Una piccola eroina, TOPVIEW BOT, combatte un mech giocattolo gigante di nome TITAN in una città di giocattoli colorata. Due immagini di riferimento definiscono l'aspetto esatto di entrambi i personaggi, mentre il prompt specifica scala relativa, direzioni delle armi, sequenze di attacco e movimento continuo.
La battaglia di 30 secondi include attacchi missilistici, manovre di schivata, combattimento in aria, arrampicata sull'armatura del mech e un attacco energetico finale.
Multi riferimento · 3 immagini · 30s · 16:9
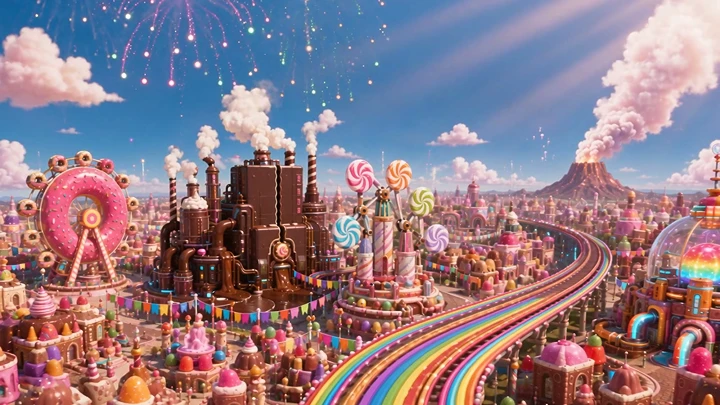
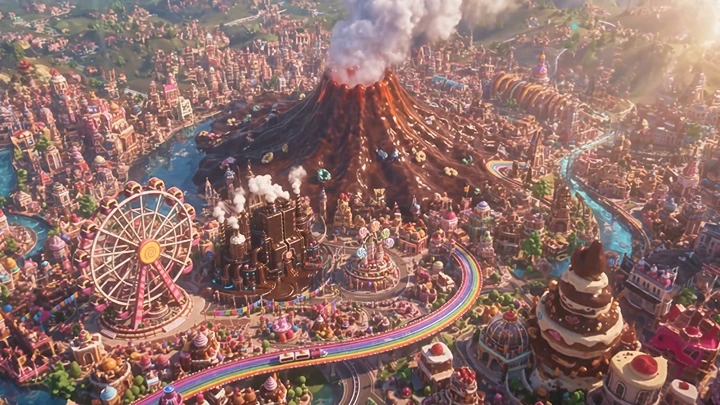
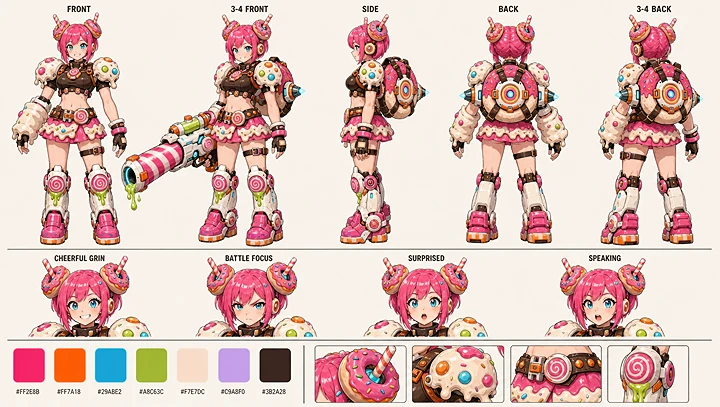
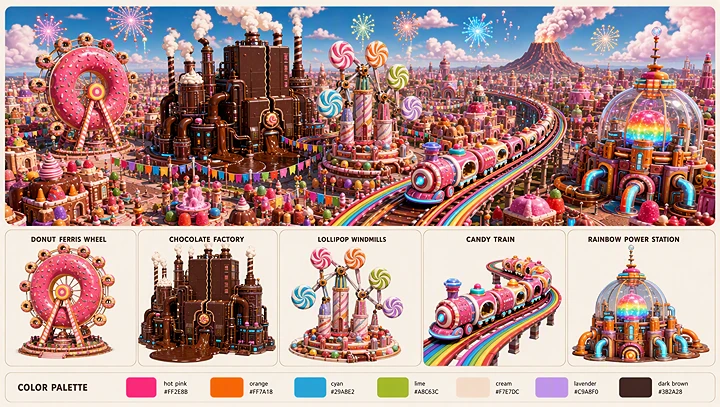
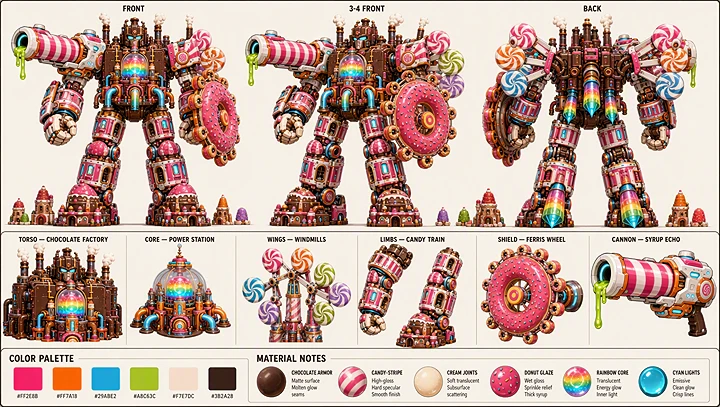
Un colorato Candy Kingdom affronta una minaccia crescente e l'eroina SUGAR POP deve difendere la città prima che i suoi landmark si combinino in un gigantesco Candy Super Mecha.
Tre schede di riferimento definiscono l'aspetto dell'eroina, l'ambiente del Candy Kingdom con i suoi landmark e il mecha finale assemblato. Il prompt chiede a entrambi i modelli di preservare questi design generando una storia d'azione completa di 30 secondi.
Da testo a video · 30s · 16:9
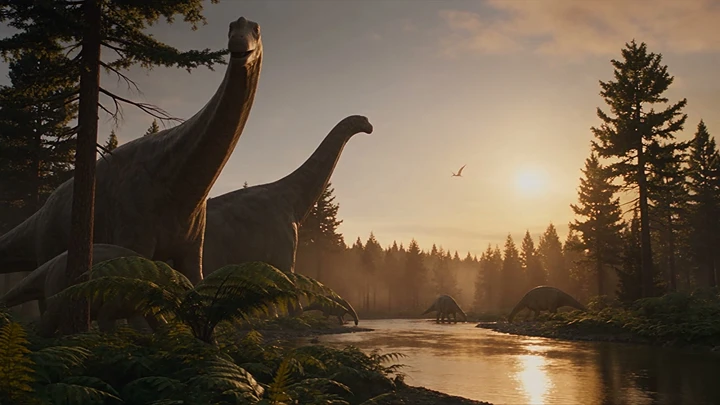
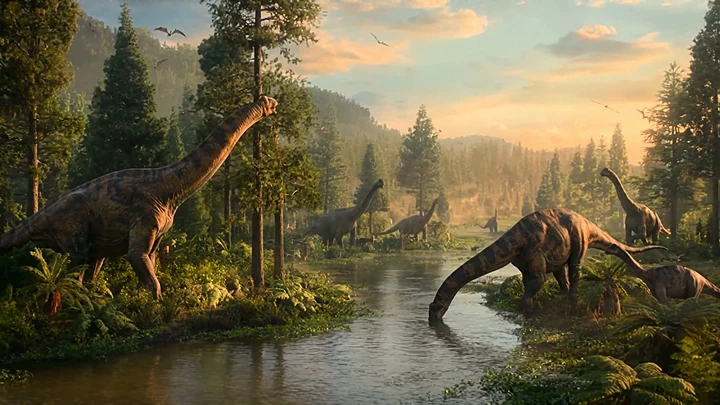
Un documentario di storia naturale ritrae gli ultimi momenti di un ecosistema preistorico, da una valle pacifica piena di dinosauri a un impatto catastrofico, un'onda d'urto, eruzioni vulcaniche e una Terra coperta di cenere.
Il prompt unisce una voice-over in inglese cronometrata con precisione, cinematografia in stile documentario, eventi ambientali su larga scala, movimento animale realistico e un finale orbitale silenzioso.
Da testo a video · 30s · 16:9
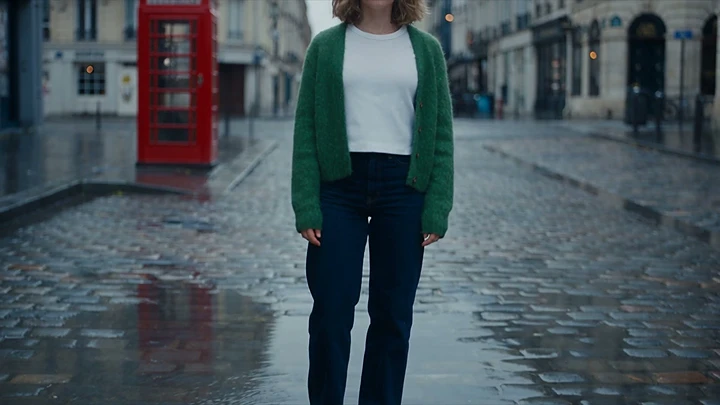
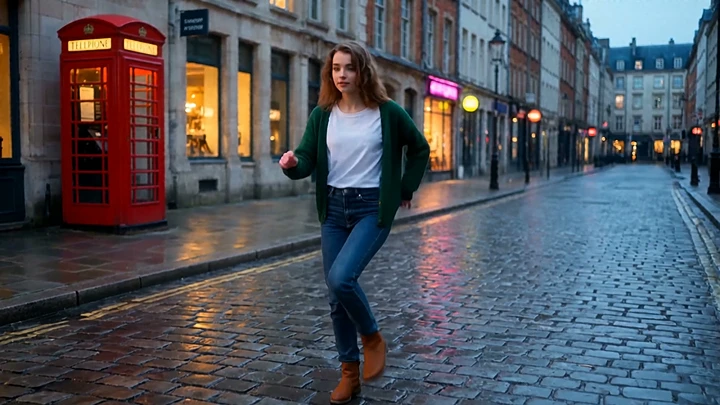
Una ballerina esegue una routine continua attraversando più mondi visivi. Il video inizia in una strada europea realistica, poi passa a cyberpunk, film muto in bianco e nero, animazione 3D e stile pittura a olio.
Ogni trasformazione cambia ambiente visivo e outfit, mentre identità della ballerina, coreografia e ritmo musicale sono pensati per restare coerenti. La sequenza si chiude con tutti e quattro i mondi alternativi insieme in una composizione finale.
Multi riferimento · 3 immagini · 15s · 16:9
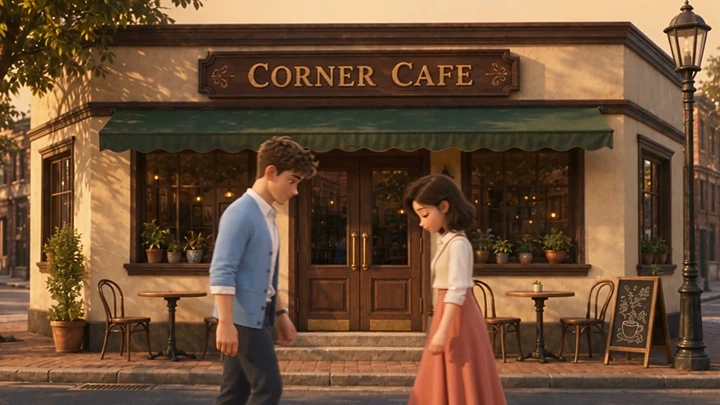
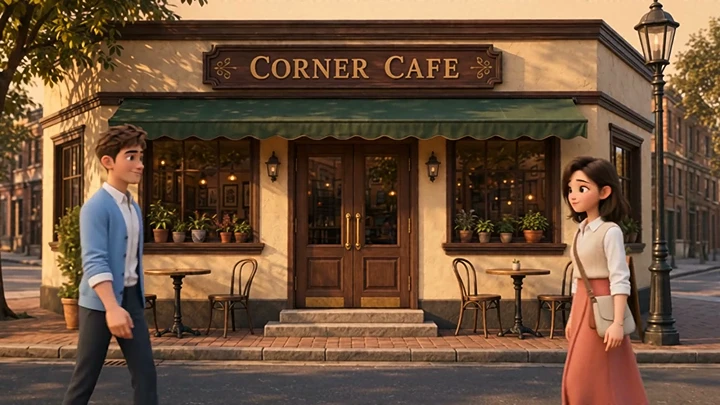
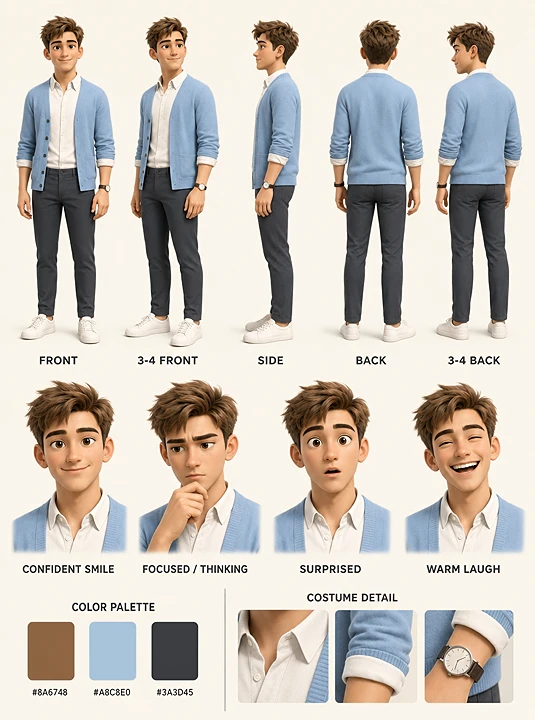
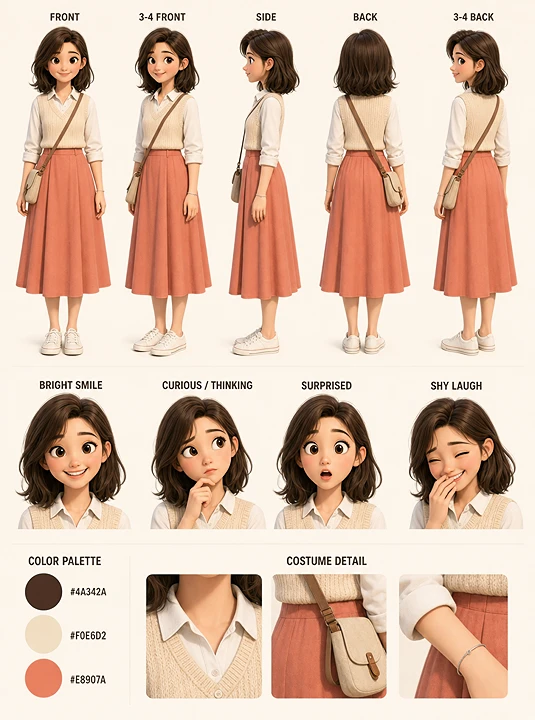
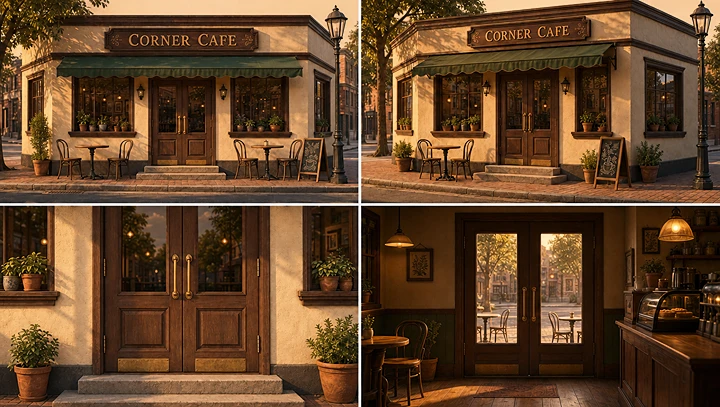
Due personaggi animati stilizzati, HAORAN e XIAOYU, si incontrano inaspettatamente fuori da un café, si scambiano quattro battute di dialogo in inglese ed entrano insieme nell'edificio.
Tre immagini di riferimento definiscono i personaggi e l'ambiente del café. Il prompt richiede dialoghi accurati, espressioni naturali, design dei personaggi coerenti e un'azione specifica di apertura della porta.
Da testo a video · 15s · 16:9
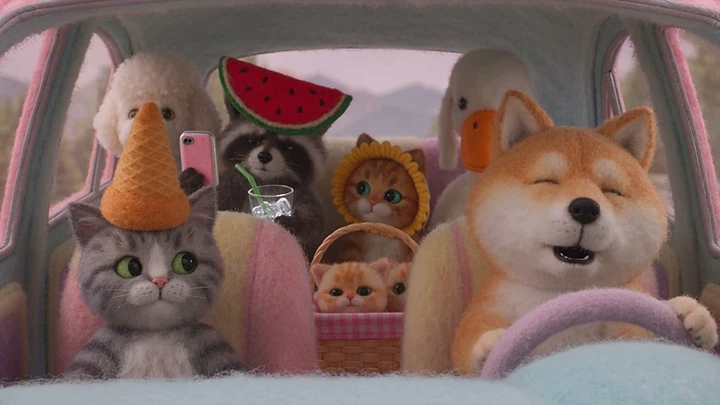
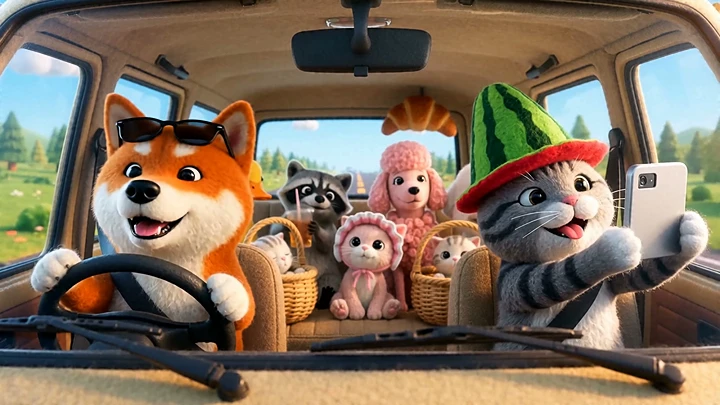
Un gruppo di personaggi animali in stile peluche espressivo parte per un viaggio in auto caotico. Dentro il veicolo in movimento, ogni personaggio compie un'azione diversa mentre eventi inattesi creano una catena di reazioni comiche.
La scena include un conducente Shiba Inu che canta, un gatto che fa un selfie, un'anatra che entra in foto, cappelli che si spostano, passeggeri che rimbalzano, oggetti che volano e reazioni di gruppo coordinate.
Il prompt chiede un angolo di camera fisso e un rendering coerente in feltro peluche per tutta la sequenza di 15 secondi.
Multi riferimento · 1 immagine + audio · 15s · 9:16
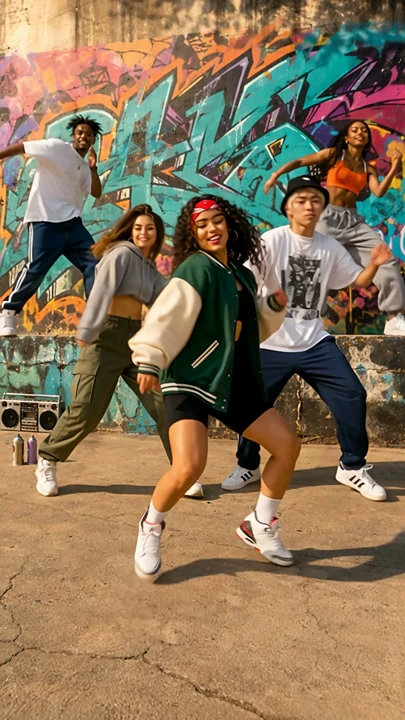
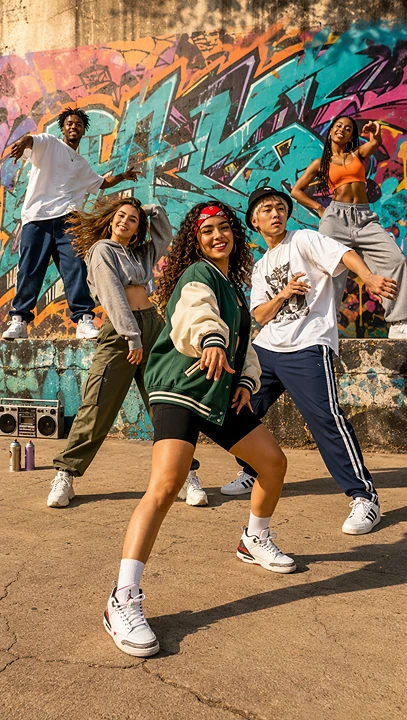
Cinque ballerini eseguono una routine di street dance coordinata in una piazza coperta di graffiti, con un'immagine di riferimento per l'aspetto e un riferimento audio per guidare la coreografia.
La routine inizia in formazione a V e passa a una linea orizzontale. Il prompt chiede a tutti e cinque i ballerini di preservare la propria identità, completare il cambio di formazione e sincronizzare i movimenti con la musica originale in un'unica ripresa continua.
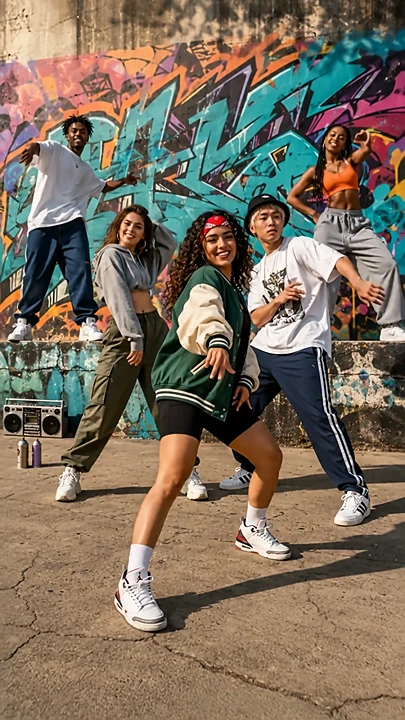
Da testo a video · 15s · 16:9
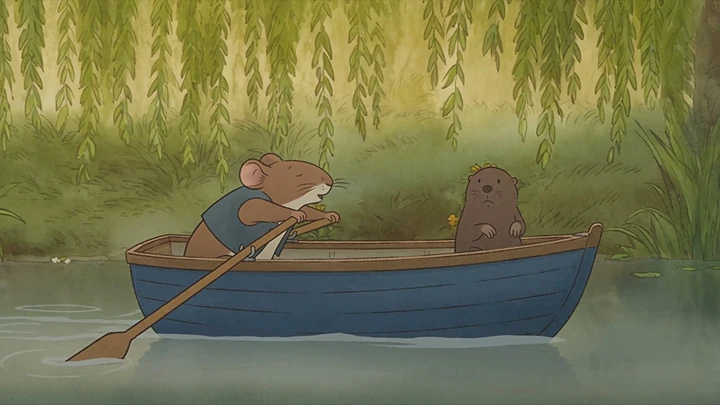
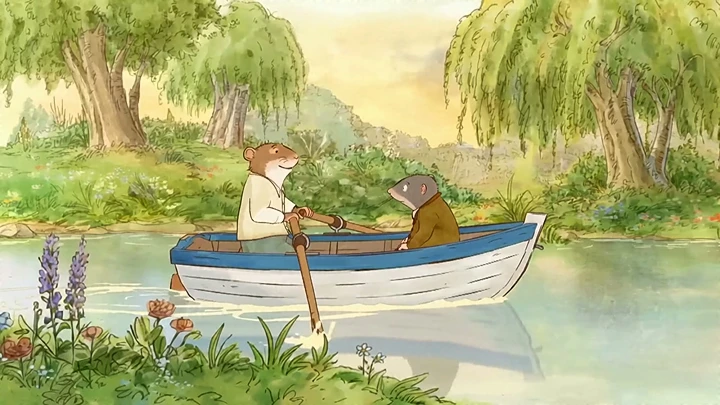
Una breve scena di The Wind in the Willows di Kenneth Grahame è adattata in un'animazione in stile acquerello edoardiano.
Un ratto d'acqua rema una barca blu e bianca lungo un fiume tranquillo, mentre una talpa siede a poppa. Quando il ratto si assorbe nella conversazione, la barca colpisce la riva e il rematore cade all'indietro prima di riprendersi.
Il test chiede a entrambi i modelli di riprodurre una sequenza letteraria specifica mantenendo i ruoli dei personaggi, le azioni fisiche e un aspetto illustrato coerente.
Questi nove confronti affiancati mostrano come Seedance 2.5 e Wan 3 rispondono a brief creativi specifici. I risultati possono variare tra generazioni, impostazioni e input di riferimento. I verdetti comparativi vanno basati sugli output mostrati e sui criteri di valutazione documentati.
Il nostro approccio di valutazione guarda se ciascun output risolve il compito creativo originale.
Ogni confronto usa lo stesso prompt previsto e gli stessi asset di partenza. Se un'impostazione non è disponibile su un modello, quella differenza va documentata e non trattata come una condizione di test identica.
Verifichiamo se soggetti, azioni, ordine delle scene e finali richiesti compaiono nell'output. Gli eventi chiave mancanti contano come limiti anche quando il video sembra curato.
Per i casi guidati dalle immagini, confrontiamo personaggi, prodotti, outfit, oggetti di scena e luoghi con il materiale di partenza. Una riproduzione più accurata non equivale per forza a uno styling più attraente.
Esaminiamo percorsi di camera, movimento del corpo, interazioni con gli oggetti e il rapporto tra inquadrature successive.
Cerchiamo deriva dell'identità, reset bruschi e rapporti spaziali incoerenti.
Per i casi guidati dall'audio, controlliamo le parole pronunciate, l'attribuzione di chi parla, la sincronizzazione labiale, i cue sonori e l'allineamento al beat quando i file di partenza pertinenti sono disponibili.
Un confronto affidabile delle prestazioni richiede i registri di invio di ogni tentativo, comprese generazioni fallite, nuovi tentativi e rifiuti di moderazione.
Il benchmark previsto usa tre generazioni per modello nei compiti più semplici e cinque generazioni per modello nei compiti più complessi, per un totale di 74 tentativi di generazione sui due modelli.
Ogni video completato viene valutato in modo indipendente con una griglia di punteggio predefinita.
Per evitare di scegliere solo i risultati visivamente più attraenti, l'output rappresentativo del benchmark è selezionato in base alla vicinanza al punteggio mediano di qualità in cieco per quel modello e quello scenario.
Modelli diversi possono interpretare istruzioni identiche in modi diversi.
Un output può eccellere nella composizione mentre un altro preserva più da vicino un personaggio o un'azione. Il modello migliore per un progetto è quello che raggiunge lo standard di qualità richiesto a un costo accettabile.
Confronta le stesse impostazioni di output, non solo la tariffa pubblicizzata più bassa.
Entrambi i modelli usano i crediti Topview, ma l'addebito reale dipende dalla variante del modello, dal flusso, dalla durata, dalla risoluzione e dal piano dell'account.
Il preventivo crediti del generatore prima dell'invio è la cifra più rilevante per il tuo progetto.
| Risoluzione | Seedance 2.5 su Topview | Wan 3.0 su Topview |
|---|---|---|
| 480p | 0.70 crediti/sec | 0.30 crediti/sec |
| 720p | 1.50 crediti/sec | 0.50 crediti/sec |
| 1080p | 3.70 crediti/sec | 1.00 crediti/sec |
Se un output ha bisogno di più tentativi prima di essere utilizzabile, il costo reale di produzione include quei tentativi.
Confronta i crediti totali consumati, la qualità dell'output e il numero di risultati accettabili, non solo il prezzo al secondo pubblicizzato.
Seedance 2.5 · Wan 3.0
Un video AI migliore inizia dal modello giusto per il lavoro.
Scegli Seedance 2.5 per una direzione ricca di riferimenti e un controllo creativo dettagliato, oppure esplora Wan 3.0 quando il brief rientra negli input disponibili e vuoi confrontare i costi di generazione.
Tieni coerenti prompt e riferimenti, rivedi gli output e scegli in base al risultato, non solo al nome del modello.
Le scene d'azione complesse chiedono molto alla generazione video AI. Il modello deve mantenere personaggi coerenti, capire la scala relativa, preservare i rapporti spaziali e coordinare più azioni nel tempo. Questo test verifica se sequenze di combattimento visivamente ambiziose restano comprensibili sul piano logico.
Wan 3.0 è la corrispondenza migliore con le schede di riferimento in questo scontro. L'apertura mantiene leggibili le doppie code bianche, il cappello con orecchie da gatto, la giacca gialla e il cannone contro il mech blu navy, la cresta rosa, la visiera gialla e il nucleo rosa sul petto; un fotogramma successivo mostra i missili in aria prima che lei torni sull'armatura. Seedance 2.5 vince la lettura della scala nell'inquadratura del pugno, dove lei è minuscola contro la mano, ma scende a livello strada e volto e arma diventano difficili da verificare quando la camera si allarga. Seedance chiude su un'esplosione rosa con chi spara fuori inquadratura; Wan chiude con lei piccola contro la visiera. Scegli Wan 3.0 quando le schede dei personaggi e il beat dei missili devono restare riconoscibili. Scegli Seedance 2.5 quando il contrasto gigante contro minuscolo conta più di una corrispondenza pulita con i riferimenti.
La generazione multi-riferimento chiede al modello di capire come input visivi separati si relazionano tra loro. Oltre a riprodurre i singoli oggetti, deve preservare l'identità, combinare elementi di design e mantenere un mondo creativo coerente tra scene che cambiano.
Questo test aiuta a valutare quanto ciascun modello traduca in modo affidabile più immagini di riferimento in un video più lungo e strutturato.
Seedance 2.5 è il risultato multi-riferimento più solido. Il primo piano mantiene il caschetto rosa di Sugar Pop, gli occhi blu e gli accessori di caramella nei capelli; il centro del clip lancia landmark di caramelle separati; e il robot in campo lungo corrisponde alla scheda del mecha, con il cannone a strisce sulla spalla, lo scudo a ciambella sull'avambraccio e gli arti di caramella in un solo corpo. Il finale è un raggio colorato con quel robot ancora in quadro. Wan 3.0 apre con il Candy Kingdom più chiaro — ruota panoramica, vulcano e strade di caramelle — ed è il clip che mostra il mostro di dolci sulla città. I fotogrammi successivi restano su un treno di caramelle e un volto di robot sfocato, quindi il mecha assemblato non si chiude come specifica la scheda. Scegli Seedance 2.5 quando personaggio, combinazione e mecha finito devono restare tutti in un solo video. Scegli Wan 3.0 quando regno e mostro devono leggersi per primi.
La generazione di video documentari dipende da una comunicazione accurata, non solo da immagini cinematografiche. Narrazione, timing delle scene, storytelling visivo e continuità ambientale devono funzionare insieme per comunicare una sequenza completa.
Questo test esamina come ciascun modello coordini la narrazione parlata con eventi visivi complessi lungo 30 secondi.
Wan 3.0 porta più avanti la storia per immagini. I fotogrammi passano da una valle fluviale dorata a una fuga frontale sotto un muro di polvere, un'eruzione, un animale caduto nella cenere e una Terra grigia in orbita. Anche Seedance 2.5 va dalla valle illuminata dal sole a un branco in corsa, un'inondazione con un piccolo stegosauro e un sauropode grigio cenere, ma resta nella valle tranquilla ben dentro il clip e l'ultimo fotogramma campionato è un grigio senza dettagli, non l'orbita. L'inondazione e il piccolo animale contro il paesaggio sono più chiari su Seedance. Questi fotogrammi non confermano il testo parlato, il ritmo o le pause. Scegli Wan 3.0 quando il video deve arrivare al collasso e al finale orbitale. Scegli Seedance 2.5 quando valle e inondazione devono restare naturalistici, poi verifica se la tua generazione arriva in orbita.
Il cambio di stile chiede al modello di separare l'aspetto visivo dall'identità del soggetto e dal movimento. Ambiente e trattamento artistico possono cambiare in modo netto, ma il personaggio e l'azione di base devono restare comprensibili.
Questo test esplora come ciascun modello gestisca trasformazioni coordinate tra più stili visivi in un'unica sequenza creativa continua.
Seedance 2.5 copre più mondi richiesti. I campioni mostrano la strada europea bagnata e il cardigan verde, un outfit cyberpunk al neon, un fotogramma letterbox in bianco e nero da film muto, una svolta a olio stellato in un abito blu, poi il look originale circondato da quattro riquadri separati. Wan 3.0 danza in modo più chiaro nelle sezioni strada e cyberpunk, e il beat di animazione 3D con l'abito giallo è una scena intera, non un'immagine dentro un riquadro. Il mondo del film muto non compare nei campioni di Wan e il finale sono quattro immagini separate, non un poster unico con la ballerina al centro. Scegli Seedance 2.5 quando l'elenco degli stili e il finale a quattro mondi sono il punto del brief. Scegli Wan 3.0 quando una coreografia leggibile e il mondo cartoon contano più del segmento del film muto.
Le scene di dialogo uniscono diversi compiti impegnativi: generazione del parlato, sincronizzazione labiale, coerenza dei personaggi, recitazione emotiva e interazione fisica coordinata.
Un risultato convincente dipende da questi elementi che lavorano insieme. Questo test aiuta a valutare quanto ciascun modello gestisca uno storytelling guidato dai personaggi.
Entrambi i clip mantengono i design di riferimento: il cardigan blu, il gilet crema, la gonna salmone e la tenda di Corner Cafe. Le bocche sono aperte durante la conversazione, ma i fotogrammi fissi non possono confermare le quattro battute né un vero lip sync. La porta è la differenza visibile. L'ultimo fotogramma di Wan 3.0 lo mostra mentre tiene la maniglia d'ottone e lei attraversa la porta aperta. Seedance 2.5 accompagna la coppia all'ingresso e all'interno, senza un momento chiaro in cui la porta resta aperta verso l'esterno. Scegli Wan 3.0 per questo brief quando l'azione all'ingresso deve corrispondere al prompt. Entrambi i modelli funzionano quando la priorità è tenere coerenti i due personaggi e il café; ascolta le battute prima di bloccare una take.
La recitazione con più personaggi mette alla prova la capacità del modello di gestire diverse azioni indipendenti in un ambiente condiviso.
La sfida non è semplicemente generare molti personaggi insieme, ma preservarne l'identità, coordinarne le interazioni e mantenere rapporti logici di causa ed effetto nella scena.
Seedance 2.5 mantiene l'interno bloccato. La stessa vista dal parabrezza tiene lo shiba al volante con la bocca aperta, il gatto con il cappello anguria e l'anatra. Il collo dell'anatra viene in avanti, ma lo scambio di cappelli, la presa dell'uva e il pollice alzato finale non sono visibili. Wan 3.0 mostra più di quelle gag: un croissant sulla testa, il barboncino premuto contro il cane bianco, un gattino scontroso nel cestino e un pollice alzato del conducente. La camera lascia anche l'angolo bloccato, passando dall'abitacolo intero al sedile posteriore e dentro il cestino, e cappelli e posti si rimescolano. Scegli Seedance 2.5 quando contano una camera fissa e un cast stabile. Scegli Wan 3.0 quando la catena comica di reazioni conta più di un unico angolo ininterrotto.
La generazione di danza richiede un coordinamento preciso tra movimento visivo, identità dei personaggi, posizione del gruppo e timing audio.
Una sequenza di danza visivamente gradevole può comunque fallire se i performer perdono la sincronizzazione o la formazione cambia in modo errato. Questo test esamina se ciascun modello riesce a coordinare più soggetti con un riferimento musicale esterno.
Wan 3.0 apre più vicino alla foto di riferimento: cinque ballerini, la giacca varsity verde davanti e una postura simile a una V contro il muro di graffiti. A metà quel gruppo sparisce e un solo ballerino riempie la piazza, prima che un fotogramma successivo torni con una folla più larga. Seedance 2.5 tiene un gruppo in ogni campione, giacca verde inclusa, ma i fotogrammi successivi aggiungono persone e non mostrano un passaggio pulito dalla V iniziale a un'unica linea orizzontale degli stessi cinque. I fermi immagine non possono confermare che uno dei due clip resti sul beat originale o lasci l'audio intatto. Scegli Seedance 2.5 quando tutti i ballerini devono restare in quadro. Scegli Wan 3.0 quando la prima inquadratura deve corrispondere al riferimento, poi guarda il centro del clip prima di accettare il cambio di formazione.
L'adattamento letterario chiede al modello di tradurre uno storytelling scritto in una sequenza visiva chiara.
La sfida non è semplicemente produrre immagini da libro illustrato gradevoli. Il risultato dovrebbe preservare i ruoli dei personaggi, i rapporti di causa ed effetto e gli eventi essenziali che rendono riconoscibile la scena originale.
Questo test aiuta a valutare con quanta fedeltà ciascun modello converta un brano letterario dettagliato in un video breve.
Seedance 2.5 segue il brano più avanti. Il ratto rema mentre la talpa siede a poppa, poi il ratto è sulla schiena con i piedi in aria, poi si rialza a sedere. La barca si legge come blu piena, non blu fuori e bianca dentro, e la prua che colpisce la riva è implicata dalla caduta, non mostrata. Wan 3.0 corrisponde meglio alla barca — blu fuori, bianca dentro — e tiene un acquerello edoardiano più stabile mentre remano sotto i salici. I fotogrammi finali inclinano la barca verso i fiori e poi tornano a una remata calma, quindi mancano la caduta con i talloni in aria e il recupero. Scegli Seedance 2.5 quando lo scontro e la caduta devono essere leggibili. Scegli Wan 3.0 quando la barca dipinta e il fiume quieto contano più della battuta finale.
"Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)
Fonte originale: Kenneth Grahame, The Wind in the Willows (1908), capitolo I. Testo di pubblico dominio disponibile tramite Project Gutenberg.