Seedance 2.5 vs MiniMax H3
Due modelli video AI, una sola area di lavoro Topview. Confronta durata, risoluzione, riferimenti multimodali, audio nativo e accesso aperto o in hosting, poi scegli il modello giusto per il tuo progetto.
Fianco a fianco
Stesso prompt, due modelli
Per ogni brief qui sotto, lo stesso prompt e gli stessi riferimenti in ingresso (quando usati) passano da Seedance 2.5 e da MiniMax H3, senza ripetere la generazione. Guarda entrambi i risultati e giudica tu.
Confronto su effetti visivi spettacolari
Solo testo
Prompt
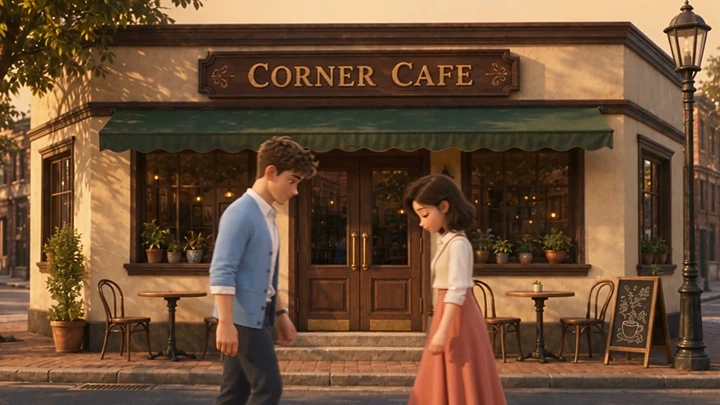
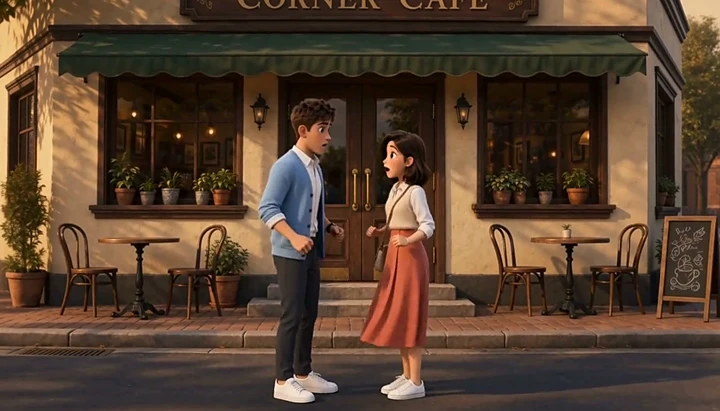
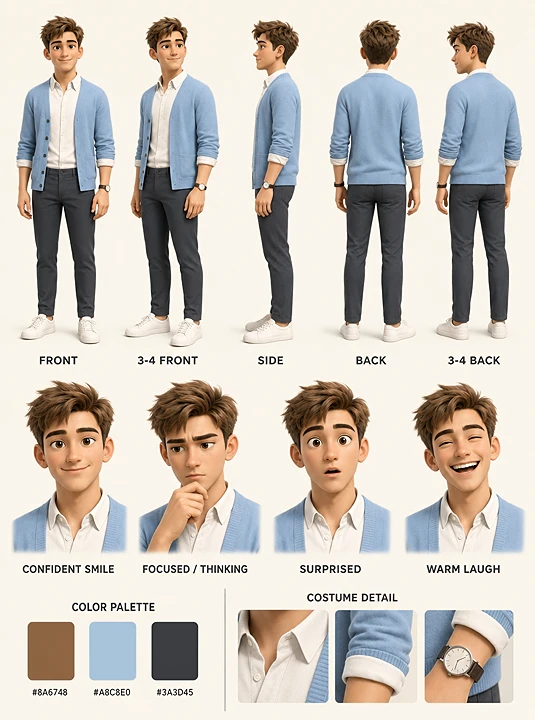
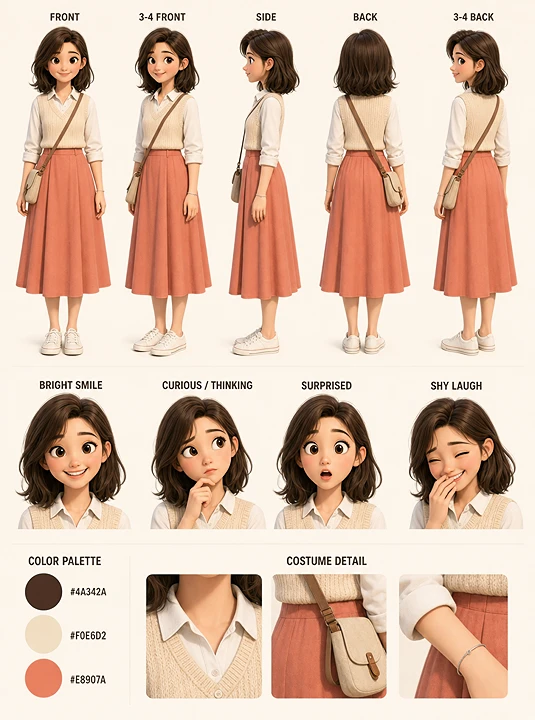
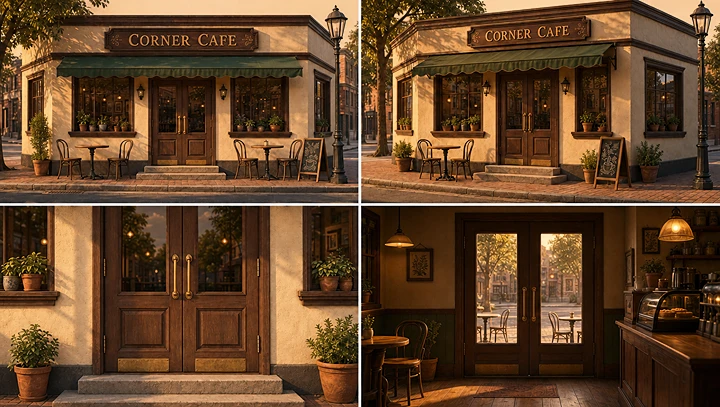
Confronto su una scena di dialogo
3 immagini
Riferimento immagine 1
Riferimento immagine 2
Riferimento immagine 3
Prompt
Confronto su recitazione corale
Solo testo
Prompt
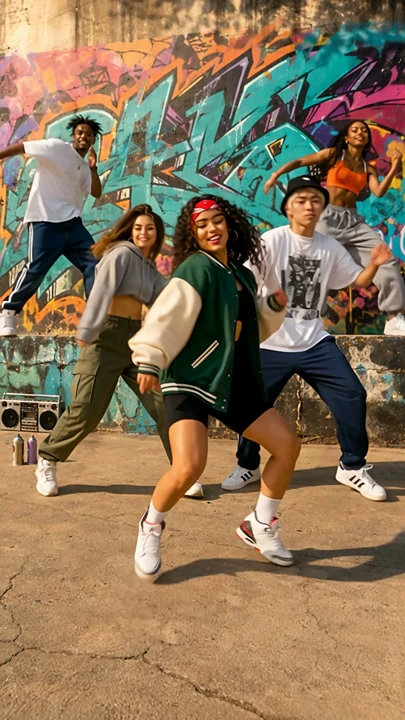
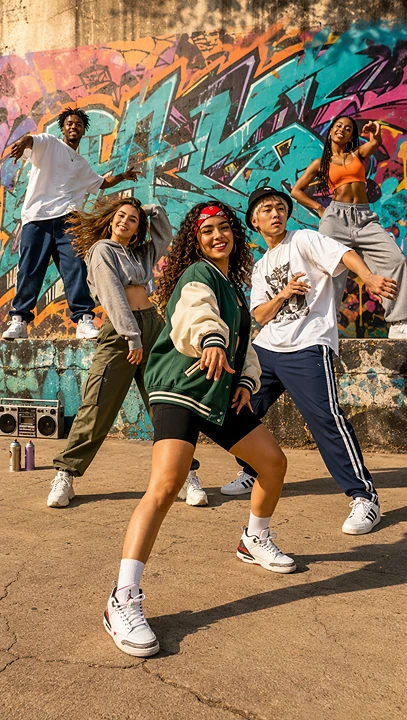
Confronto su ballo di gruppo e sincronia con il ritmo
1 immagine + audio
Riferimento immagine 1
Riferimento audio
Riferimento con traccia ritmica
Prompt
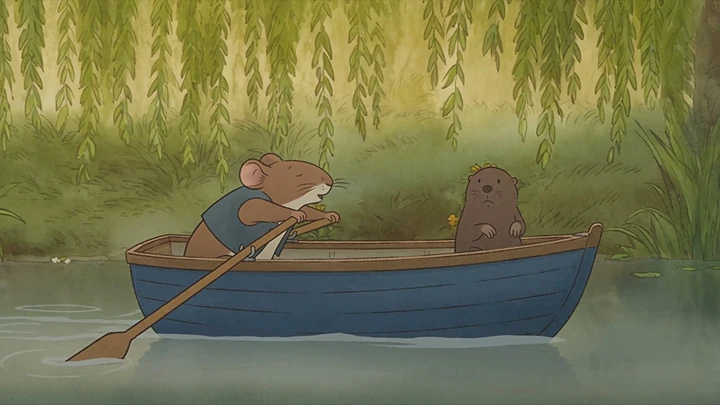
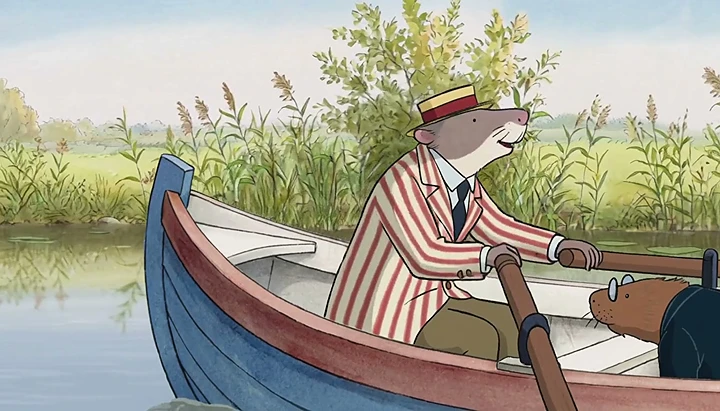
Confronto su adattamento letterario
Solo testo
Adattamento fedele da Il vento tra i salici (1908), cap. I: valuta ogni modello rispetto al passaggio originale mostrato a fianco.
Prompt
Passaggio originale
"Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)
Confronto su una battaglia contro un boss di gioco
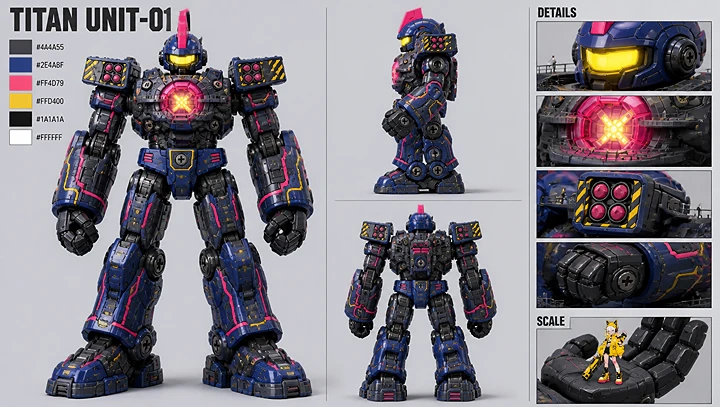
2 immagini
Riferimento immagine 1
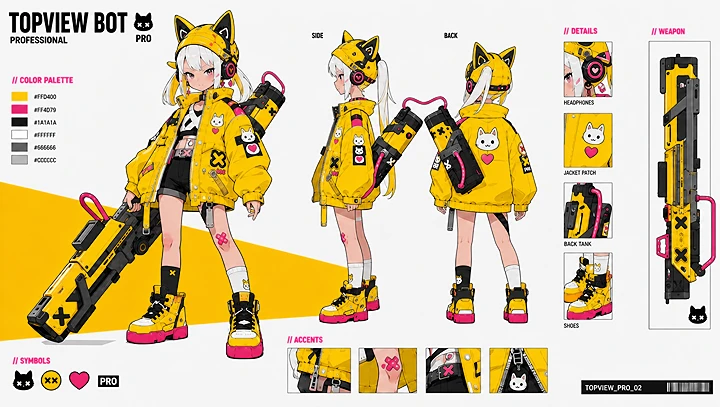
Riferimento immagine 2
Prompt
Confronto specifica per specifica
Ogni valore riflette come il modello è rappresentato su Topview e le informazioni pubbliche di ciascun fornitore: nessun punteggio di benchmark, nessun test alla cieca, solo i fatti messi a confronto.
| Dimensione | Seedance 2.5 | MiniMax H3 |
|---|---|---|
| Sviluppatore | ByteDance | MiniMax |
| Tipo di modello | Modello video multimodale (in hosting) | Omni-Modality Transformer (pesi aperti) |
| Distribuzione e accesso | In hosting su Topview (e su piattaforme ByteDance / partner) | Pesi aperti; API / piattaforma aperta; pronto per deploy privato / on-premise |
| Risoluzione (Topview) | 480p / 720p / 1080p | 768p / 2K nativo (2560×1440) |
| Durata | Clip continua nativa da 4 a 30 secondi | Da 5 a 15 secondi per inquadratura |
| Input immagine | Fino a 30 immagini | Fino a 9 (max 15 combinati tra i riferimenti) |
| Input video | Fino a 10 clip (video di riferimento combinato non oltre 30 secondi) | Fino a 3 clip (max 15 combinati tra i riferimenti) |
| Input audio | Fino a 10 file (audio di riferimento combinato non oltre 30 secondi) | Fino a 3 file (max 15 combinati tra i riferimenti) |
| Riferimenti totali | Fino a 50 asset | Fino a 15 combinati |
| Audio nativo | Dialoghi, musica ed effetti sonori con indicazioni temporizzate | Dialoghi + musica + sincronizzazione labiale |
| Sincronizzazione labiale multilingua | Dialoghi multilingua; gestione dei sottotitoli più affidabile (come su Topview) | Sincronizzazione labiale multilingua a livello globale |
| Ideale per | Storie continue più lunghe, riferimenti multimodali intensivi (50 combinati), durata automatica | Resa visiva in 2K, deploy aperto / privato, editing omni-modale |
I valori qui sopra seguono la configurazione del generatore di produzione Topview per Seedance 2.5 e MiniMax H3 (livelli di risoluzione selezionabili e limiti sui riferimenti). Restano esclusi i 4K come output predefinito, i punteggi Elo e i prezzi dichiarati da terze parti. Non viene fatta alcuna affermazione su vittorie o sconfitte nei benchmark.
Dove si distingue ciascun modello
Seedance 2.5
Clip continue più lunghe
Genera una sequenza coerente da 4 a 30 secondi in un solo passaggio: più spazio per annunci, video esplicativi e storie a più momenti, senza cucire insieme tanti frammenti brevi.
Controllo multimodale spinto
Guida identità, movimento e suono con un massimo di 50 riferimenti (30 immagini, 10 video, 10 audio), più prompt basati su ricerche internet.
Editing in stile produzione
Rivedi un segmento selezionato di una clip da 4 a 30 secondi senza rigenerare l'intera ripresa: è pensato per la produzione iterativa.
MiniMax H3
Output in 2K nativo
Genera in 2K nativo (2560×1440) per inquadrature di prodotto e commerciali più nitide, quando la priorità è la risoluzione.
Pesi aperti e deploy privato
Ospita in proprio, fai fine-tuning o esegui on-premise quando la residenza dei dati o il controllo dello stack escludono una semplice API in hosting.
Editing omni-modale
Combina indicazioni di testo, immagine, audio e video con dialoghi, musica e sincronizzazione labiale nativi, per iterare in fretta sul multimodale.
Quale modello si adatta al tuo flusso di lavoro?
Abbina il tuo progetto al modello pensato per quel lavoro.
Annuncio o video esplicativo continuo fino a 30 secondi
La generazione nativa da 4 a 30 secondi dà a un'idea completa lo spazio per aprirsi, svilupparsi e chiudersi in una sola clip.
Lasciare che il modello adatti automaticamente la durata della clip al ritmo
La durata automatica è segnalata per Seedance 2.5 su Topview: sceglie una lunghezza adeguata nell'intervallo da 4 a 30 secondi senza taglio manuale.
Numero massimo di riferimenti tra immagine, video e audio
Fino a 50 asset multimodali sostengono pacchetti complessi di brand e world building.
Inquadrature di prodotto o commerciali in 2K nativo
L'output in 2K nativo è pensato per consegne più nitide quando è la risoluzione a guidare il brief.
Pipeline privata / on-premise o a pesi aperti
Pesi aperti e deploy privato si adattano ai team che non possono affidarsi solo a un'API cloud in hosting.
Clip multimodali rapide con sincronizzazione labiale nativa
Dialoghi, musica e sincronizzazione labiale in un unico passaggio omni-modale si adattano a test social brevi e di localizzazione.
Revisione di un singolo segmento dopo una buona clip di base
L'editing locale mantiene più stabile il resto della sequenza mentre rivedi il momento selezionato.
Riscrittura omni-modale guidata da istruzioni (voce, tono, scena)
L'editing omni-modale è pensato per i flussi di trasferimento di voce e tono e di riscrittura della scena.
Domande frequenti
Prova entrambi i modelli su Topview
Stessa area di lavoro, stessi riferimenti: scegli il modello adatto al brief oppure fai passare l'idea da entrambi.