Seedance 2.5
Klipy do 30 sekund, do 50 referencji łącznie w podanym procesie Topview oraz szczegółowe prowadzenie ujęcia i dźwięku.
Który model wideo AI wybrać?
Zarówno Seedance 2.5, jak i Wan 3.0 obsługują procesy wideo AI do 30 sekund, a w obsługiwanych procesach Topview wyjście sięga 1080p.
Praktyczny wybór zależy od briefu: Seedance 2.5 warto rozważyć przy produkcji opartej na wielu referencjach i precyzyjnych wskazówkach czasowych. Wan 3.0 warto rozważyć, gdy liczy się koszt generowania za sekundę.
Zanim wygenerujesz materiał, porównaj obsługiwane ustawienia, gotowe wideo obok siebie i kompromisy poszczególnych modeli.
Seedance 2.5
Klipy do 30 sekund, do 50 referencji łącznie w podanym procesie Topview oraz szczegółowe prowadzenie ujęcia i dźwięku.
Wan 3.0
Klipy do 30 sekund, do 20 referencji łącznie w podanym porównaniu Topview oraz niższe opublikowane stawki za sekundę dla wybranych trybów generowania.
Limity i ceny zależą od trybu, konta i wybranych ustawień generowania. Przed wysłaniem zadania zawsze sprawdź aktualny generator.
Oba modele łączą generowanie wideo ze wskazówkami multimodalnymi. Tabela oddziela dokumentację na poziomie modelu od ustawień podanych dla procesu Topview.
| Parametr | Seedance 2.5 | Wan 3.0 |
|---|---|---|
| Twórca | ByteDance | Alibaba |
| Główne zastosowanie | Dłuższe briefy z dużą liczbą referencji | Tworzenie multimodalne z uwagą na koszt generowania |
| Czas trwania | 4–30 s, wybór co sekundę | 2–30 s, wybór co sekundę |
| Rozdzielczość | 480p / 720p / 1080p | 480p / 720p / 1080p |
| Proporcje | 16:9, 9:16, 3:4, 1:1, 4:3, 21:9 (plus adaptacyjne) | 16:9, 9:16, 1:1, 4:3, 3:4 |
| Tekst na wideo | Obsługiwane | Obsługiwane |
| Obraz na wideo | Obsługiwane | Obsługiwane |
| Wskazówki wideo i dźwięku | Obsługiwane w zgodnych procesach | Obsługiwane w zgodnych procesach |
| Referencje obrazu | Do 30 | Do 10 |
| Referencje wideo | Do 10 | Do 5 |
| Referencje dźwięku | Do 10 | Do 5 |
| Referencje łącznie | Do 50 | Do 20 |
| Generowanie dźwięku | Dostępne w obsługiwanych procesach | Dostępne w obsługiwanych procesach |
| Timing i prowadzenie scen | Instrukcje z timecode oraz wybór czasu co sekundę | Wskazówki ujęć i scen, zależnie od procesu |
| Cena | Kredyty zależą od rozdzielczości, czasu, trybu i planu Np. 1.5 kredytu/s przy 720p | Kredyty zależą od rozdzielczości, czasu, trybu i planu Np. 0.5 kredytu/s przy 720p |
| Najlepsze do | Opowieści z wieloma referencjami i szczegółowego prowadzenia | Generowania z uwagą na koszt i skupionych briefów |
Limity referencji odzwierciedlają ustawienia obecnie podane w porównaniu Topview, a nie gwarancję dla każdego dostawcy lub konta. Sprawdź dostępne ustawienia w generatorze. Ceny planów są na .
Zacznij od rodzaju wideo, którego potrzebujesz, a nie od nazwy modelu. Te rekomendacje dotyczą dopasowania procesu, a nie tezy, że jeden model zawsze daje ładniejsze wideo.
Zarówno Seedance 2.5, jak i Wan 3 obsługują generowanie wideo AI do 30 sekund, ale dają inne korzyści. Wybierz Seedance 2.5 do projektów z wieloma referencjami, precyzyjnego timingu i szczegółowego prowadzenia dźwięku. Rozważ Wan 3 do produkcji z uwagą na koszt, dłuższej opowieści jednym ujęciem i scen prowadzonych referencjami.
Zepnij złożony brief w jednym procesie: do 50 referencji, w tym 30 obrazów, 10 wideo i 10 plików dźwiękowych. Prowadź tożsamość postaci, detale produktu, ruch, otoczenie i dźwięk. Wan 3 obsługuje przy tym 20 referencji.
Użyj referencyjnych plików wideo i dźwięku o długości do 30.2 sekundy każdy, z uwzględnieniem łącznego limitu czasu w procesie. Prowadź ruch, tempo i dźwięk dłuższymi ujęciami albo referencjami muzycznymi.
Wybierz czas trwania od 4 do 30 sekund, co jedną sekundę. Instrukcjami z timecode zaplanuj ujęcia, działania, przejścia i tempo scen w ciągłym wideo.
Wskaż dialog, muzykę w tle i efekty dźwiękowe instrukcjami z timecode. Zgraj mowę, działanie i atmosferę z generowaniem dźwięku w jednym procesie.
W opublikowanym cenniku referencyjnym Topview dla Wan 3.0 podano 0.30 kredytu/s przy 480p, 0.50 przy 720p i 1.00 przy 1080p. Dla Seedance 2.5 podano 0.70, 1.50 i 3.70 kredytu/s. Przed generowaniem sprawdź rzeczywistą wycenę kredytów, bo stawka zależy od wybranego procesu i planu.
Złóż ciągłą sekwencję wideo do 30 sekund bez sklejania kilku krótkich klipów. Przydaje się przy odsłonięciu produktu, nieprzerwanym ruchu kamery i historiach marki, którym służy jedno płynne ujęcie.
Użyj Omni Reference, aby prowadzić tożsamość postaci, rekwizyty i otoczenie przez dłuższą narrację. Trzymaj świat kreatywny przy referencjach wizualnych, rozwijając sceny i działania.
Użyj wyszukiwania referencji z pomocą internetu, aby wesprzeć tworzenie wideo dodatkowym materiałem wizualnym i kontekstowym, jeśli ta funkcja jest dostępna w Twoim procesie Topview.
Ten sam brief. Dwa modele wideo AI. Dziewięć praktycznych scenariuszy.
Jak Seedance 2.5 i Wan 3 wypadają przy tych samych wskazówkach? Dziewięć porównań obok siebie obejmuje kinowe VFX, złożoną akcję, referencje multimodalne, narrację dokumentalną, zmianę stylu, dialog, interakcję postaci, synchronizację tańca i adaptację literacką.
Każde porównanie pokazuje wyniki obu modeli razem z oryginalnym promptem i referencjami, jeśli występują. Zobacz, jak każdy model radzi sobie z tym samym zadaniem, sprawdź istotne detale i oceń, który model lepiej pasuje do danego typu projektu.
Tekst na wideo · 30 s · 16:9
Nordycki bóg unosi się nad pękniętą obsydianową świątynią, podczas gdy złote błyskawice, unoszące się odłamki i świecące runy budują wybuchowe zakończenie. Kamera wykonuje ciągły oblot o 360 stopni, postać przyzywa ogromny młot bojowy i uwalnia silną falę uderzeniową.
Test wymaga od obu modeli połączenia złożonych efektów, ruchu postaci, dynamicznej kamery i ciągłej sekwencji akcji w jednym wideo o długości 30 sekund.
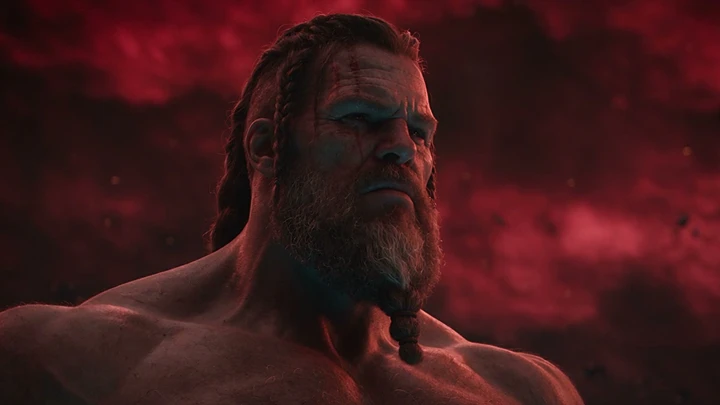
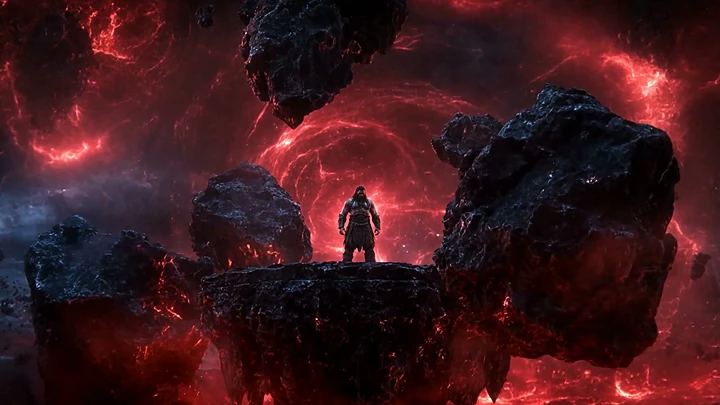
Kinowe generowanie VFX wymaga więcej niż pojedynczych efektownych klatek. Model musi zgrać ruch kamery, działania postaci i efekty oraz utrzymać spójną sekwencję. Ten test pokazuje, jak każdy model prowadzi wizualnie złożoną scenę z kilkoma zależnymi działaniami.
Seedance 2.5 lepiej trzyma ten brief w całości. Przez cały klip jeden brodaty bóg zostaje na jednym pękniętym szczycie: uroczyste zbliżenie, ta sama twarz ze świecącymi oczami, błyskawice na świątyni, potem postać w powietrzu z młotem. Wan 3.0 ma mocniejsze pojedyncze efekty: czerwony portal, burzę odłamków, złoty błysk i niebieski krąg run. Boga brakuje jednak w środku klipu, a młot pojawia się jako poza dopiero po błysku, a nie jako formowanie, które da się śledzić. Na wybranych klatkach żaden model nie pokazuje dokończonego oblotu o 360 stopni. Wybierz Seedance 2.5, gdy jedna postać i jedna lokacja mają narastać aż do młota. Wybierz Wan 3.0, gdy efektowne ujęcie jest ważniejsze niż pozostanie przy tej samej twarzy i świątyni.
Wiele referencji · 2 obrazy · 30 s · 16:9
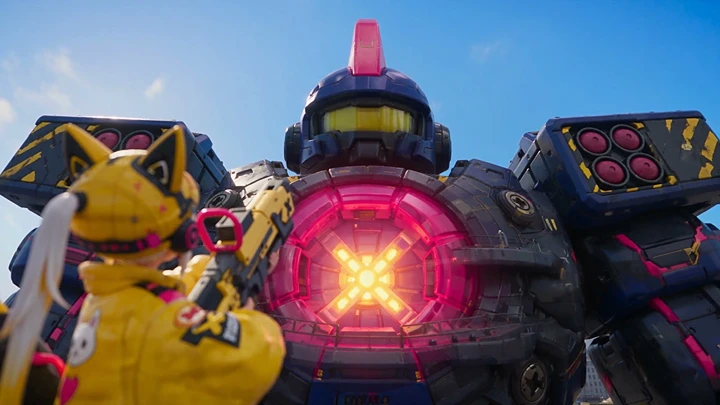
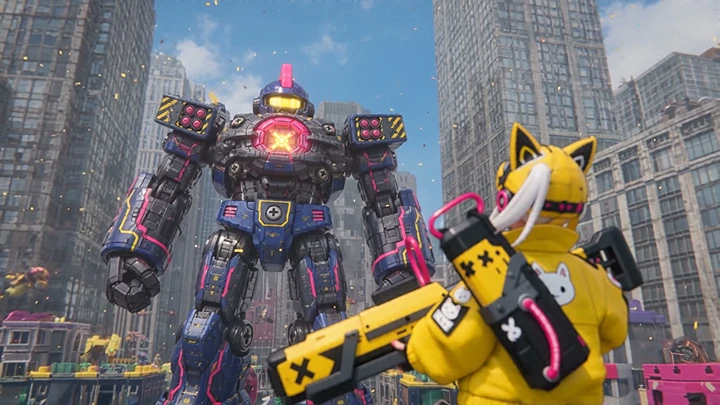
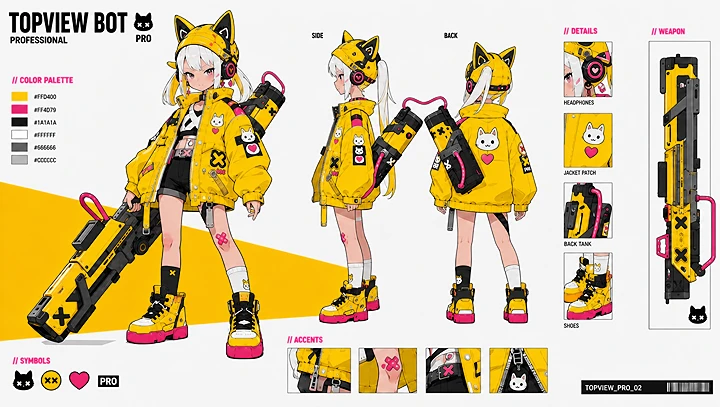
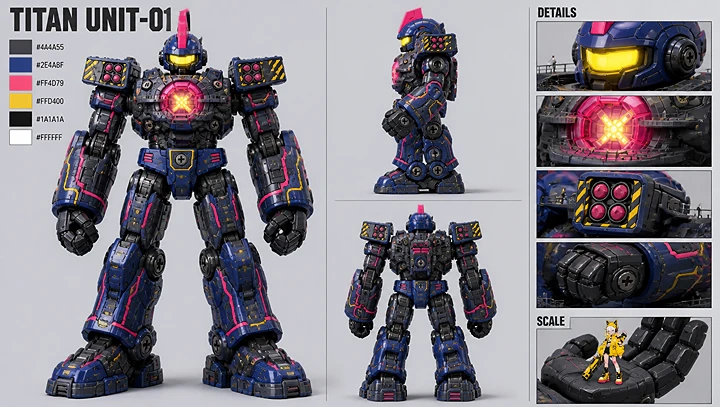
Niewielka bohaterka TOPVIEW BOT walczy z ogromnym zabawkowym mechem TITAN w kolorowym mieście zabawek. Dwa obrazy referencyjne określają dokładny wygląd obu postaci, a prompt podaje ich względną skalę, kierunki broni, sekwencję ataków i ciągły ruch.
Walka przez 30 sekund obejmuje ataki rakietowe, uniki, walkę w powietrzu, wspinaczkę po pancerzu mecha i finałowy atak energetyczny.
Wiele referencji · 3 obrazy · 30 s · 16:9
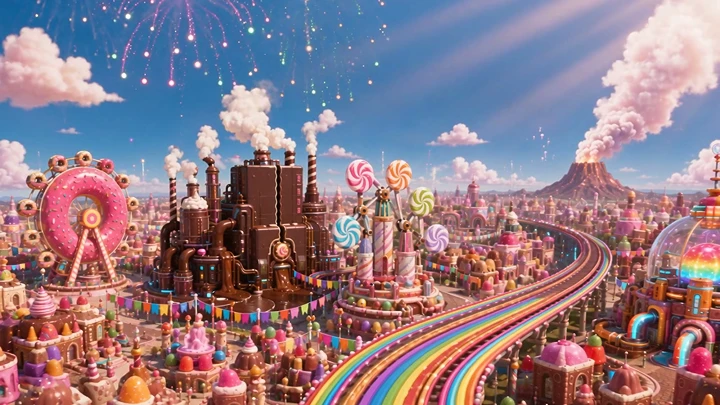
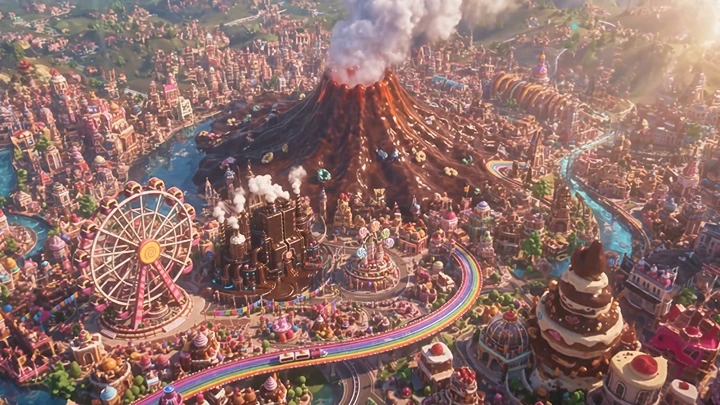
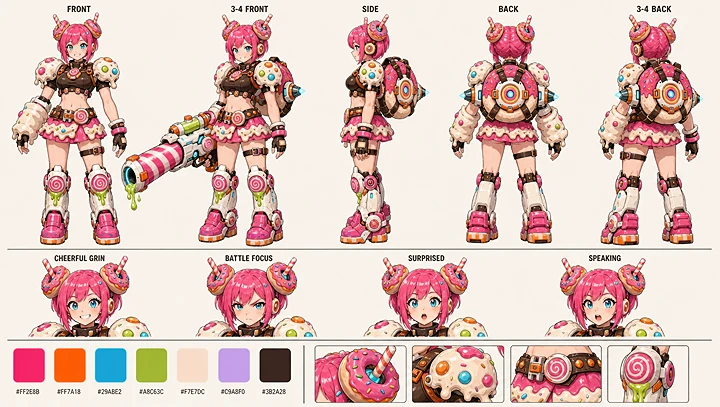
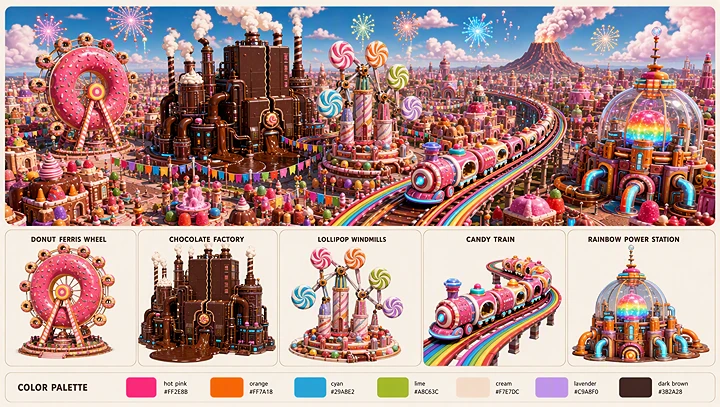
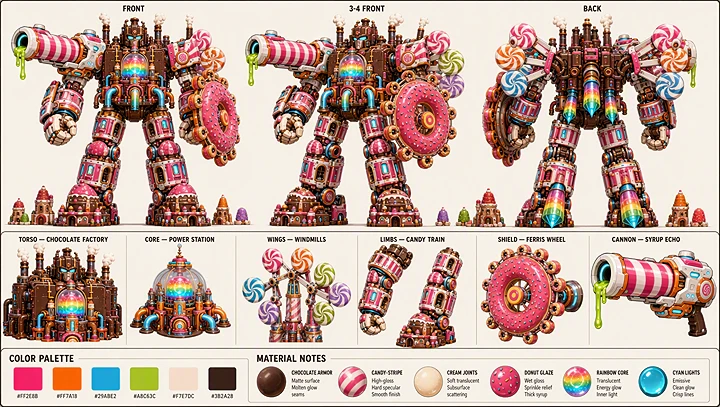
Kolorowemu Candy Kingdom grozi narastające niebezpieczeństwo, a bohaterka SUGAR POP musi obronić miasto, zanim jego punkty orientacyjne złożą się w ogromny Candy Super Mecha.
Trzy arkusze określają wygląd bohaterki, otoczenie Candy Kingdom wraz z punktami orientacyjnymi oraz złożonego mecha. Prompt wymaga od obu modeli zachowania tych projektów i wygenerowania pełnej historii akcji o długości 30 sekund.
Tekst na wideo · 30 s · 16:9
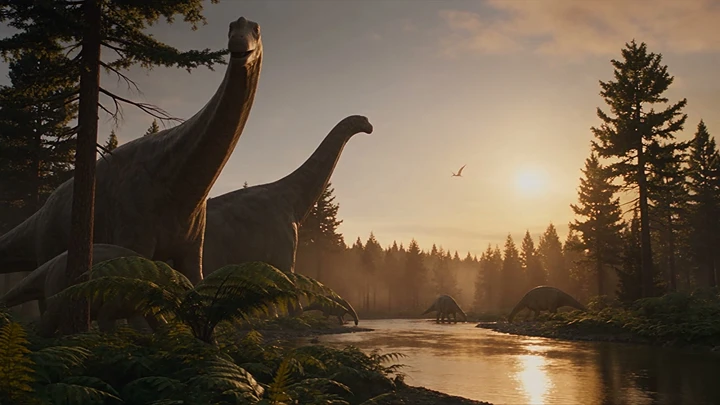
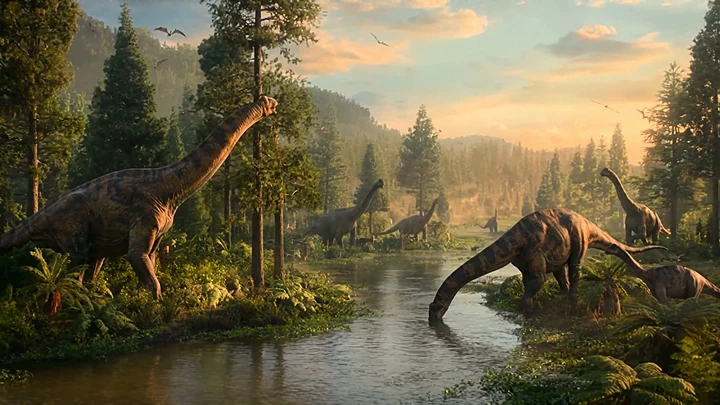
Dokument przyrodniczy pokazuje ostatnie chwile prehistorycznego ekosystemu: od spokojnej doliny pełnej dinozaurów do katastrofalnego uderzenia, fali uderzeniowej, erupcji wulkanów i Ziemi pokrytej popiołem.
Prompt łączy precyzyjnie odmierzony angielski voice-over z dokumentalną pracą kamery, wielkoskalowymi zdarzeniami środowiska, realistycznym ruchem zwierząt i cichym zakończeniem z orbity.
Tekst na wideo · 30 s · 16:9
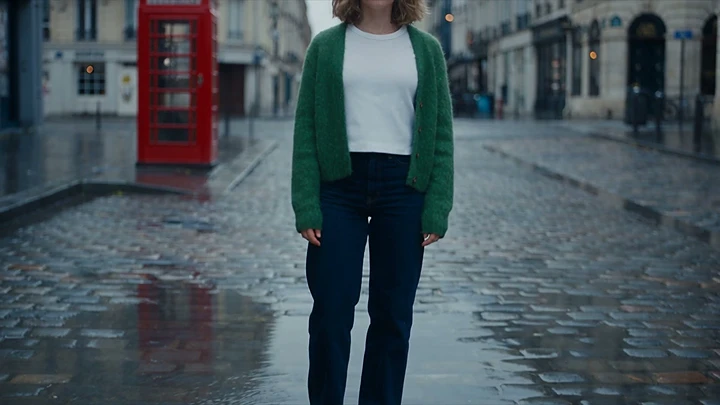
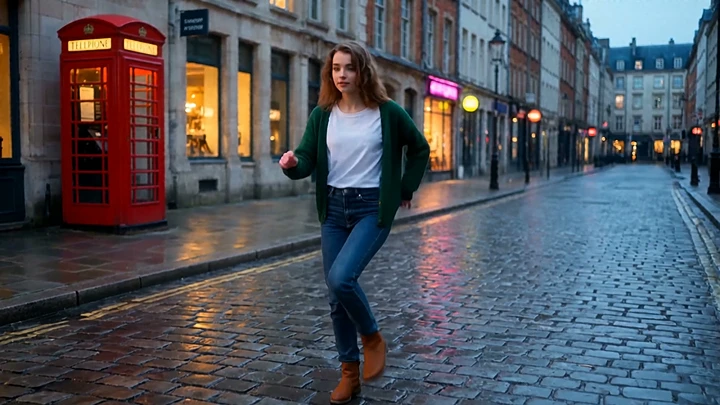
Tancerka wykonuje jedną ciągłą sekwencję, przechodząc przez kilka światów wizualnych. Wideo zaczyna się na realistycznej europejskiej ulicy, a potem przechodzi w cyberpunk, czarno-białe kino nieme, animację 3D i styl malarstwa olejnego.
Każda transformacja zmienia otoczenie i strój, a tożsamość tancerki, choreografia i rytm muzyczny mają pozostać spójne. Sekwencja kończy się tym, że wszystkie cztery alternatywne światy pojawiają się razem w jednej kompozycji.
Wiele referencji · 3 obrazy · 15 s · 16:9
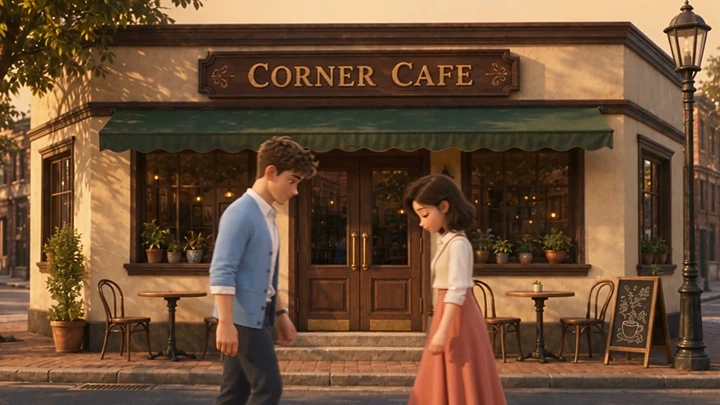
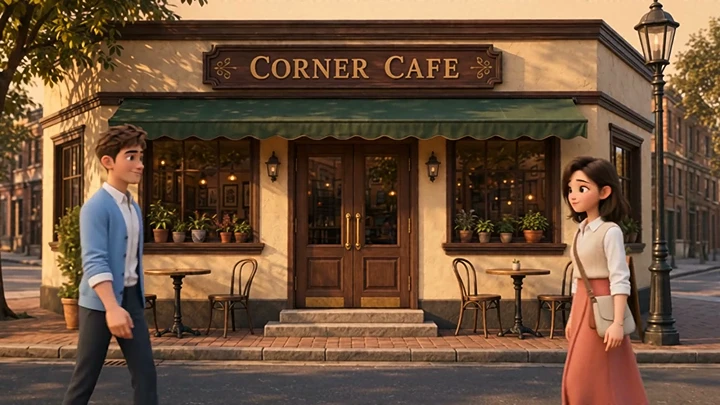
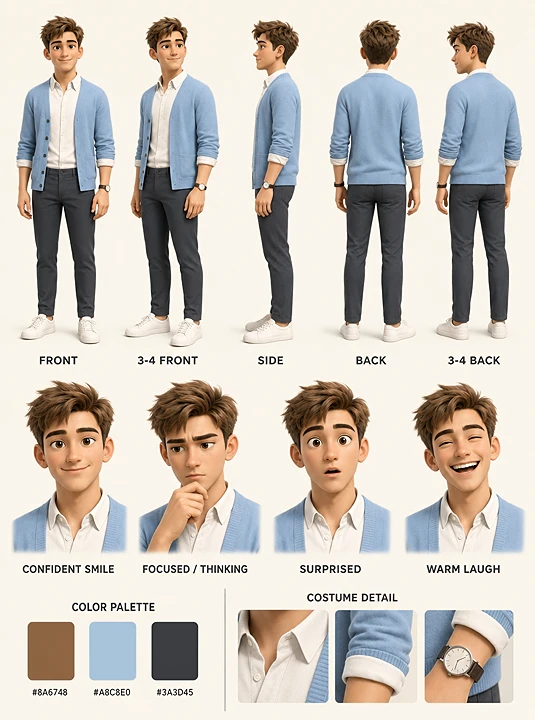
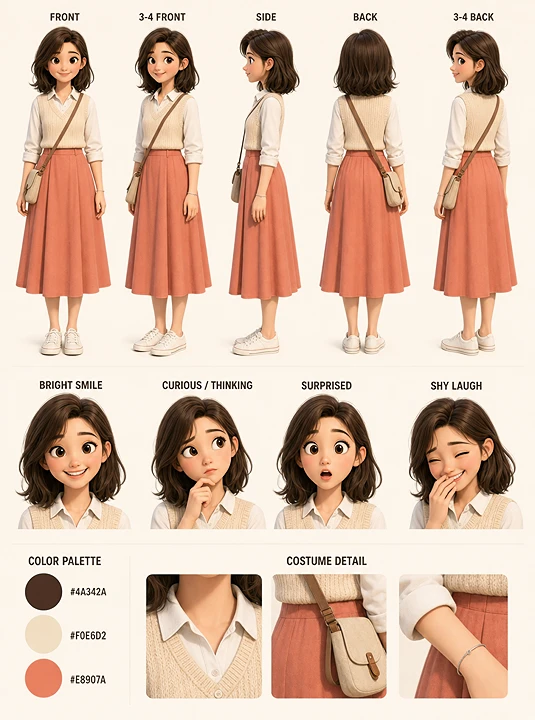
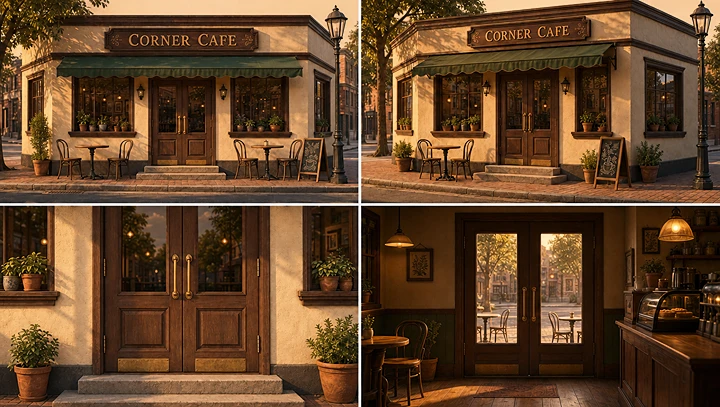
Dwie stylizowane postacie animowane, HAORAN i XIAOYU, niespodziewanie spotykają się przed kawiarnią, wymieniają cztery angielskie kwestie i razem wchodzą do budynku.
Trzy obrazy referencyjne określają postacie i otoczenie kawiarni. Prompt wymaga dokładnego dialogu, naturalnej mimiki, spójnych projektów postaci i konkretnego otwarcia drzwi.
Tekst na wideo · 15 s · 16:9
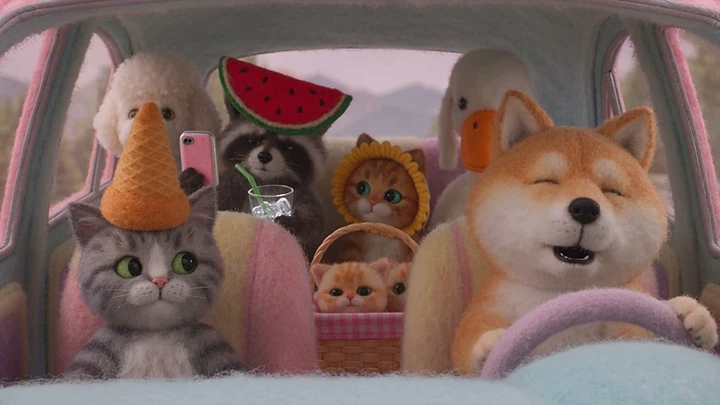
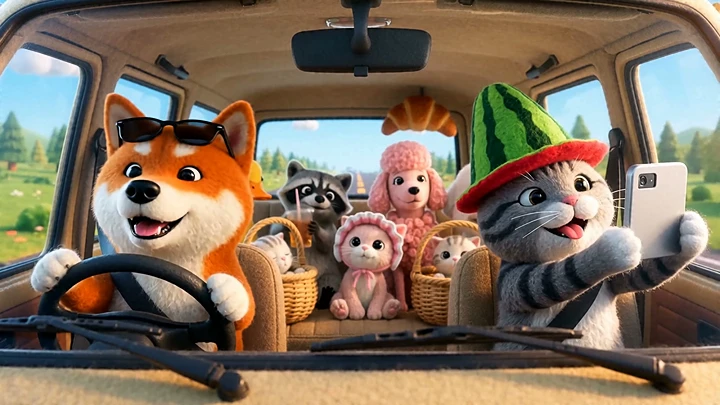
Grupa wyrazistych pluszowych zwierząt wyrusza razem w chaotyczną podróż. W jadącym pojeździe każda postać wykonuje inne działanie, a niespodziewane zdarzenia uruchamiają łańcuch komicznych reakcji.
W scenie są śpiewający kierowca shiba inu, kot robiący selfie, kaczka wchodząca w kadr, przesuwane czapki, podskakujący pasażerowie, latające przedmioty i zgrane reakcje grupy.
Prompt wymaga stałego kąta kamery i spójnego renderu pluszowo-filcowego przez 15 sekund.
Wiele referencji · 1 obraz + dźwięk · 15 s · 9:16
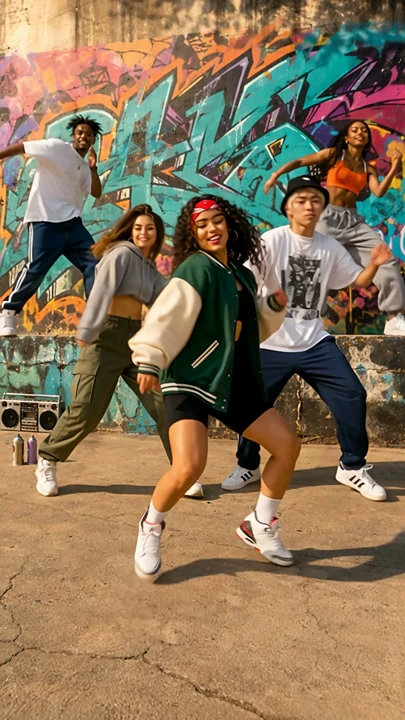
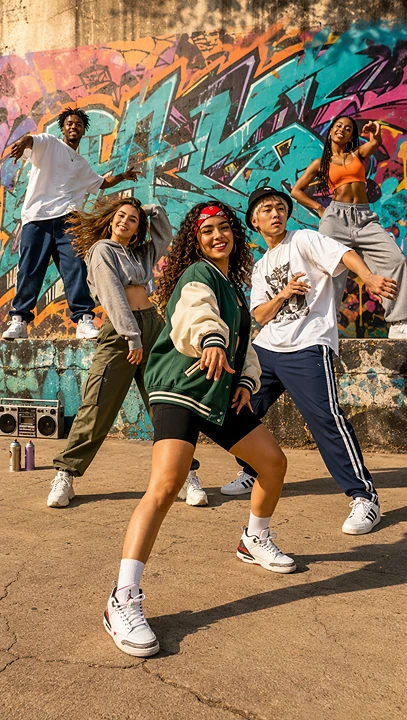
Pięcioro tancerzy wykonuje zgrany układ tańca ulicznego na placu pokrytym graffiti. Obraz referencyjny określa ich wygląd, a referencja dźwiękowa prowadzi choreografię.
Układ zaczyna się w szyku V, a potem przechodzi w poziomą linię. Prompt wymaga, aby wszystkie pięć osób zachowało tożsamość, dokończyło zmianę szyku i zsynchronizowało ruch z oryginalną muzyką w jednym ciągłym ujęciu.
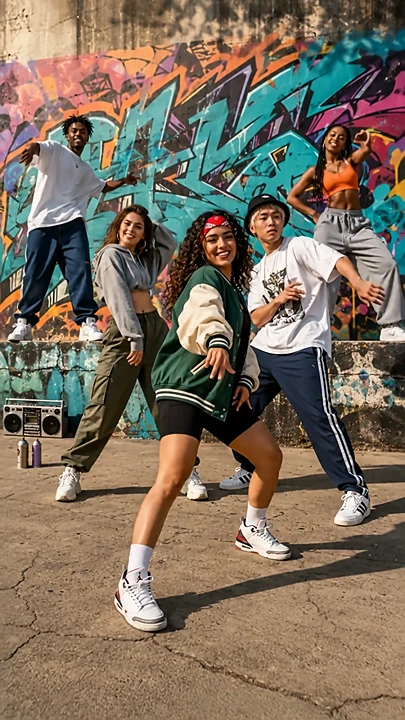
Tekst na wideo · 15 s · 16:9
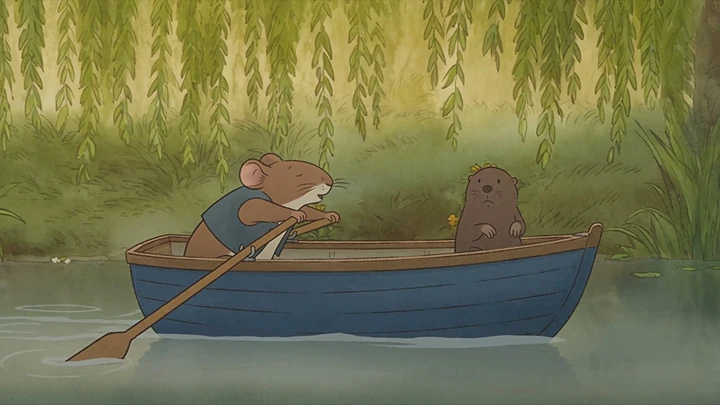
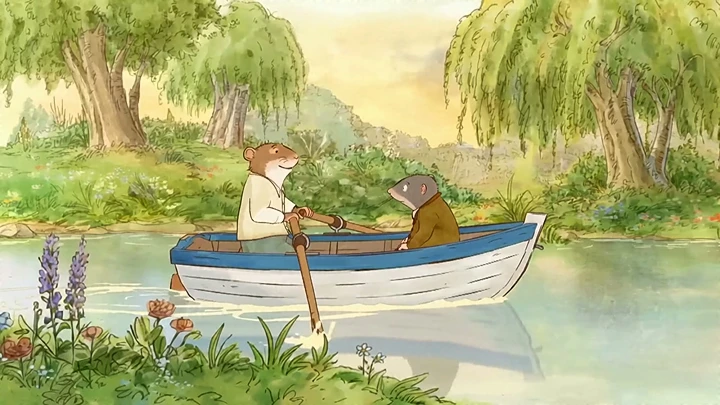
Krótka scena z książki Kenneth Grahame The Wind in the Willows została przeniesiona do animacji w stylu edwardiańskiej akwareli.
Szczur wodny wiosłuje niebiesko-białą łodzią po spokojnej rzece, a kret siedzi na rufie. Gdy rozmowa pochłania szczura, łódź uderza w brzeg, wioślarz przewraca się do tyłu i potem się podnosi.
Test wymaga od obu modeli odtworzenia konkretnej sekwencji literackiej przy zachowaniu ról postaci, działań fizycznych i spójnego wyglądu ilustracji.
Te dziewięć porównań obok siebie pokazuje, jak Seedance 2.5 i Wan 3 odpowiadają na konkretne briefy. Wyniki mogą się różnić między generacjami, ustawieniami i referencjami. Werdykty porównawcze należy opierać na pokazanych wynikach i udokumentowanych kryteriach oceny.
Nasz sposób oceny sprawdza, czy każdy wynik rozwiązuje pierwotne zadanie kreatywne.
Każde porównanie używa tego samego zamierzonego promptu i materiałów źródłowych. Jeśli ustawienie jest niedostępne w jednym modelu, tę różnicę należy udokumentować, a nie traktować warunków testu jako identycznych.
Sprawdzamy, czy w wyniku pojawiają się żądane podmioty, działania, kolejność scen i zakończenia. Brak kluczowych zdarzeń liczy się jako ograniczenie, nawet gdy wideo wygląda na dopracowane.
W przypadkach prowadzonych obrazem porównujemy postacie, produkty, stroje, rekwizyty i miejsca z materiałem źródłowym. Dokładniejsze odtworzenie nie jest tym samym co atrakcyjniejsza stylizacja.
Oglądamy tory kamery, ruch ciała, interakcje z przedmiotami i związek między kolejnymi ujęciami.
Szukamy dryfu tożsamości, gwałtownych resetów i niespójnych relacji przestrzennych.
W przypadkach prowadzonych dźwiękiem sprawdzamy wypowiedziane słowa, przypisanie mówcy, synchronizację ust, sygnały dźwiękowe i zgranie z bitem, gdy odpowiednie pliki źródłowe są dostępne.
Wiarygodne porównanie wydajności wymaga rejestrów wysłania każdej próby, w tym nieudanych generacji, powtórzeń i odrzuceń moderacji.
Zaplanowany benchmark używa trzech generacji na model przy prostszych zadaniach i pięciu generacji na model przy zadaniach bardziej złożonych, łącznie 74 próby generowania dla obu modeli.
Każde ukończone wideo jest oceniane niezależnie według wcześniej określonej rubryki.
Aby nie wybierać tylko wizualnie atrakcyjnych wyników, reprezentatywny wynik benchmarku jest wybierany według bliskości do mediany ślepej oceny jakości dla danego modelu i scenariusza.
Różne modele mogą różnie odczytać identyczne instrukcje.
Jeden wynik może być mocniejszy w kompozycji, a inny dokładniej zachować postać albo działanie. Najlepszy model do projektu to ten, który spełnia wymagany poziom jakości przy akceptowalnym koszcie.
Porównuj te same ustawienia wyjścia, a nie tylko najniższą podaną stawkę.
Oba modele korzystają z kredytów Topview, ale rzeczywiste obciążenie zależy od wybranego wariantu modelu, procesu, czasu trwania, rozdzielczości i planu konta.
Wycena kredytów w generatorze przed wysłaniem jest najistotniejszą liczbą dla Twojego projektu.
| Rozdzielczość | Seedance 2.5 w Topview | Wan 3.0 w Topview |
|---|---|---|
| 480p | 0.70 kredytu/s | 0.30 kredytu/s |
| 720p | 1.50 kredytu/s | 0.50 kredytu/s |
| 1080p | 3.70 kredytu/s | 1.00 kredytu/s |
Jeśli wynik wymaga kilku prób, zanim będzie użyteczny, rzeczywisty koszt produkcji obejmuje te próby.
Porównuj sumę zużytych kredytów, jakość wyjścia i liczbę akceptowalnych wyników, a nie tylko podaną cenę za sekundę.
Seedance 2.5 · Wan 3.0
Lepsze wideo AI zaczyna się od modelu właściwego do zadania.
Wybierz Seedance 2.5 do prowadzenia opartego na referencjach i szczegółowej kontroli albo sprawdź Wan 3.0, gdy brief mieści się w dostępnych wejściach i chcesz porównać koszt generowania.
Zostaw ten sam prompt i te same referencje, obejrzyj wyniki i wybieraj na podstawie rezultatu, a nie samej nazwy modelu.
Złożone sceny akcji mocno obciążają generowanie wideo AI. Model musi utrzymać spójne postacie, rozumieć względną skalę, zachować relacje przestrzenne i zgrać wiele działań w czasie. Test sprawdza, czy wizualnie ambitna walka pozostaje logicznie czytelna.
Wan 3.0 lepiej trafia w arkusze referencyjne w tej walce. Otwarcie utrzymuje czytelne białe podwójne kucyki, czapkę z kocimi uszami, żółtą kurtkę i działo na tle granatowego mecha, różowego grzebienia, żółtego wizjera i różowego rdzenia na piersi. Późniejsza klatka pokazuje rakiety w powietrzu, zanim bohaterka wraca na pancerz. Seedance 2.5 wygrywa odczyt skali w ujęciu pięści, gdzie jest maleńka przy dłoni, ale potem schodzi na poziom ulicy, a twarzy i broni trudno sprawdzić, gdy kamera się oddala. Seedance kończy różowym błyskiem, a strzelająca postać jest obcięta. Wan kończy tym, że jest mała na tle wizjera. Wybierz Wan 3.0, gdy arkusze postaci i bit z rakietami mają zostać rozpoznawalne. Wybierz Seedance 2.5, gdy kontrast olbrzyma i maleńkiej postaci jest ważniejszy niż czyste trafienie w referencję.
Generowanie z wielu referencji wymaga, aby model rozumiał, jak osobne wejścia wizualne się do siebie odnoszą. Poza odtworzeniem pojedynczych obiektów musi zachować tożsamość, połączyć elementy projektu i utrzymać spójny świat przy zmianie scen.
Ten test pomaga ocenić, jak niezawodnie każdy model przekłada kilka obrazów referencyjnych na dłuższe, uporządkowane wideo.
Seedance 2.5 daje mocniejszy wynik przy wielu referencjach. Zbliżenie zachowuje różowe bob Sugar Pop, niebieskie oczy i cukierkowe spinki. W środku klipu osobno startują cukierkowe punkty orientacyjne. Szeroki robot trafia w arkusz mecha: pasiaste działo na ramieniu, tarcza z pączka na przedramieniu i cukierkowe kończyny w jednym ciele. Zakończenie to barwna wiązka, a robot nadal jest w kadrze. Wan 3.0 otwiera się wyraźniejszym Candy Kingdom: diabelski młyn, wulkan i cukierkowe ulice. To ten klip pokazuje potwora z deserów nad miastem. Późniejsze klatki zostają przy cukierkowym pociągu i rozmytej twarzy robota, więc złożony mech nie spina się tak, jak wskazuje arkusz. Wybierz Seedance 2.5, gdy w jednym wideo mają przetrwać postać, złożenie i gotowy mech. Wybierz Wan 3.0, gdy najpierw mają być czytelne królestwo i potwór.
Dokumentalne generowanie wideo zależy od dokładnego przekazu, nie tylko od kinowego obrazu. Narracja, timing scen, opowieść wizualna i ciągłość środowiska muszą działać razem i przekazać pełną sekwencję.
Ten test sprawdza, jak każdy model zgrywa mówioną narrację ze złożonymi zdarzeniami wizualnymi przez 30 sekund.
Wan 3.0 dalej prowadzi historię obrazem. Klatki idą od złotej doliny rzeki do czołowej paniki pod ścianą pyłu, erupcji, powalonego zwierzęcia w popiele i szarej Ziemi na orbicie. Seedance 2.5 też przechodzi od nasłonecznionej doliny do biegnącego stada, powodzi z małym stegozaurem i popielatoszarego zauropoda, ale jeszcze głęboko w klipie zostaje w spokojnej dolinie, a ostatnia wybrana klatka to jednolita szarość, nie orbita. Powódź i małe zwierzę na tle krajobrazu są wyraźniejsze u Seedance. Te klatki nie potwierdzają brzmienia, tempa ani pauz mówionego tekstu. Wybierz Wan 3.0, gdy wideo ma dojść do załamania i zakończenia z orbity. Wybierz Seedance 2.5, gdy dolina i powódź mają zostać naturalistyczne, a potem sprawdź, czy Twoja własna generacja dochodzi do orbity.
Zmiana stylu wymaga od modelu oddzielenia wyglądu od tożsamości i ruchu. Otoczenie i opracowanie plastyczne mogą zmieniać się gwałtownie, ale postać i działanie muszą pozostać czytelne.
Ten test sprawdza, jak każdy model prowadzi skoordynowane transformacje przez kilka stylów w jednej ciągłej sekwencji.
Seedance 2.5 pokrywa więcej żądanych światów. Próbki pokazują mokrą europejską ulicę i zielony kardigan, neonowy strój cyberpunk, kadr kina niemego w czarno-białym letterboksie, zwrot w malarstwo olejne z gwiaździstym niebem i niebieską suknią, a potem pierwotny wygląd otoczony czterema osobnymi panelami. Wan 3.0 wyraźniej tańczy na ulicy i w cyberpunku, a bit animacji 3D w żółtej sukni jest pełną sceną, nie obrazkiem wewnątrz panelu. Świat kina niemego nie pojawia się w próbkach Wan, a zakończenie to cztery osobne obrazy zamiast jednego plakatu z tancerką w środku. Wybierz Seedance 2.5, gdy sens briefu leży w liście stylów i zakończeniu z czterema światami. Wybierz Wan 3.0, gdy czytelna choreografia i świat kreskówki są ważniejsze niż fragment kina niemego.
Sceny dialogowe łączą kilka wymagających zadań: generowanie mowy, synchronizację ust, spójność postaci, grę emocjonalną i skoordynowaną interakcję fizyczną.
Przekonujący wynik zależy od tego, czy te elementy działają razem. Test pomaga ocenić, jak skutecznie każdy model prowadzi opowieść przez postacie.
Oba klipy trzymają projekty z referencji: niebieski kardigan, kremowa kamizelka, łososiowa spódnica i markiza Corner Cafe. Usta są otwarte podczas rozmowy, ale stopklatki nie potwierdzają czterech kwestii ani prawdziwej synchronizacji ust. Widoczna różnica to drzwi. Ostatnia klatka Wan 3.0 pokazuje, jak trzyma mosiężną klamkę, gdy ona przechodzi przez otwarte drzwi. Seedance 2.5 prowadzi parę do wejścia i do środka, bez wyraźnego momentu, w którym drzwi są przytrzymane otwarte na zewnątrz. Wybierz Wan 3.0 do tego briefu, gdy działanie przy wejściu ma trafić w prompt. Każdy z modeli wystarczy, gdy priorytetem jest spójność dwóch postaci i kawiarni. Zanim zatwierdzisz ujęcie, odsłuchaj kwestie.
Gra wielu postaci sprawdza, czy model potrafi prowadzić kilka niezależnych działań we wspólnym otoczeniu.
Wyzwanie nie polega tylko na wygenerowaniu wielu postaci naraz, ale na zachowaniu ich tożsamości, zgraniu interakcji i utrzymaniu logicznych związków przyczynowo-skutkowych w scenie.
Seedance 2.5 trzyma zablokowane wnętrze. Ten sam widok przez przednią szybę utrzymuje shiba inu za kierownicą z otwartym pyskiem, kota w czapce-arbuzie i kaczkę. Szyja kaczki wysuwa się do przodu, ale zamiana czapek, złapanie winogrona i końcowy kciuk w górę nie są widoczne. Wan 3.0 pokazuje więcej tych gagów: rogal na głowie, pudel przyciśnięty do białego psa, naburmuszony kociak w koszu i kciuk w górę od kierowcy. Kamera schodzi jednak ze stałego kąta: z całego wnętrza na tylne siedzenie i do kosza, a czapki i miejsca się przetasowują. Wybierz Seedance 2.5, gdy liczą się jedna stała kamera i stabilna obsada. Wybierz Wan 3.0, gdy komiczny łańcuch reakcji jest ważniejszy niż jeden nieprzerwany kąt.
Generowanie tańca wymaga precyzyjnego zgrania ruchu, tożsamości postaci, pozycji grupy i timingu dźwięku.
Atrakcyjna sekwencja tańca i tak może nie wyjść, jeśli wykonawcy gubią synchronizację albo szyk zmienia się nieprawidłowo. Test sprawdza, czy każdy model potrafi zgrać kilka podmiotów z zewnętrzną referencją muzyczną.
Wan 3.0 na początku jest bliżej zdjęcia referencyjnego: pięcioro tancerzy, zielona kurtka varsity z przodu i postawa zbliżona do V przy ścianie z graffiti. W połowie ta grupa znika i plac wypełnia jedna osoba, a późniejsza klatka wraca z luźniejszym tłumem. Seedance 2.5 trzyma grupę w każdej próbce, w tym zieloną kurtkę, ale późniejsze klatki dodają osoby i nie pokazują czystej zmiany ze startowego V w jedną poziomą linię tej samej piątki. Stopklatki nie potwierdzają, że którykolwiek klip trzyma oryginalny bit albo zostawia dźwięk bez zmian. Wybierz Seedance 2.5, gdy wszyscy tancerze mają zostać w kadrze. Wybierz Wan 3.0, gdy pierwsze ujęcie ma trafić w referencję, a potem obejrzyj środek klipu, zanim przyjmiesz zmianę szyku.
Adaptacja literacka wymaga, aby model przełożył pisemną opowieść na czytelną sekwencję wizualną.
Wyzwanie nie polega tylko na atrakcyjnych ilustracjach. Wynik powinien zachować role postaci, związki przyczynowo-skutkowe i istotne zdarzenia, po których rozpoznaje się oryginalną scenę.
Ten test pomaga ocenić, jak wiernie każdy model przekłada szczegółowy fragment literacki na krótkie wideo.
Seedance 2.5 dalej podąża za fragmentem. Szczur wiosłuje, kret siedzi na rufie, potem szczur leży na plecach z nogami w górze i znów siada. Łódź czyta się jako jednolicie niebieska, a nie niebieska na zewnątrz i biała w środku, a uderzenie dziobu w brzeg jest sugerowane upadkiem, nie pokazane. Wan 3.0 lepiej trafia w łódź: niebieska na zewnątrz, biała w środku, i stabilniej trzyma edwardiańską akwarelę, gdy wiosłują pod wierzbami. Późne klatki przechylają łódź ku kwiatom, a potem wracają do spokojnego wiosłowania, więc brakuje upadku piętami do góry i podniesienia się. Wybierz Seedance 2.5, gdy zderzenie i przewrócenie mają być czytelne. Wybierz Wan 3.0, gdy namalowana łódź i cicha rzeka są ważniejsze niż pointa.
"Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)
Źródło oryginału: Kenneth Grahame, The Wind in the Willows (1908), rozdział I. Tekst w domenie publicznej jest dostępny przez Project Gutenberg.