Seedance 2.5 vs MiniMax H3
Dwa modele wideo AI w jednym obszarze roboczym Topview. Porównaj długość, rozdzielczość, referencje multimodalne, natywny dźwięk oraz dostęp otwarty i hostowany, a potem wybierz model pasujący do projektu.
Obok siebie
Ten sam prompt, dwa modele
Dla każdego briefu poniżej ten sam prompt i te same referencje wejściowe (jeśli zostały użyte) przechodzą przez Seedance 2.5 i MiniMax H3 — bez powtórnych generowań. Obejrzyj oba wyniki i oceń je samodzielnie.
Porównanie widowiskowych efektów VFX
Tylko tekst
Prompt
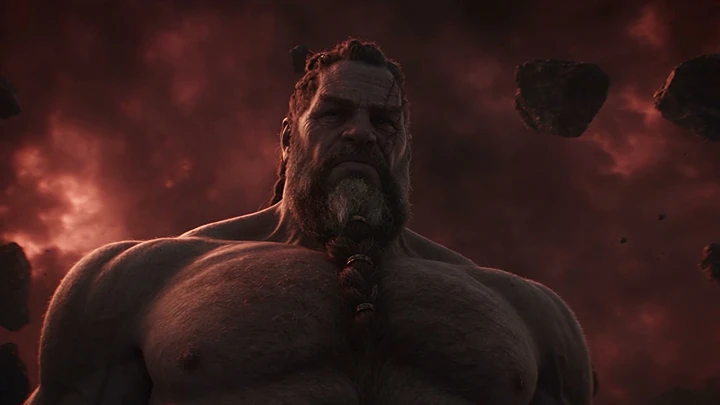
Porównanie sceny dialogowej
3 obrazy
Referencja obrazu 1
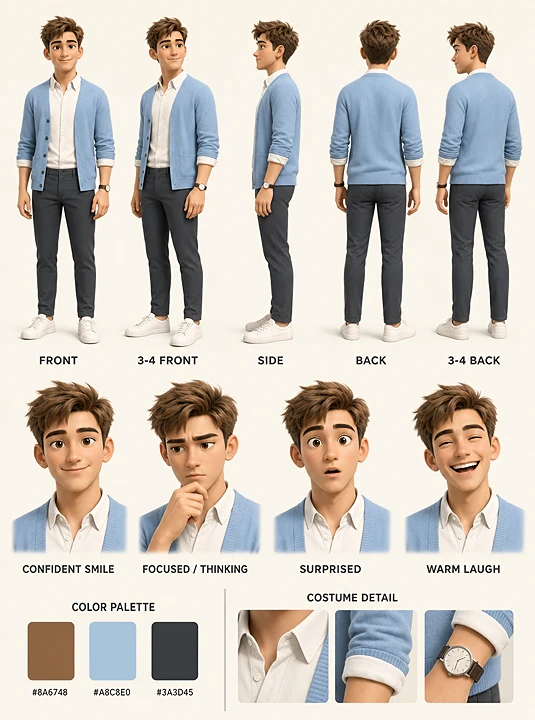
Referencja obrazu 2
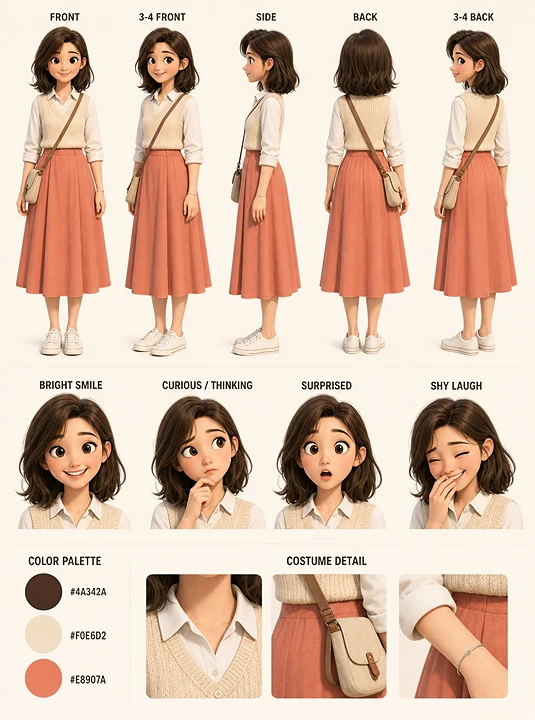
Referencja obrazu 3
Prompt
Porównanie zespołowej gry aktorskiej
Tylko tekst
Prompt
Porównanie tańca grupowego i synchronizacji z rytmem
1 obraz + audio
Referencja obrazu 1
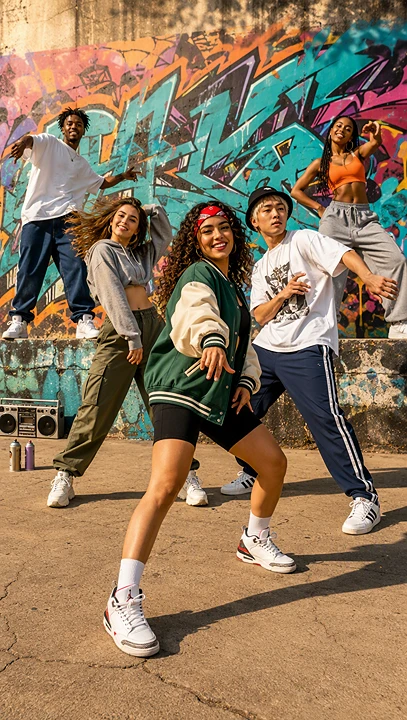
Referencja audio
Referencja ścieżki rytmicznej
Prompt
Porównanie adaptacji literackiej
Tylko tekst
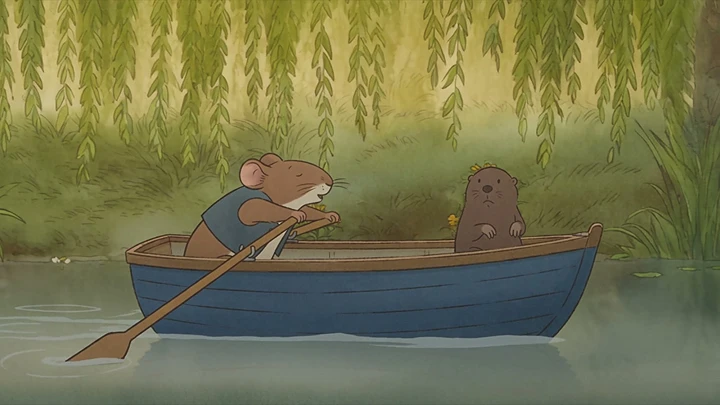
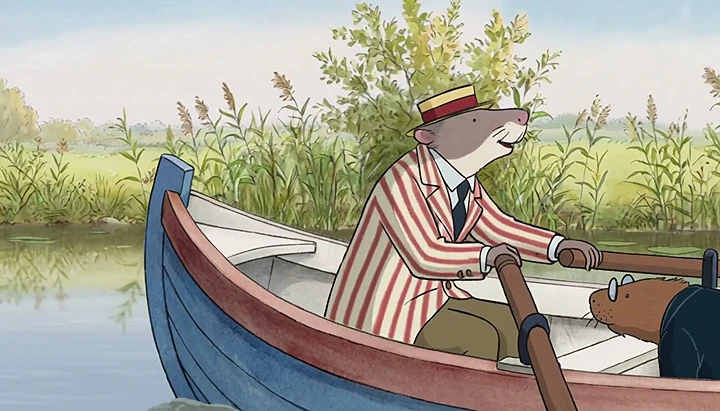
Wierna adaptacja powieści „O czym szumią wierzby” (1908), rozdz. I — oceń każdy model względem oryginalnego fragmentu pokazanego obok.
Prompt
Oryginalny fragment
"Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)
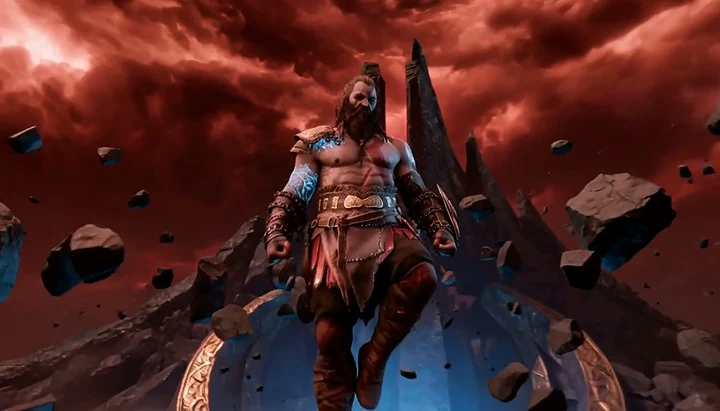
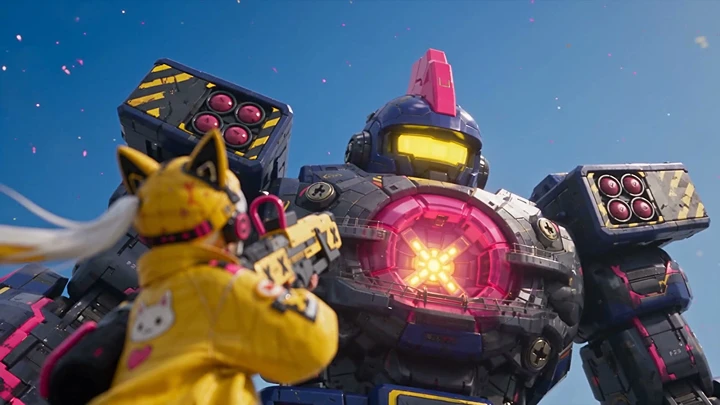
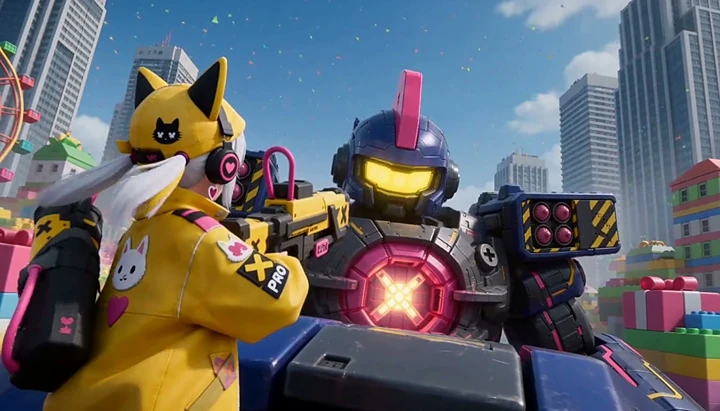
Porównanie walki z bossem w grze
2 obrazy
Referencja obrazu 1
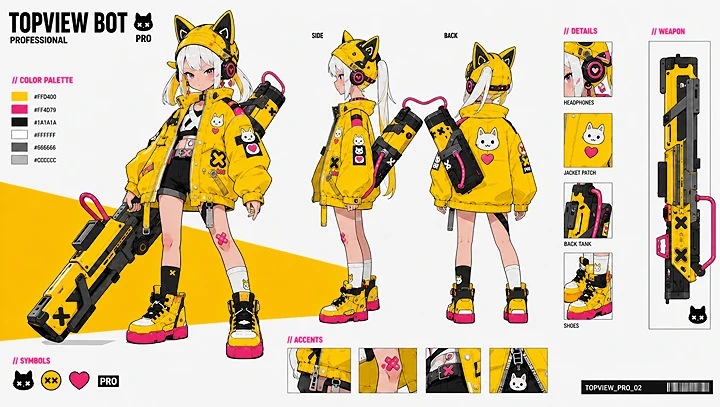
Referencja obrazu 2
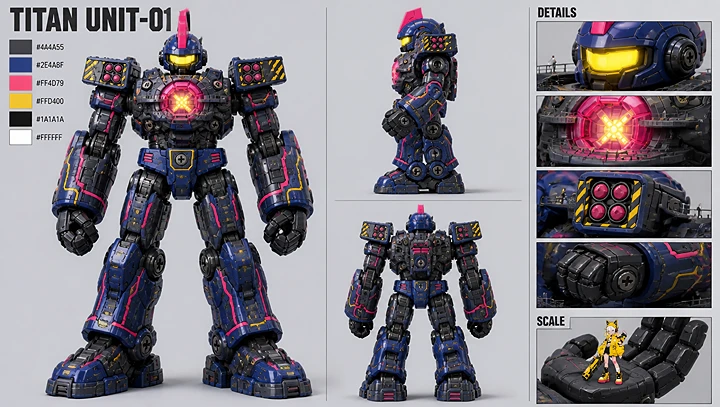
Prompt
Porównanie parametr po parametrze
Każda wartość odzwierciedla sposób udostępnienia modelu na Topview oraz publicznie dostępne informacje jego twórcy — bez wyników benchmarków i deklaracji z testów ślepych, po prostu fakty obok siebie.
| Parametr | Seedance 2.5 | MiniMax H3 |
|---|---|---|
| Twórca | ByteDance | MiniMax |
| Typ modelu | Multimodalny model wideo (hostowany) | Omni-Modality Transformer (otwarte wagi) |
| Wdrożenie i dostęp | Hostowany na Topview (oraz na platformach ByteDance i partnerów) | Otwarte wagi; API / otwarta platforma; gotowość do wdrożenia prywatnego / on-prem |
| Rozdzielczość (Topview) | 480p / 720p / 1080p | 768p / natywne 2K (2560×1440) |
| Długość | Natywny ciągły klip 4–30 s | 5–15 s na ujęcie |
| Wejścia obrazowe | Do 30 obrazów | Do 9 (maks. 15 łącznie ze wszystkich referencji) |
| Wejścia wideo | Do 10 klipów (łączne wideo referencyjne ≤30 s) | Do 3 klipów (maks. 15 łącznie ze wszystkich referencji) |
| Wejścia audio | Do 10 plików (łączne audio referencyjne ≤30 s) | Do 3 plików (maks. 15 łącznie ze wszystkich referencji) |
| Referencje łącznie | Do 50 zasobów | Do 15 łącznie |
| Natywny dźwięk | Dialogi, muzyka i efekty dźwiękowe ze sterowaniem w osi czasu | Dialogi + muzyka + synchronizacja ust |
| Wielojęzyczna synchronizacja ust | Wielojęzyczne dialogi; bardziej niezawodna obsługa napisów (jak na Topview) | Globalna wielojęzyczna synchronizacja ust |
| Najlepszy do | Dłuższych ciągłych historii, rozbudowanych referencji multimodalnych (do 50 łącznie), automatycznego doboru długości | Materiałów w 2K, wdrożeń otwartych / prywatnych, edycji omni-modalnej |
Powyższe wartości odpowiadają produkcyjnej konfiguracji generatora Topview dla Seedance 2.5 i MiniMax H3 (wybieralne poziomy rozdzielczości i limity referencji). Zewnętrzne deklaracje o 4K jako domyślnym wyjściu, wyniki Elo oraz ceny są wyłączone. Nie formułujemy żadnych twierdzeń o wygranej w benchmarkach.
W czym wyróżnia się każdy model
Seedance 2.5
Dłuższe ciągłe klipy
Wygeneruj spójną sekwencję od 4 do 30 sekund w jednym przebiegu — więcej miejsca na reklamy, materiały wyjaśniające i historie o kilku punktach zwrotnych, bez sklejania wielu krótkich fragmentów.
Rozbudowana kontrola multimodalna
Steruj tożsamością, ruchem i dźwiękiem za pomocą maks. 50 referencji (30 obrazów, 10 wideo, 10 audio) oraz promptów opartych na wynikach wyszukiwania internetowego.
Edycja w stylu produkcyjnym
Popraw wybrany fragment klipu o długości 4–30 s bez konieczności ponownego generowania całego ujęcia — funkcja stworzona z myślą o pracy iteracyjnej.
MiniMax H3
Natywne wyjście 2K
Generuj w natywnym 2K (2560×1440), aby uzyskać ostrzejsze kadry produktowe i reklamowe, gdy priorytetem jest rozdzielczość.
Otwarte wagi i wdrożenie prywatne
Hostuj samodzielnie, dostrajaj lub uruchamiaj on-prem, gdy rezydencja danych albo kontrola nad stosem technologicznym wyklucza wyłącznie hostowane API.
Edycja omni-modalna
Łącz wskazówki tekstowe, obrazowe, dźwiękowe i wideo z natywnymi dialogami, muzyką i synchronizacją ust, aby szybko iterować multimodalnie.
Który model pasuje do Twojego przepływu pracy?
Dopasuj projekt do modelu, który powstał właśnie do takich zadań.
Dłuższa ciągła reklama lub materiał wyjaśniający do 30 sekund
Natywne generowanie 4–30 s daje całej myśli miejsce na zawiązanie, rozwinięcie i domknięcie w jednym klipie.
Pozwolenie modelowi na automatyczne dopasowanie długości klipu do tempa narracji
Automatyczny dobór długości jest oznaczony dla Seedance 2.5 na Topview i wybiera odpowiedni czas trwania w zakresie 4–30 s bez ręcznego przycinania.
Maksymalna liczba referencji obrazu, wideo i audio
Do 50 zasobów multimodalnych wspiera złożone pakiety marki i budowania świata.
Natywne kadry produktowe lub reklamowe w 2K
Natywne wyjście 2K jest pozycjonowane pod ostrzejsze materiały, gdy w briefie prowadzi rozdzielczość.
Prywatny / on-prem lub oparty na otwartych wagach proces produkcji
Otwarte wagi i wdrożenie prywatne pasują zespołom, które nie mogą polegać wyłącznie na hostowanym API w chmurze.
Szybkie klipy multimodalne z natywną synchronizacją ust
Dialogi, muzyka i synchronizacja ust w jednym przebiegu omni-modalnym sprawdzają się w krótkich materiałach społecznościowych i testach lokalizacyjnych.
Lokalna poprawka fragmentu po udanym klipie bazowym
Edycja lokalna utrzymuje resztę sekwencji w większej stabilności, gdy poprawiasz wybrany moment.
Przepisanie omni-modalne prowadzone instrukcją (głos, ton, scena)
Edycja omni-modalna jest pozycjonowana pod przenoszenie głosu i tonu oraz przepisywanie sceny.
Najczęściej zadawane pytania
Wypróbuj oba modele na Topview
Ten sam obszar roboczy, te same referencje — wybierz model pasujący do briefu albo przepuść pomysł przez oba.