Seedance 2.5
Clips jusqu'à 30 secondes, jusqu'à 50 références combinées dans le flux Topview indiqué, et une direction détaillée du plan et de l'audio.
Quel modèle de vidéo AI devez-vous choisir ?
Seedance 2.5 et Wan 3.0 prennent tous les deux en charge des flux de vidéo AI jusqu'à 30 secondes, avec des options de sortie qui atteignent 1080p dans les flux Topview compatibles.
Le choix pratique dépend de votre brief : Seedance 2.5 mérite d'être envisagé pour les productions riches en références et les consignes de timing détaillées. Wan 3.0 mérite d'être envisagé lorsque le coût de génération à la seconde est prioritaire.
Comparez les réglages pris en charge, les vidéos côte à côte déjà disponibles et les compromis propres à chaque modèle avant de générer.
Seedance 2.5
Clips jusqu'à 30 secondes, jusqu'à 50 références combinées dans le flux Topview indiqué, et une direction détaillée du plan et de l'audio.
Wan 3.0
Clips jusqu'à 30 secondes, jusqu'à 20 références combinées dans le comparatif Topview indiqué, et des tarifs de référence publiés à la seconde plus bas pour des modes de génération sélectionnés.
Les limites et les prix dépendent du mode, du compte et des réglages de génération choisis. Vérifiez toujours le générateur en direct avant d'envoyer une tâche.
Les deux modèles associent génération vidéo et direction multimodale. Le tableau distingue la documentation au niveau du modèle des réglages indiqués pour le flux Topview.
| Dimension | Seedance 2.5 | Wan 3.0 |
|---|---|---|
| Développeur | ByteDance | Alibaba |
| Usage principal | Briefs créatifs plus longs et riches en références | Création multimodale attentive au coût de génération |
| Durée | 4s–30s, sélectionnable à la seconde | 2s–30s, sélectionnable à la seconde |
| Résolution | 480p / 720p / 1080p | 480p / 720p / 1080p |
| Rapports d'aspect | 16:9, 9:16, 3:4, 1:1, 4:3, 21:9 (plus l'option adaptative) | 16:9, 9:16, 1:1, 4:3, 3:4 |
| Texte vers vidéo | Pris en charge | Pris en charge |
| Image vers vidéo | Pris en charge | Pris en charge |
| Guidage vidéo et audio | Pris en charge dans les flux compatibles | Pris en charge dans les flux compatibles |
| Références image | Jusqu'à 30 | Jusqu'à 10 |
| Références vidéo | Jusqu'à 10 | Jusqu'à 5 |
| Références audio | Jusqu'à 10 | Jusqu'à 5 |
| Références combinées | Jusqu'à 50 | Jusqu'à 20 |
| Génération audio | Disponible dans les flux compatibles | Disponible dans les flux compatibles |
| Timing et direction de scène | Consignes horodatées et choix de la durée à la seconde | Indications de plan et de scène, selon le flux |
| Prix | Les crédits varient selon la résolution, la durée, le mode et l'offre P. ex. 1.5 crédits/s en 720p | Les crédits varient selon la résolution, la durée, le mode et l'offre P. ex. 0.5 crédits/s en 720p |
| Adapté à | Récit riche en références et direction créative détaillée | Génération attentive au coût et briefs créatifs ciblés |
Les limites de référence reflètent les réglages actuellement indiqués dans le comparatif de Topview, et non une garantie pour chaque fournisseur ou chaque compte. Consultez le générateur pour les réglages disponibles. Les prix des offres sont sur la .
Partez du type de vidéo dont vous avez besoin, pas du nom du modèle. Ces recommandations portent sur l'adéquation au flux. Elles n'affirment pas qu'un modèle produit toujours des vidéos plus belles.
Seedance 2.5 et Wan 3 prennent en charge la génération de vidéo AI jusqu'à 30 secondes, mais leurs avantages diffèrent. Choisissez Seedance 2.5 pour les projets riches en références, le timing précis et une direction audio détaillée. Envisagez Wan 3 pour une production attentive au coût, des récits plus longs en plan unique et une création de scène guidée par des références.
Rassemblez des briefs créatifs complexes avec jusqu'à 50 fichiers de référence : 30 images, 10 vidéos et 10 fichiers audio. Guidez l'identité du personnage, les détails du produit, le mouvement, les environnements et le son dans un seul flux de génération. Wan 3 n'accepte que 20 références.
Utilisez des vidéos et des fichiers audio de référence jusqu'à 30.2 secondes chacun, dans la limite de durée combinée du flux. Guidez le mouvement, le rythme et le son avec des prises de mouvement plus longues ou des références musicales.
Choisissez une durée de 4 à 30 secondes, par paliers d'une seconde. Utilisez des consignes horodatées pour planifier les plans, les actions, les transitions et le rythme de la scène dans une vidéo continue.
Dirigez le dialogue, la musique de fond et les effets sonores avec des consignes horodatées. Coordonnez la parole, l'action et l'atmosphère avec une génération audio native dans un seul flux.
Wan 3.0 indique 0.30 crédits/s en 480p, 0.50 en 720p et 1.00 en 1080p, contre 0.70, 1.50 et 3.70 crédits/s pour Seedance 2.5 dans les tarifs de référence publiés sur Topview. Vérifiez le devis réel en crédits avant de générer, car les tarifs dépendent du flux et de l'offre choisis.
Générez une séquence vidéo continue jusqu'à 30 secondes, sans assembler plusieurs clips courts. Cela convient aux révélations de produit, aux mouvements de caméra sans coupure et aux histoires de marque qui gagnent à un seul plan fluide.
Utilisez Omni Reference pour guider l'identité des personnages, les accessoires et les environnements sur un récit plus long. Gardez l'univers créatif ancré aux références visuelles pendant que vous développez scènes et actions.
Utilisez la recherche de références assistée par internet pour appuyer la création vidéo avec du matériel visuel et contextuel supplémentaire, lorsque cette fonction est disponible dans votre flux Topview.
Le même brief. Deux modèles de vidéo AI. Neuf situations réelles.
Comment Seedance 2.5 et Wan 3 se comparent-ils lorsqu'ils reçoivent les mêmes consignes créatives ? Parcourez neuf tests vidéo côte à côte : VFX cinématographiques, action complexe, références multimodales, récit documentaire, changements de style, dialogue, interaction entre personnages, synchronisation de danse et adaptation littéraire.
Chaque comparaison présente les sorties des deux modèles avec le prompt d'origine et les fichiers de référence, lorsqu'il y en a. Regardez comment chaque modèle traite le même défi créatif, examinez les détails qui comptent et voyez quel modèle convient le mieux à chaque type de projet.
Texte vers vidéo · 30s · 16:9
Un dieu nordique plane au-dessus d'un sanctuaire d'obsidienne fracturé pendant que des éclairs dorés, des débris flottants et des runes lumineuses montent vers un climax explosif. La caméra effectue une orbite continue de 360 degrés pendant que le personnage invoque un énorme marteau de combat et libère une puissante onde de choc.
Ce test demande aux deux modèles de combiner des effets visuels complexes, le mouvement du personnage, une direction de caméra dynamique et une séquence d'action continue dans une seule vidéo de 30 secondes.
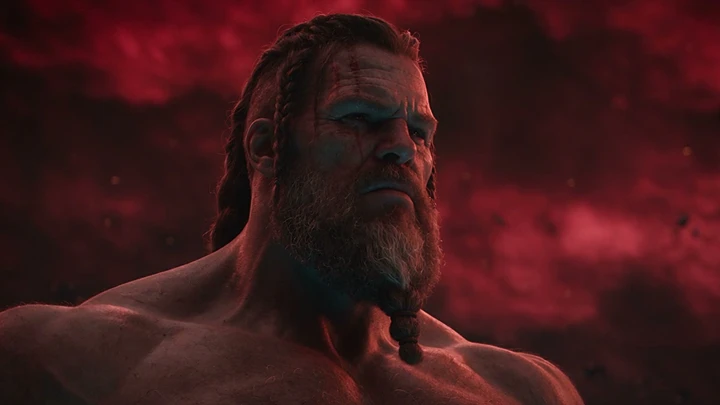
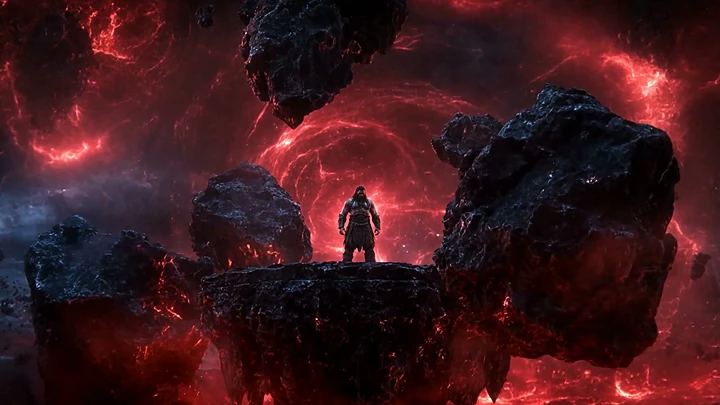
La génération de VFX cinématographiques exige plus que des images isolées impressionnantes. Le modèle doit coordonner le mouvement de caméra, les actions du personnage et les effets visuels tout en gardant une séquence cohérente. Ce test montre comment chaque modèle traite des scènes visuellement complexes, avec plusieurs actions qui dépendent les unes des autres.
Seedance 2.5 tient mieux ce brief. Tout au long du clip, un même dieu barbu reste sur un même sommet fracturé : un gros plan solennel, le même visage aux yeux lumineux, des éclairs qui s'accumulent sur le sanctuaire, puis la figure en l'air avec un marteau. Wan 3.0 produit des effets isolés plus forts, un portail rouge, une tempête de débris, une explosion dorée et un cercle de runes bleu, mais le dieu disparaît au milieu du clip et le marteau apparaît comme une pose après l'explosion, et non comme une fusion que l'on peut suivre. Les images échantillonnées ne montrent pas une orbite de 360 degrés complète, pour aucun des deux modèles. Choisissez Seedance 2.5 lorsqu'un personnage et un lieu doivent monter jusqu'au marteau. Choisissez Wan 3.0 lorsqu'un plan d'effets spectaculaire compte plus que le même visage et le même sanctuaire.
Multiréférence · 2 images · 30s · 16:9
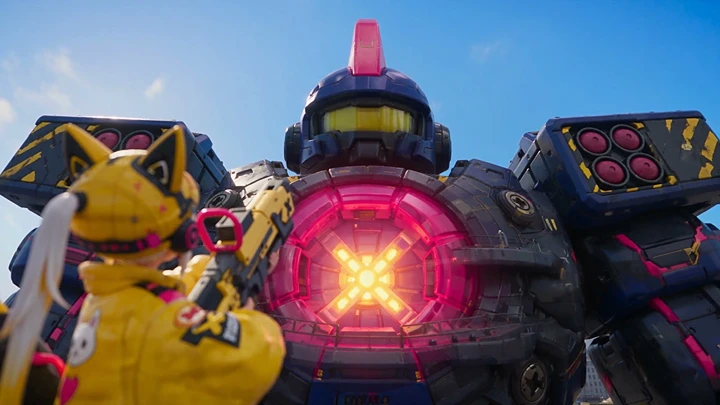
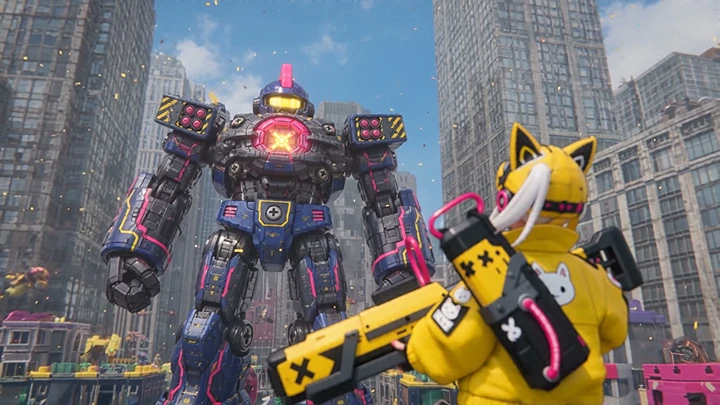
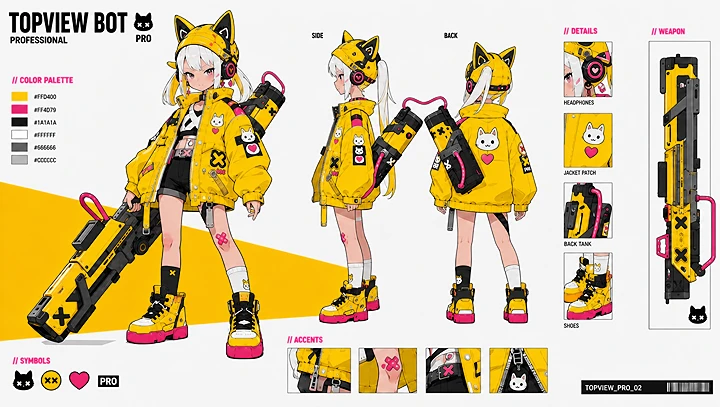
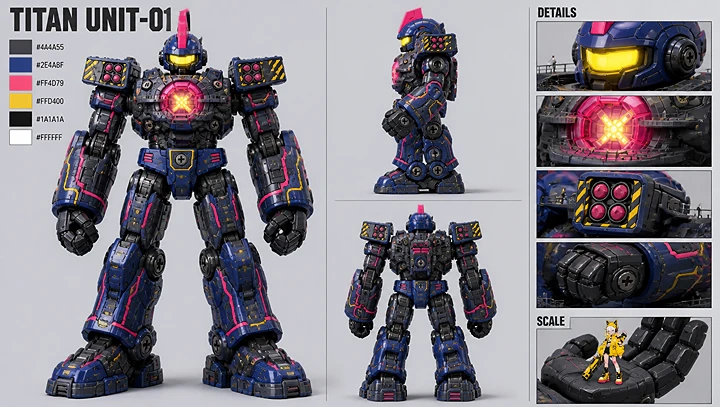
Une petite héroïne, TOPVIEW BOT, combat un mecha jouet géant nommé TITAN dans une ville jouet colorée. Deux images de référence fixent l'apparence exacte des deux personnages, et le prompt précise leur échelle relative, la direction des armes, les séquences d'attaque et le mouvement continu.
Le combat de 30 secondes comprend des tirs de missiles, des esquives, un combat aérien, une escalade sur l'armure du mecha et une attaque d'énergie finale.
Multiréférence · 3 images · 30s · 16:9
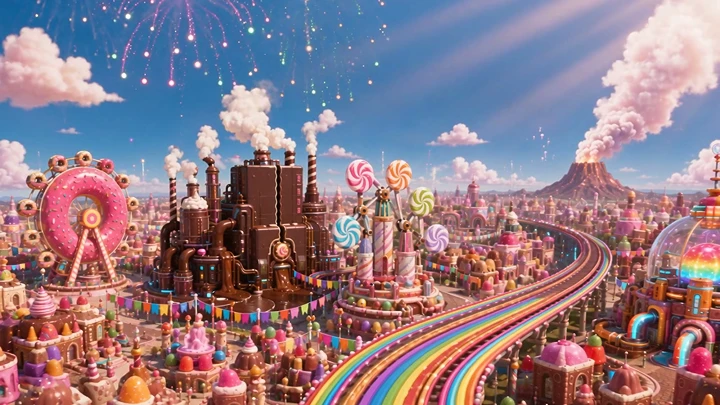
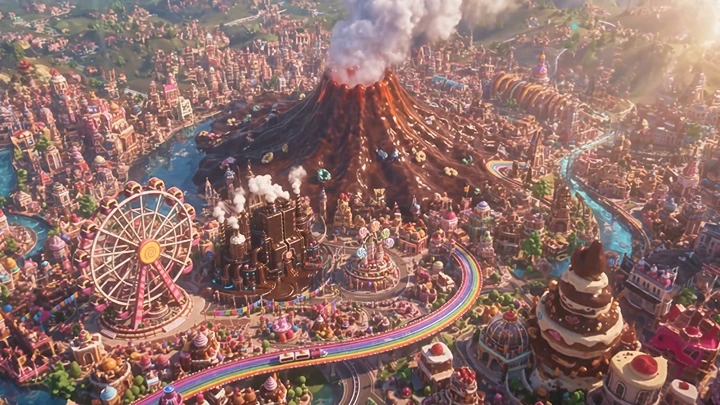
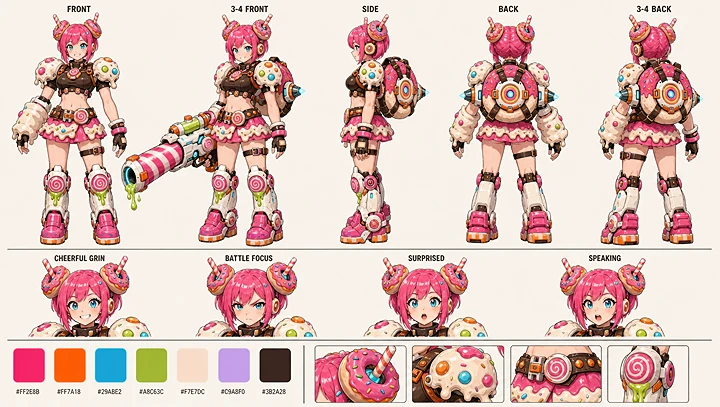
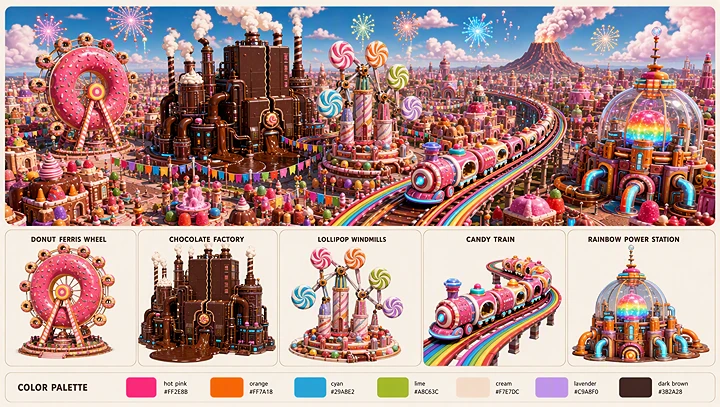
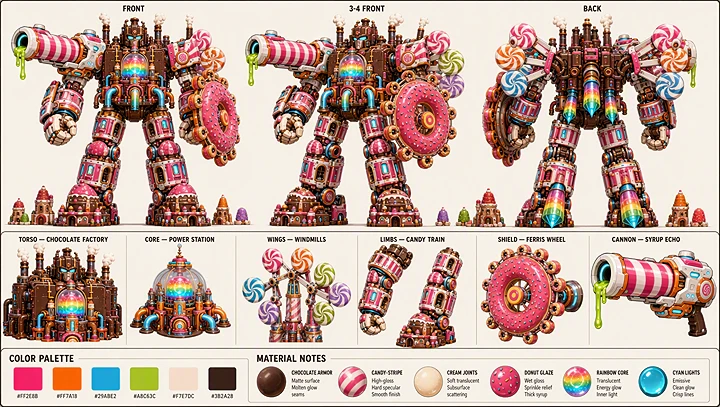
Un Candy Kingdom coloré fait face à une menace qui monte, et l'héroïne SUGAR POP doit défendre la ville avant que ses repères se combinent en un Candy Super Mecha géant.
Trois feuilles de référence définissent l'apparence de l'héroïne, l'environnement de Candy Kingdom et ses repères, ainsi que le mecha final assemblé. Le prompt exige que les deux modèles conservent ces designs tout en générant une histoire d'action complète de 30 secondes.
Texte vers vidéo · 30s · 16:9
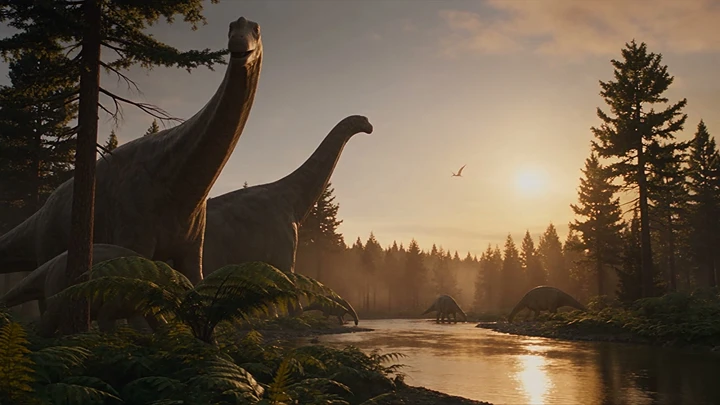
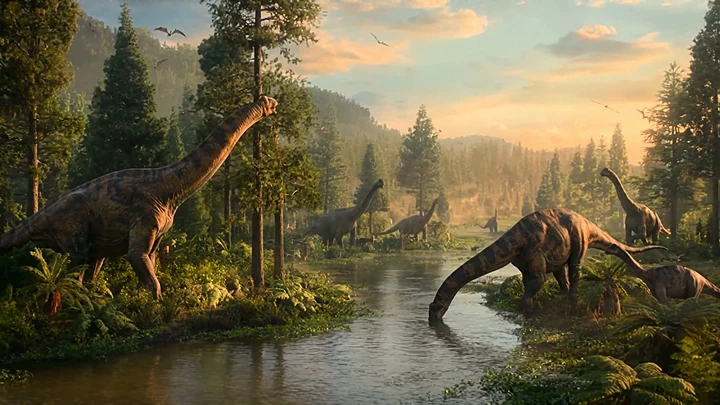
Un documentaire d'histoire naturelle retrace les derniers moments d'un écosystème préhistorique, d'une vallée paisible pleine de dinosaures à un impact catastrophique, une onde de choc, des éruptions volcaniques et une Terre couverte de cendres.
Le prompt combine une voix off en anglais minutée avec précision, une image de style documentaire, des événements environnementaux à grande échelle, un mouvement animal réaliste et une fin orbitale calme.
Texte vers vidéo · 30s · 16:9
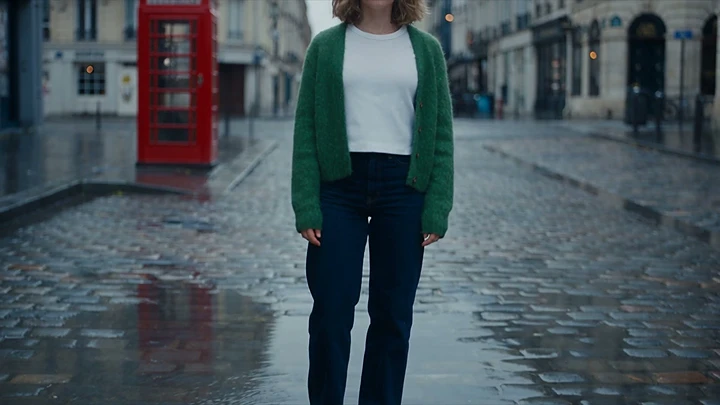
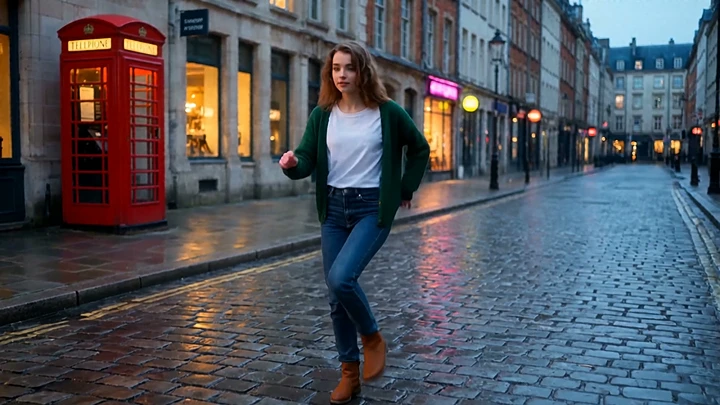
Une danseuse exécute une routine continue en traversant plusieurs univers visuels. La vidéo commence dans une rue européenne réaliste, puis passe au cyberpunk, au cinéma muet en noir et blanc, à l'animation 3D et à des styles de peinture à l'huile.
Chaque transformation change l'environnement visuel et la tenue, tandis que l'identité de la danseuse, la chorégraphie et le rythme musical doivent rester cohérents. La séquence se termine avec les quatre univers alternatifs réunis dans une composition finale.
Multiréférence · 3 images · 15s · 16:9
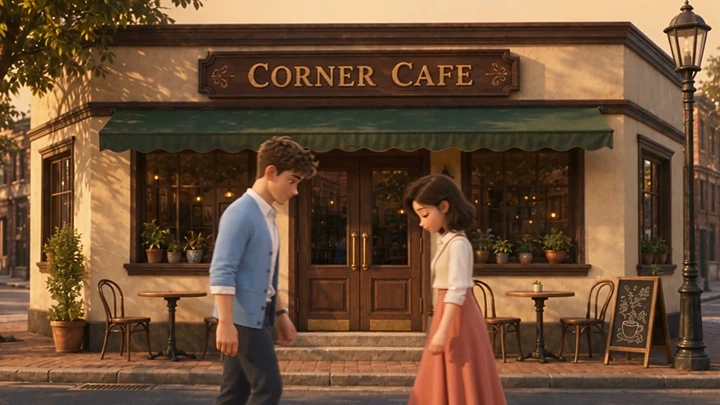
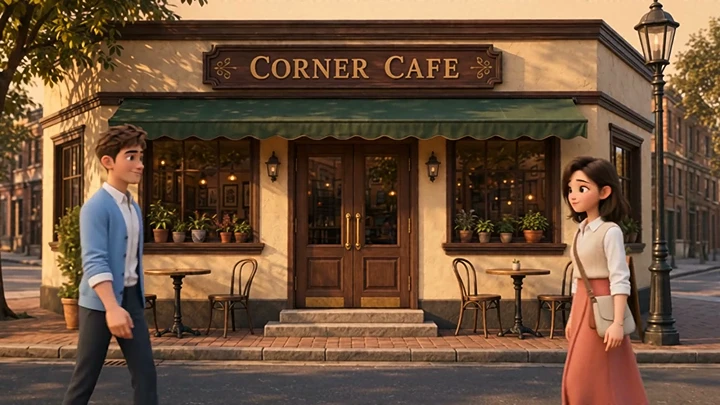
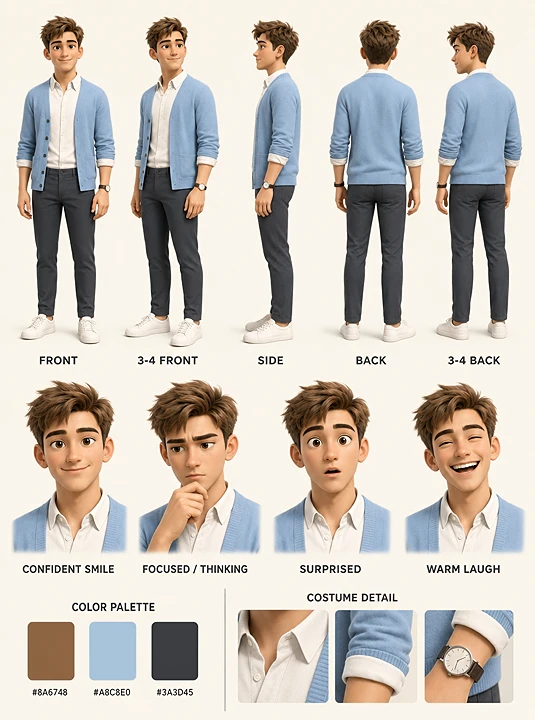
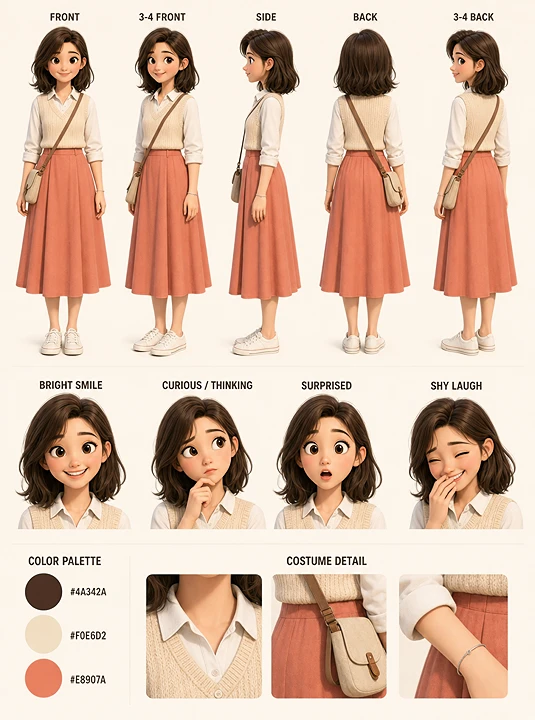
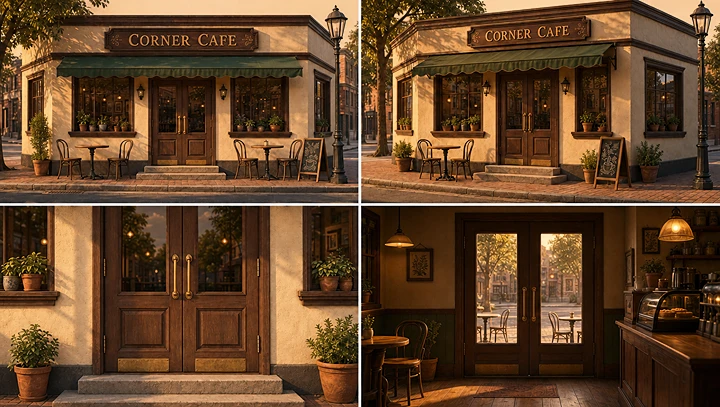
Deux personnages animés stylisés, HAORAN et XIAOYU, se rencontrent par surprise devant un café, échangent quatre répliques de dialogue en anglais et entrent ensemble dans le bâtiment.
Trois images de référence définissent les personnages et l'environnement du café. Le prompt exige un dialogue exact, des expressions naturelles, des designs de personnage cohérents et une action précise d'ouverture de porte.
Texte vers vidéo · 15s · 16:9
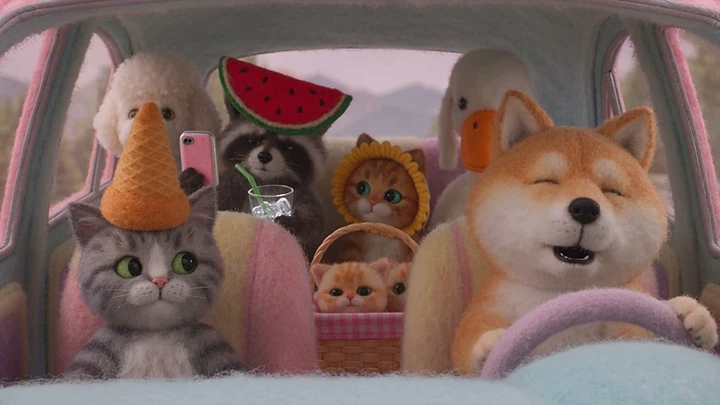
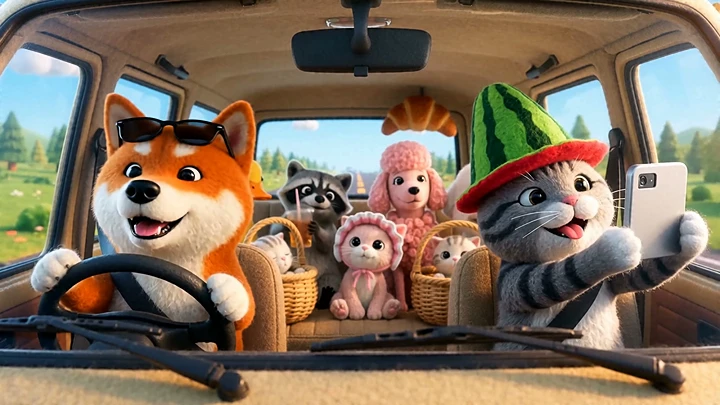
Un groupe de personnages animaux expressifs, de style peluche, fait un trajet en voiture chaotique. Dans le véhicule en mouvement, chaque personnage accomplit une action différente pendant que des événements inattendus enchaînent des réactions comiques.
La scène comprend un Shiba Inu conducteur qui chante, un chat qui prend un selfie, un canard qui s'invite dans la photo, des chapeaux qui changent de place, des passagers qui rebondissent, des objets qui volent et des réactions de groupe coordonnées.
Le prompt demande un angle de caméra fixe et un rendu feutre façon peluche cohérent pendant toute la séquence de 15 secondes.
Multiréférence · 1 image + audio · 15s · 9:16
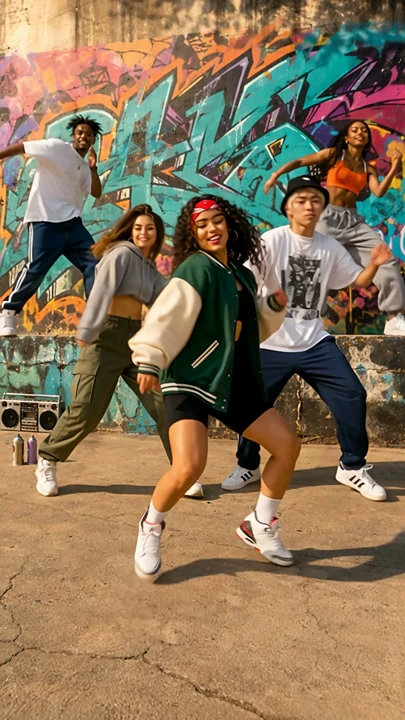
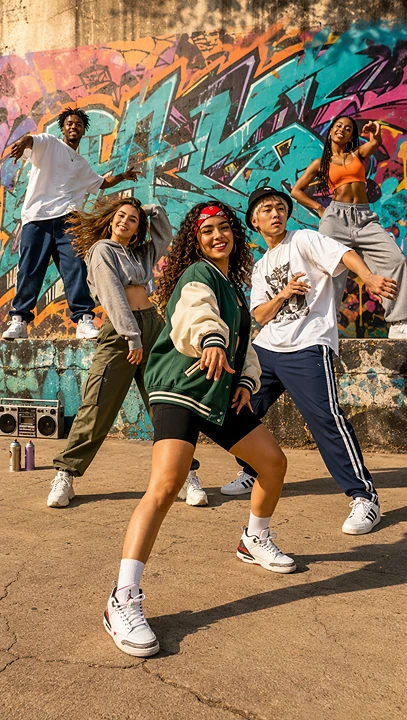
Cinq danseurs exécutent une routine coordonnée de danse de rue sur une place couverte de graffiti, avec une image de référence pour leur apparence et une référence audio pour guider la chorégraphie.
La routine commence en formation en V, puis passe à une ligne horizontale. Le prompt exige que les cinq danseurs gardent leur identité, terminent le changement de formation et synchronisent leurs mouvements avec la musique d'origine dans un seul plan continu.
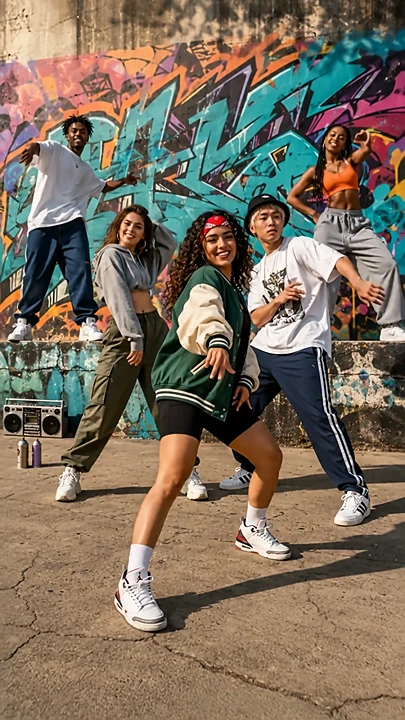
Texte vers vidéo · 15s · 16:9
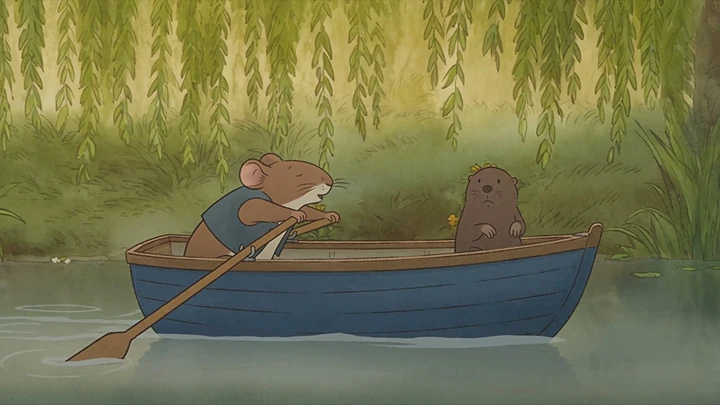
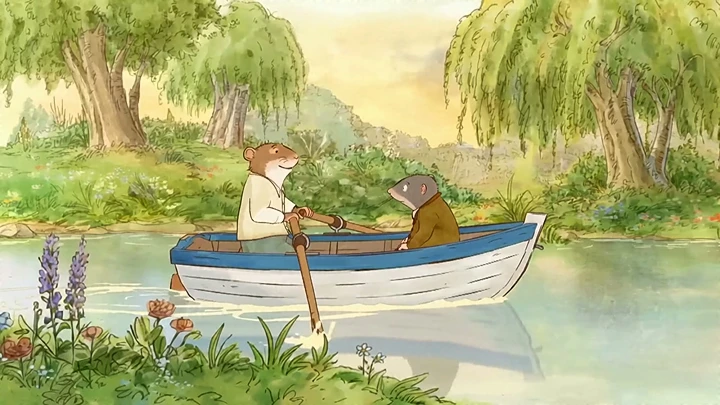
Une courte scène de The Wind in the Willows, de Kenneth Grahame, est adaptée en animation à l'aquarelle édouardienne.
Un rat d'eau rame un bateau bleu et blanc sur une rivière paisible pendant qu'une taupe est assise à la poupe. Lorsque le rat s'absorbe dans la conversation, le bateau heurte la berge et le rameur bascule en arrière avant de se redresser.
Le test demande aux deux modèles de reproduire une séquence littéraire précise tout en gardant les rôles, les actions physiques et une apparence illustrée cohérente.
Ces neuf comparaisons côte à côte montrent comment Seedance 2.5 et Wan 3 répondent à des briefs créatifs précis. Les résultats peuvent varier selon les générations, les réglages et les références d'entrée. Les verdicts comparatifs doivent s'appuyer sur les sorties affichées et sur les critères d'évaluation documentés.
Notre évaluation cherche à savoir si chaque sortie résout la tâche créative d'origine.
Chaque comparaison utilise le même prompt prévu et les mêmes fichiers source. Si un réglage n'est pas disponible sur un modèle, cette différence doit être documentée, et non traitée comme une condition de test identique.
Nous vérifions si les sujets, les actions, l'ordre des scènes et les fins demandés apparaissent dans la sortie. L'absence d'événements clés compte comme une limite, même lorsque la vidéo paraît soignée.
Pour les cas guidés par l'image, nous comparons personnages, produits, tenues, accessoires et lieux au matériau source. Une reproduction plus fidèle n'est pas nécessairement la même chose qu'un style plus séduisant.
Nous examinons les trajectoires de caméra, le mouvement du corps, les interactions avec les objets et le lien entre les plans successifs.
Nous cherchons la dérive d'identité, les remises à zéro brusques et les relations spatiales incohérentes.
Pour les cas guidés par l'audio, nous vérifions les mots prononcés, l'attribution au locuteur, la synchronisation labiale, les signaux sonores et l'alignement sur le rythme lorsque les fichiers source concernés sont disponibles.
Une comparaison de performance fiable exige des journaux de soumission pour chaque tentative, y compris les générations échouées, les nouvelles tentatives et les rejets de modération.
Notre benchmark prévu utilise trois générations par modèle pour les tâches plus simples et cinq générations par modèle pour les tâches plus complexes, soit 74 tentatives de génération au total pour les deux modèles.
Chaque vidéo terminée est évaluée indépendamment avec une grille de notation définie à l'avance.
Pour éviter de ne retenir que les résultats visuellement les plus attrayants, la sortie représentative du benchmark est choisie selon sa proximité avec la note médiane de qualité en évaluation aveugle pour ce modèle et ce scénario.
Des modèles différents peuvent interpréter des consignes identiques de façons différentes.
Une sortie peut exceller dans la composition tandis qu'une autre préserve plus fidèlement un personnage ou une action. Le meilleur modèle pour un projet est celui qui atteint le niveau de qualité exigé à un coût acceptable.
Comparez les mêmes réglages de sortie, pas seulement le tarif annoncé le plus bas.
Les deux modèles utilisent des crédits Topview, mais le coût réel dépend de la variante du modèle, du flux, de la durée, de la résolution et de l'offre du compte.
Le devis en crédits du générateur avant l'envoi est le chiffre le plus pertinent pour votre projet.
| Résolution | Seedance 2.5 sur Topview | Wan 3.0 sur Topview |
|---|---|---|
| 480p | 0.70 crédits/s | 0.30 crédits/s |
| 720p | 1.50 crédits/s | 0.50 crédits/s |
| 1080p | 3.70 crédits/s | 1.00 crédits/s |
Si une sortie demande plusieurs tentatives avant d'être utilisable, le coût réel de production inclut ces tentatives.
Comparez le total de crédits consommés, la qualité de la sortie et le nombre de résultats acceptables, pas seulement le prix à la seconde annoncé.
Seedance 2.5 · Wan 3.0
Une meilleure vidéo AI commence par le modèle adapté à la tâche.
Choisissez Seedance 2.5 pour une direction riche en références et un contrôle créatif détaillé, ou explorez Wan 3.0 lorsque votre brief entre dans les entrées disponibles et que vous voulez comparer les coûts de génération.
Gardez le même prompt et les mêmes références, examinez les sorties et choisissez d'après le résultat, pas seulement d'après le nom du modèle.
Les scènes d'action complexes demandent beaucoup à la génération de vidéo AI. Le modèle doit garder des personnages cohérents, comprendre l'échelle relative, préserver les relations spatiales et coordonner plusieurs actions dans le temps. Ce test vérifie si des combats visuellement ambitieux restent compréhensibles.
Wan 3.0 correspond mieux aux feuilles de référence dans ce combat. L'ouverture garde lisibles les couettes blanches, la casquette à oreilles de chat, la veste jaune et le canon face au mecha bleu marine, à la crête rose, à la visière jaune et au noyau rose sur la poitrine. Une image plus tardive montre des missiles en l'air avant qu'elle revienne sur l'armure. Seedance 2.5 gagne la lecture d'échelle sur le plan du poing, où elle est minuscule contre la main, mais elle redescend au niveau de la rue, et son visage comme son arme deviennent difficiles à vérifier quand la caméra élargit. Seedance se termine sur une explosion rose avec la tireuse hors cadre. Wan se termine avec elle, petite, contre la visière. Choisissez Wan 3.0 lorsque les feuilles de personnage et le temps des missiles doivent rester reconnaissables. Choisissez Seedance 2.5 lorsque le contraste entre le géant et le minuscule compte plus qu'une correspondance nette avec la référence.
La génération multi-références exige que le modèle comprenne comment des entrées visuelles séparées se relient. Au-delà de la reproduction d'objets isolés, il doit préserver l'identité, combiner des éléments de design et garder un univers créatif cohérent d'une scène à l'autre.
Ce test aide à évaluer avec quelle fiabilité chaque modèle transforme plusieurs images de référence en une vidéo plus longue et structurée.
Seedance 2.5 est le résultat multi-références le plus solide. Le gros plan garde le bob rose de Sugar Pop, les yeux bleus et les accessoires bonbon dans les cheveux. Le milieu du clip lance des repères bonbon séparés. Le robot en plan large correspond à la feuille du mecha, avec le canon d'épaule rayé, le bouclier d'avant-bras en forme de donut et les membres en bonbon dans un seul corps. La fin est un faisceau coloré, et ce robot est encore dans le cadre. Wan 3.0 ouvre sur le Candy Kingdom le plus lisible, grande roue, volcan et rues en bonbon, et c'est le clip qui montre le monstre dessert au-dessus de la ville. Les images suivantes restent sur un train en bonbon et un visage de robot flou, si bien que le mecha assemblé ne se verrouille jamais comme la feuille de design le précise. Choisissez Seedance 2.5 lorsque le personnage, la combinaison et le mecha terminé doivent survivre dans une seule vidéo. Choisissez Wan 3.0 lorsque le royaume et le monstre doivent se lire en premier.
La génération de vidéo documentaire dépend d'une communication précise, pas seulement d'images cinématographiques. Narration, timing des scènes, récit visuel et continuité de l'environnement doivent fonctionner ensemble pour transmettre une séquence complète.
Ce test examine comment chaque modèle coordonne une narration parlée et des événements visuels complexes sur 30 secondes.
Wan 3.0 porte l'histoire en images plus loin. Les images passent d'une vallée fluviale dorée à une ruée de face sous un mur de poussière, une éruption, un animal tombé dans la cendre et une Terre grise en orbite. Seedance 2.5 va aussi de la vallée ensoleillée à un troupeau en course, une inondation avec un petit stégosaure et un sauropode gris cendre, mais il est encore dans la vallée paisible bien avancé dans le clip, et sa dernière image échantillonnée est un gris sans relief, pas une orbite. L'inondation, et le petit animal face au paysage, sont plus clairs chez Seedance. Ces images ne confirment pas le texte parlé, le rythme ni les pauses. Choisissez Wan 3.0 lorsque la vidéo doit atteindre l'effondrement et la fin orbitale. Choisissez Seedance 2.5 lorsque la vallée et l'inondation doivent rester naturalistes, puis vérifiez si votre propre génération atteint l'orbite.
Le changement de style exige que le modèle sépare l'apparence visuelle de l'identité du sujet et du mouvement. L'environnement et le traitement artistique peuvent changer fortement, mais le personnage et l'action de fond doivent rester compréhensibles.
Ce test explore comment chaque modèle gère des transformations coordonnées entre plusieurs styles visuels dans une séquence créative continue.
Seedance 2.5 couvre davantage des univers demandés. Les extraits montrent la rue européenne mouillée et le cardigan vert, une tenue cyberpunk néon, une image de cinéma muet en noir et blanc avec bandes, un passage en peinture à l'huile étoilée avec une robe bleue, puis le look d'origine entouré de quatre panneaux séparés. Wan 3.0 danse plus clairement dans la rue et dans les parties cyberpunk, et son moment d'animation 3D en robe jaune est une scène entière, pas une image dans un panneau. L'univers du cinéma muet n'apparaît pas dans les extraits de Wan, et la fin est faite de quatre images séparées, pas d'une affiche avec la danseuse au centre. Choisissez Seedance 2.5 lorsque la liste des styles et la fin à quatre univers sont l'enjeu du brief. Choisissez Wan 3.0 lorsque une chorégraphie lisible et l'univers cartoon comptent plus que le segment de cinéma muet.
Les scènes de dialogue réunissent plusieurs tâches exigeantes : génération de la parole, synchronisation labiale, cohérence des personnages, jeu émotionnel et interaction physique coordonnée.
Un résultat convaincant dépend du fonctionnement conjoint de ces éléments. Ce test aide à évaluer l'efficacité de chaque modèle sur un récit porté par les personnages.
Les deux clips gardent les designs de référence : le cardigan bleu, le gilet crème, la jupe saumon et l'auvent de Corner Cafe. Les bouches sont ouvertes pendant la conversation, mais les images fixes ne peuvent pas confirmer les quatre répliques ni une vraie synchronisation labiale. La porte est la différence visible. La dernière image de Wan 3.0 le montre en train de tenir la poignée en laiton pendant qu'elle franchit l'ouverture. Seedance 2.5 conduit la paire jusqu'à l'entrée puis à l'intérieur, sans moment clair où la porte est tenue ouverte vers l'extérieur. Choisissez Wan 3.0 pour ce brief lorsque l'action de l'entrée doit correspondre au prompt. L'un ou l'autre modèle convient lorsque la priorité est de garder les deux personnages et le café cohérents. Écoutez les répliques avant de verrouiller une prise.
Le jeu à plusieurs personnages teste la capacité du modèle à gérer plusieurs actions indépendantes dans un environnement partagé.
Le défi n'est pas seulement de générer beaucoup de personnages à la fois, mais de préserver leurs identités, de coordonner leurs interactions et de maintenir des relations logiques de cause à effet dans la scène.
Seedance 2.5 garde l'intérieur verrouillé. La même vue du pare-brise tient le shiba au volant, la bouche ouverte, le chat au chapeau pastèque et le canard. Le cou du canard avance, mais l'échange de chapeaux, l'attrapé du raisin et le pouce final levé ne sont pas visibles. Wan 3.0 montre davantage de ces gags : un croissant sur une tête, le caniche collé au chien blanc, un chaton grognon dans le panier et un pouce levé du conducteur. La caméra quitte aussi l'angle verrouillé. Elle coupe de l'habitacle entier à la banquette arrière, puis dans le panier, et les chapeaux comme les places se réorganisent. Choisissez Seedance 2.5 lorsqu'une caméra fixe et une distribution stable comptent. Choisissez Wan 3.0 lorsque la chaîne de réactions comiques compte plus qu'un seul angle sans coupure.
La génération de danse exige une coordination précise entre le mouvement visuel, l'identité des personnages, la position du groupe et le timing audio.
Une séquence de danse séduisante peut encore échouer si les interprètes perdent la synchronisation ou si la formation change mal. Ce test examine si chaque modèle peut coordonner plusieurs sujets avec une référence musicale externe.
Wan 3.0 ouvre plus près de la photo de référence : cinq danseurs, la veste varsity verte devant et une posture proche du V contre le mur de graffiti. Au milieu, ce groupe disparaît et un danseur occupe la place, avant qu'une image plus tardive revienne avec un groupe plus lâche. Seedance 2.5 garde un groupe dans chaque extrait, y compris la veste verte, mais les images suivantes ajoutent des personnes et ne montrent pas un passage net du V de départ vers une seule ligne horizontale des mêmes cinq. Les images fixes ne peuvent pas confirmer que l'un des clips reste sur le rythme d'origine ou laisse l'audio intact. Choisissez Seedance 2.5 lorsque tous les danseurs doivent rester dans le cadre. Choisissez Wan 3.0 lorsque le premier plan doit correspondre à la référence, puis regardez le milieu du clip avant d'accepter le changement de formation.
L'adaptation littéraire exige que le modèle transforme un récit écrit en une séquence visuelle claire.
Le défi n'est pas seulement de produire de belles images de livre illustré. Le résultat doit préserver les rôles, les relations de cause à effet et les événements essentiels qui rendent la scène d'origine reconnaissable.
Ce test aide à évaluer avec quelle fidélité chaque modèle convertit un passage littéraire détaillé en une vidéo courte.
Seedance 2.5 suit le passage plus loin. Le rat rame pendant que la taupe est assise à la poupe, puis le rat est sur le dos, les pieds en l'air, puis il se rassied. Le bateau se lit comme bleu uni, et non bleu à l'extérieur et blanc à l'intérieur, et la proue qui heurte la berge est suggérée par la chute, pas montrée. Wan 3.0 correspond mieux au bateau, bleu à l'extérieur et blanc à l'intérieur, et tient une aquarelle édouardienne plus stable pendant qu'ils rament sous les saules. Ses images tardives penchent le bateau vers les fleurs, puis reviennent à une rame calme. La chute avec les talons en l'air et le redressement manquent donc. Choisissez Seedance 2.5 lorsque le choc et la chute doivent être lisibles. Choisissez Wan 3.0 lorsque le bateau peint et la rivière calme comptent plus que la chute finale.
"Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)
Source originale : Kenneth Grahame, The Wind in the Willows (1908), chapitre I. Texte du domaine public disponible via Project Gutenberg.