Seedance 2.5
Clipes até 30 segundos, até 50 referências combinadas no fluxo de trabalho do Topview indicado e direção pormenorizada de plano e de áudio.
Que modelo de vídeo AI deve escolher para si?
Tanto o Seedance 2.5 como o Wan 3.0 aceitam fluxos de trabalho de vídeo AI até 30 segundos, com opções de saída que atingem 1080p nos fluxos de trabalho compatíveis do Topview.
A escolha prática depende do seu brief: o Seedance 2.5 merece ser considerado para produções com muitas referências e instruções de tempo pormenorizadas; o Wan 3.0 merece ser considerado quando o custo de geração por segundo é prioritário.
Compare as definições compatíveis, os vídeos lado a lado que já existem e os compromissos de cada modelo antes de gerar.
Seedance 2.5
Clipes até 30 segundos, até 50 referências combinadas no fluxo de trabalho do Topview indicado e direção pormenorizada de plano e de áudio.
Wan 3.0
Clipes até 30 segundos, até 20 referências combinadas na comparação do Topview indicada e tarifas de referência publicadas por segundo mais baixas em modos de geração selecionados.
Os limites e os preços dependem do modo, da sua conta e das definições de geração escolhidas. Consulte sempre o gerador em direto antes de submeter uma tarefa.
Os dois modelos juntam geração de vídeo e direção multimodal. A tabela distingue a documentação ao nível do modelo das definições listadas para o fluxo de trabalho do Topview.
| Dimensão | Seedance 2.5 | Wan 3.0 |
|---|---|---|
| Desenvolvedor | ByteDance | Alibaba |
| Utilização principal | Briefs criativos mais longos e com muitas referências | Criação multimodal com atenção ao custo de geração |
| Duração | 4s–30s, selecionável ao segundo | 2s–30s, selecionável ao segundo |
| Resolução | 480p / 720p / 1080p | 480p / 720p / 1080p |
| Relações de aspeto | 16:9, 9:16, 3:4, 1:1, 4:3, 21:9 (para além da opção adaptativa) | 16:9, 9:16, 1:1, 4:3, 3:4 |
| Texto para vídeo | Compatível | Compatível |
| Imagem para vídeo | Compatível | Compatível |
| Orientação de vídeo e áudio | Compatível em fluxos de trabalho compatíveis | Compatível em fluxos de trabalho compatíveis |
| Referências de imagem | Até 30 | Até 10 |
| Referências de vídeo | Até 10 | Até 5 |
| Referências de áudio | Até 10 | Até 5 |
| Referências combinadas | Até 50 | Até 20 |
| Geração de áudio | Disponível em fluxos de trabalho compatíveis | Disponível em fluxos de trabalho compatíveis |
| Tempo e direção de cena | Instruções com código de tempo e seleção de duração ao segundo | Indicações de plano e de cena, consoante o fluxo de trabalho |
| Preço | Os créditos variam consoante a resolução, a duração, o modo e o plano P. ex. 1.5 créditos/s em 720p | Os créditos variam consoante a resolução, a duração, o modo e o plano P. ex. 0.5 créditos/s em 720p |
| Ideal para | Narrativa com muitas referências e direção criativa pormenorizada | Geração atenta ao custo e briefs criativos concretos |
Os limites de referência refletem as definições listadas de momento na comparação do Topview, e não uma garantia para todos os fornecedores ou todas as contas. Consulte o gerador para ver as definições disponíveis. Os preços dos planos estão na .
Comece pelo tipo de vídeo de que precisa, não pelo nome do modelo. Estas recomendações dizem respeito ao encaixe no fluxo de trabalho: não afirmam que um modelo produz sempre vídeos de melhor aspeto.
O Seedance 2.5 e o Wan 3 aceitam geração de vídeo AI até 30 segundos, mas oferecem vantagens diferentes. Escolha o Seedance 2.5 para projetos com muitas referências, temporização precisa e direção de áudio pormenorizada. Considere o Wan 3 para produção atenta ao custo, narrativas mais longas numa única tomada e criação de cenas guiada por referências.
Reúna briefs criativos complexos com até 50 ficheiros de referência: 30 imagens, 10 vídeos e 10 ficheiros de áudio. Oriente a identidade da personagem, os detalhes do produto, o movimento, os ambientes e o som num único fluxo de geração. O Wan 3 só aceita 20 referências.
Utilize vídeos e ficheiros de áudio de referência de até 30.2 segundos cada, sujeitos aos limites de duração combinada do fluxo de trabalho. Oriente o movimento, o ritmo e o som com tomadas de movimento mais longas ou com referências musicais.
Escolha uma duração de 4 a 30 segundos, em incrementos de um segundo. Utilize instruções com código de tempo para planear planos, ações, transições e o ritmo da cena num vídeo contínuo.
Dirija o diálogo, a música de fundo e os efeitos sonoros com instruções com código de tempo. Coordene a fala, a ação e a atmosfera com geração de áudio nativa num único fluxo de trabalho.
O Wan 3.0 figura com 0.30 créditos/s em 480p, 0.50 em 720p e 1.00 em 1080p, face a 0.70, 1.50 e 3.70 créditos/s do Seedance 2.5 nos preços de referência publicados no Topview. Reveja a cotação real de créditos antes de gerar, pois as tarifas dependem do fluxo de trabalho e do plano selecionados.
Gere uma sequência de vídeo contínua até 30 segundos sem estar a unir vários clips curtos. Serve para revelações de produto, movimentos de câmara sem corte e histórias de marca que beneficiam de um único plano fluido.
Utilize o Omni Reference para orientar a identidade das personagens, os adereços e os ambientes ao longo de uma narrativa mais longa. Mantenha o mundo criativo preso às referências visuais enquanto desenvolve cenas e ações.
Utilize a descoberta de referências assistida por pesquisa na internet para apoiar a criação de vídeo com material visual e contextual adicional, quando esta funcionalidade estiver disponível no seu fluxo de trabalho do Topview.
O mesmo brief. Dois modelos de vídeo AI. Nove situações reais.
Como se comparam o Seedance 2.5 e o Wan 3 quando recebem as mesmas instruções criativas? Explore nove testes de vídeo lado a lado: VFX cinematográficos, ação complexa, referências multimodais, narrativa documental, mudanças de estilo, diálogo, interação entre personagens, sincronização de dança e adaptação literária.
Cada comparação apresenta as saídas dos dois modelos juntamente com o prompt original e os ficheiros de referência, quando existem. Veja como cada modelo enfrenta o mesmo desafio criativo, examine os pormenores que importam e avalie qual o modelo mais adequado a cada tipo de projeto.
Texto para vídeo · 30s · 16:9
Um deus nórdico paira sobre um santuário de obsidiana fraturado enquanto relâmpagos dourados, destroços flutuantes e runas luminosas avançam para um clímax explosivo. A câmara executa uma órbita contínua de 360 graus enquanto a personagem invoca um martelo de combate enorme e liberta uma onda de choque potente.
Este teste pede aos dois modelos que combinem efeitos visuais complexos, movimento da personagem, direção de câmara dinâmica e uma sequência de ação contínua num único vídeo de 30 segundos.
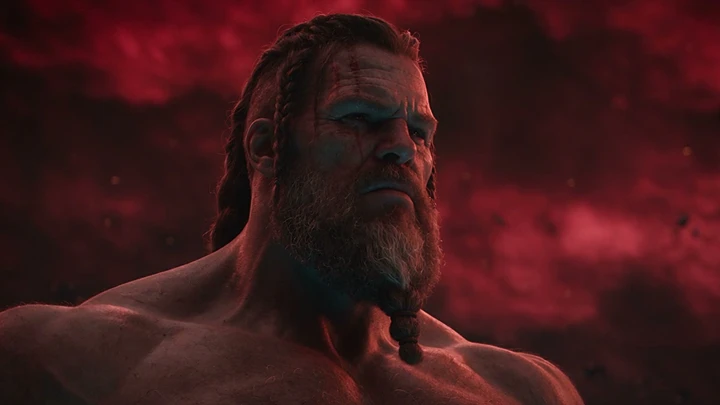
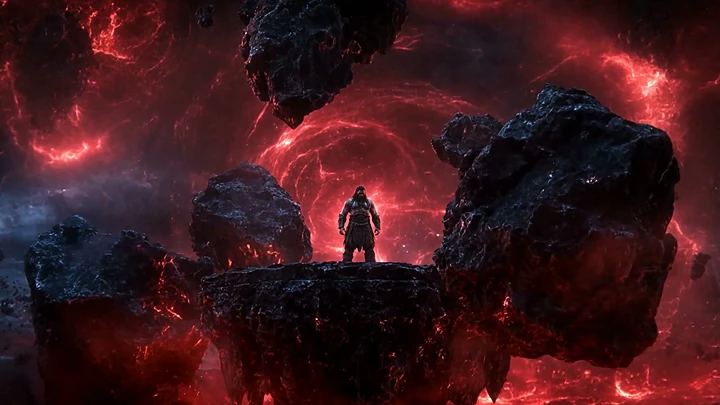
A geração de VFX cinematográficos exige mais do que fotogramas isolados impressionantes. O modelo tem de coordenar o movimento de câmara, as ações da personagem e os efeitos visuais, mantendo uma sequência coerente. Este teste ajuda a perceber como cada modelo trata cenas visualmente complexas com várias ações dependentes entre si.
O Seedance 2.5 mantém este brief mais coeso. Ao longo do clip, um único deus barbudo permanece num único pico fraturado: um grande plano solene, o mesmo rosto com olhos luminosos, relâmpagos a acumularem-se sobre o santuário e, de seguida, a figura no ar com um martelo. O Wan 3.0 produz efeitos isolados mais fortes — um portal vermelho, uma tempestade de destroços, uma explosão dourada e um círculo de runas azul —, mas o deus desaparece a meio do clip e o martelo surge como uma pose depois da explosão, e não como uma fusão que se consiga seguir. Os fotogramas amostrados não mostram uma órbita de 360 graus completa em nenhum dos modelos. Escolha o Seedance 2.5 quando uma personagem e um local tiverem de escalar até ao martelo. Escolha o Wan 3.0 quando um plano de efeitos espetacular importar mais do que permanecer no mesmo rosto e no mesmo santuário.
Multirreferência · 2 imagens · 30s · 16:9
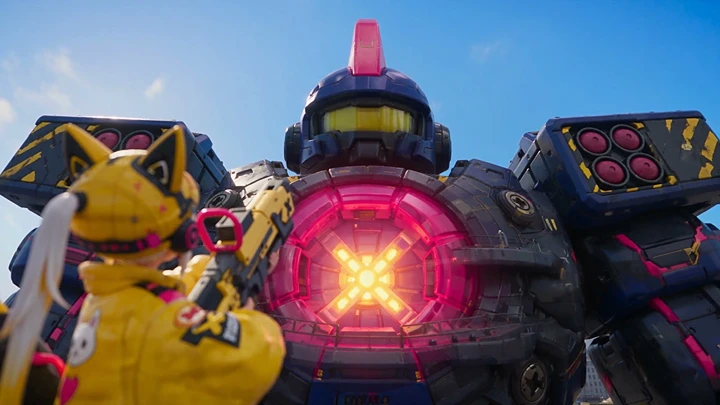
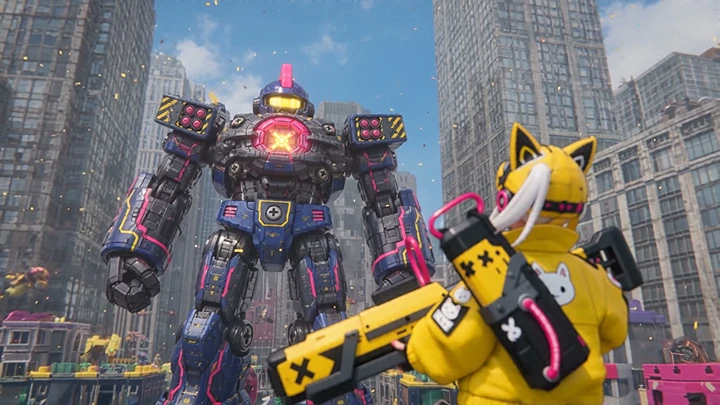
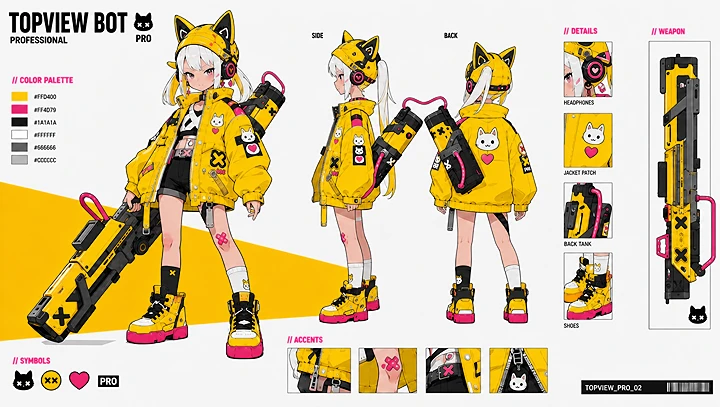
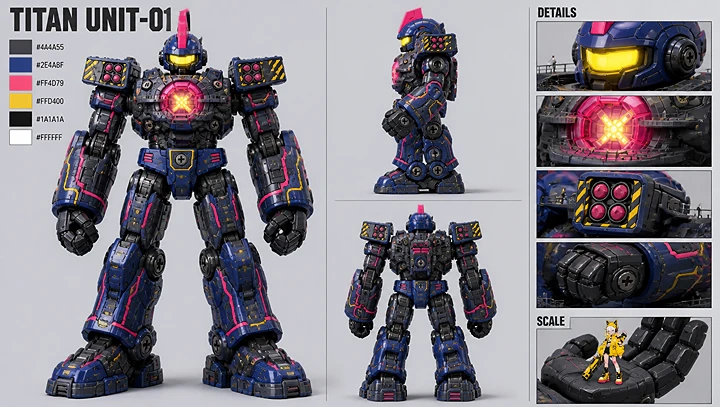
Uma heroína pequena, TOPVIEW BOT, combate um mecha de brinquedo gigante chamado TITAN numa cidade de brinquedos colorida. Duas imagens de referência definem a aparência exata das duas personagens, e o prompt especifica a escala relativa, a direção das armas, as sequências de ataque e o movimento contínuo.
O combate de 30 segundos inclui ataques de mísseis, manobras de evasão, combate no ar, uma subida pela armadura do mecha e um ataque de energia final.
Multirreferência · 3 imagens · 30s · 16:9
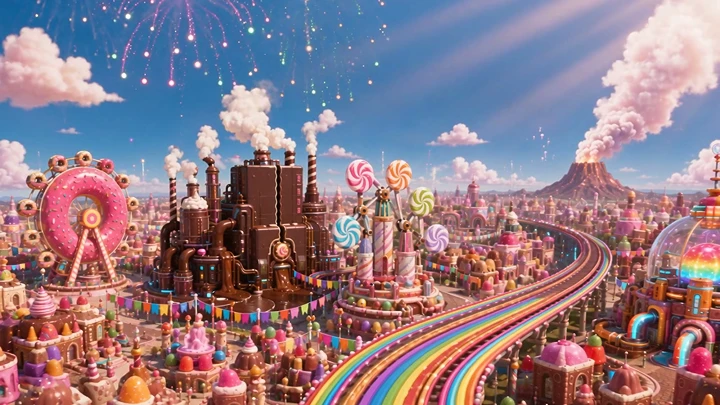
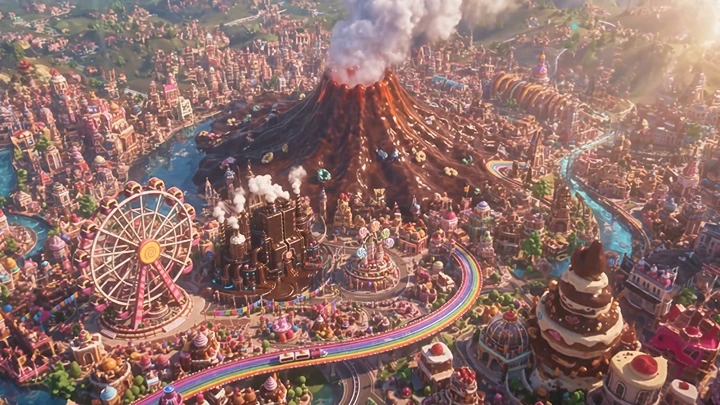
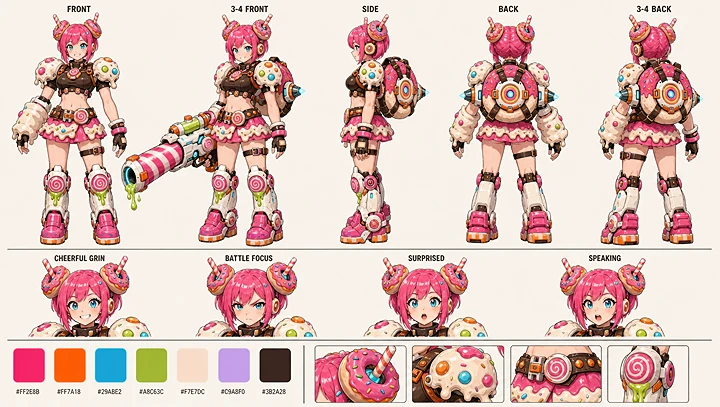
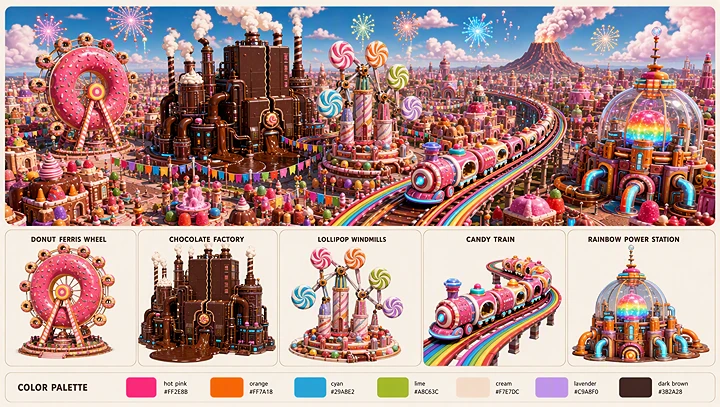
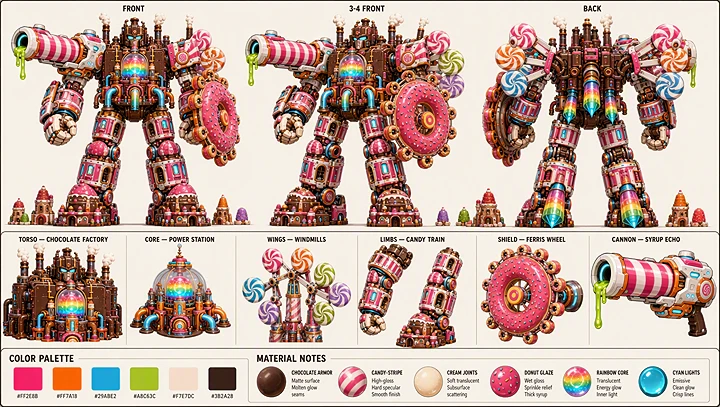
Um colorido Candy Kingdom enfrenta uma ameaça crescente, e a heroína SUGAR POP tem de defender a cidade antes de os marcos se combinarem num Candy Super Mecha gigante.
Três folhas de referência definem a aparência da heroína, o ambiente de Candy Kingdom e os seus marcos, e o mecha final montado. O prompt exige que os dois modelos preservem estes desenhos ao gerar uma história de ação completa de 30 segundos.
Texto para vídeo · 30s · 16:9
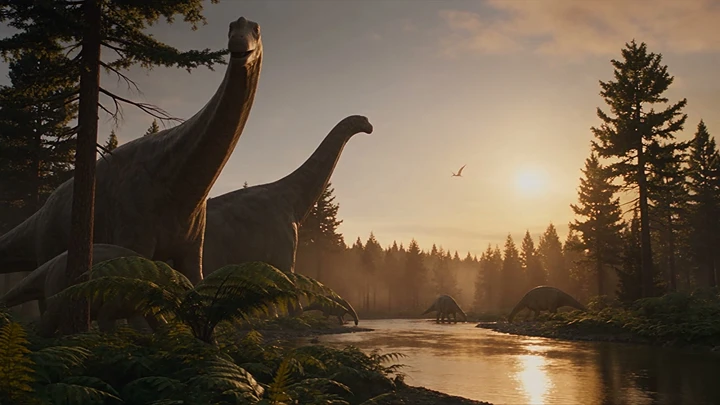
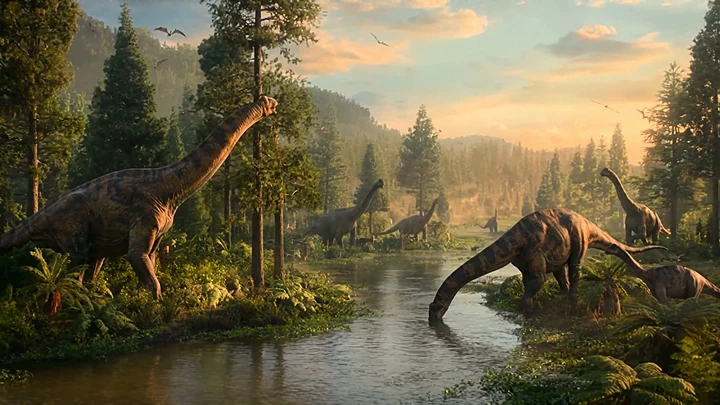
Um documentário de história natural retrata os momentos finais de um ecossistema pré-histórico, passando de um vale tranquilo cheio de dinossauros para um impacto catastrófico, uma onda de choque, erupções vulcânicas e uma Terra coberta de cinza.
O prompt combina uma narração em inglês cronometrada com precisão, cinematografia de estilo documental, eventos ambientais em grande escala, movimento animal realista e um final orbital calmo.
Texto para vídeo · 30s · 16:9
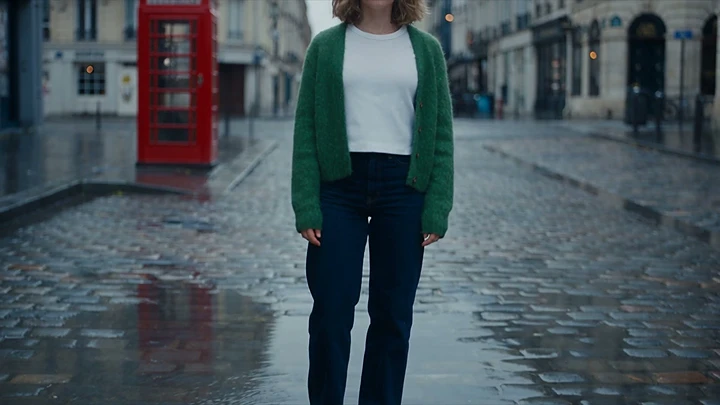
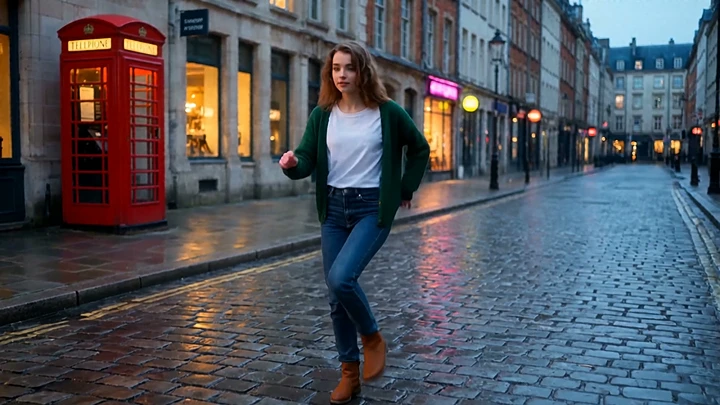
Uma bailarina executa uma rotina contínua enquanto percorre vários mundos visuais. O vídeo começa numa rua europeia realista e passa para ciberpunk, cinema mudo a preto e branco, animação 3D e estilos de pintura a óleo.
Cada transformação muda o ambiente visual e a roupa, enquanto a identidade da bailarina, a coreografia e o ritmo musical devem manter-se. A sequência termina com os quatro mundos alternativos reunidos numa composição final.
Multirreferência · 3 imagens · 15s · 16:9
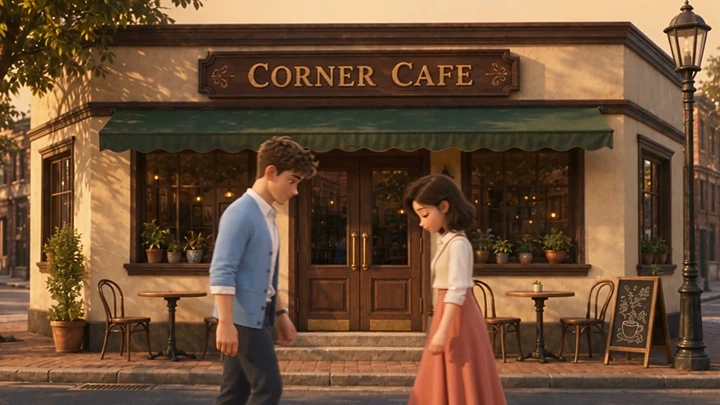
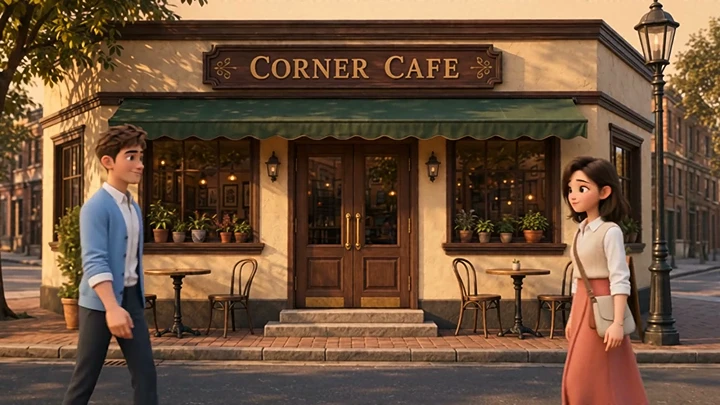
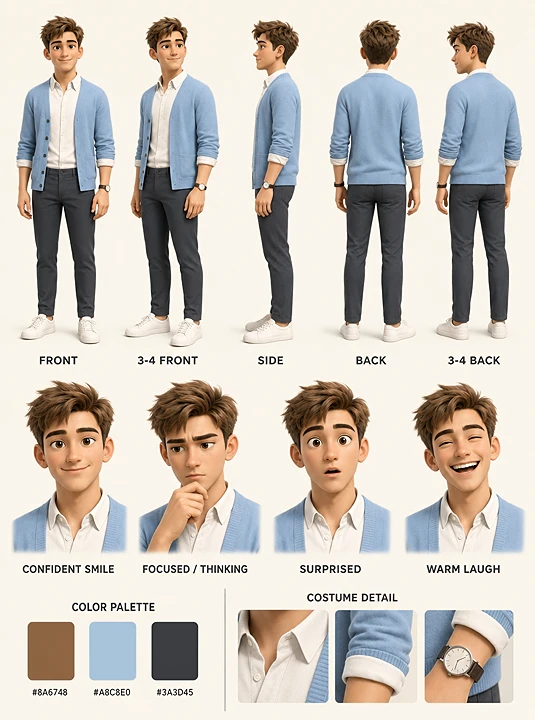
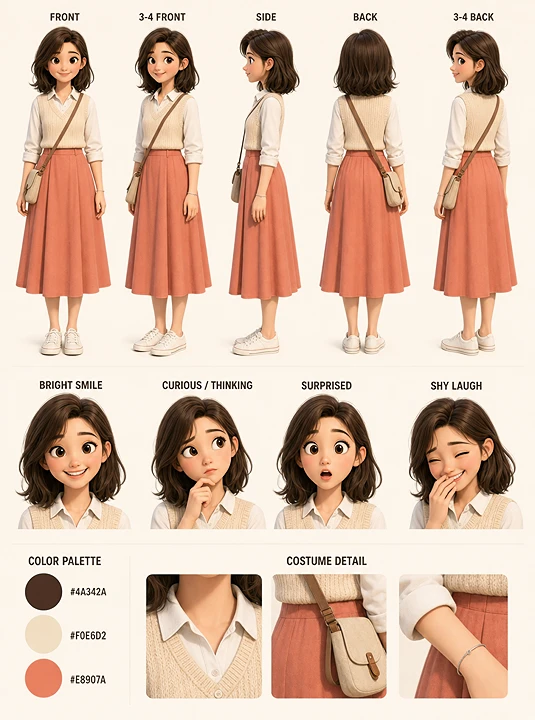
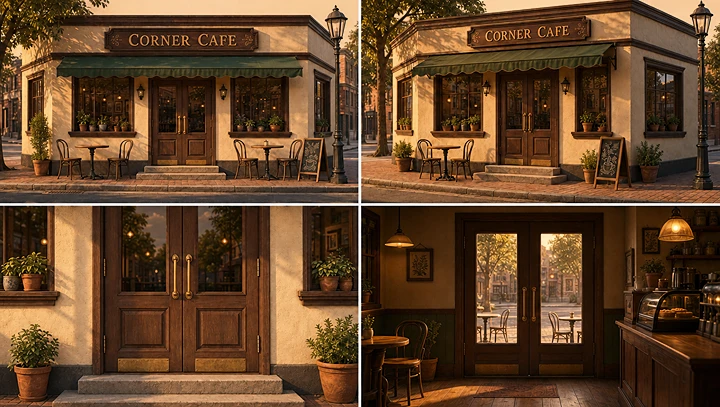
Duas personagens animadas estilizadas, HAORAN e XIAOYU, encontram-se de surpresa à porta de um café, trocam quatro falas de diálogo em inglês e entram juntas no edifício.
Três imagens de referência definem as personagens e o ambiente do café. O prompt exige diálogo preciso, expressões faciais naturais, desenhos de personagem consistentes e uma ação específica de abrir a porta.
Texto para vídeo · 15s · 16:9
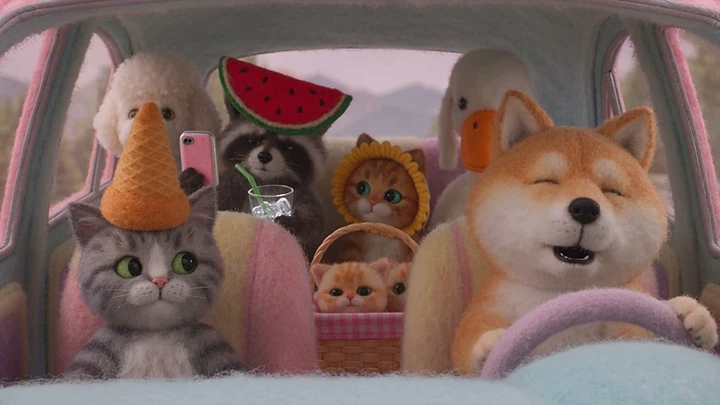
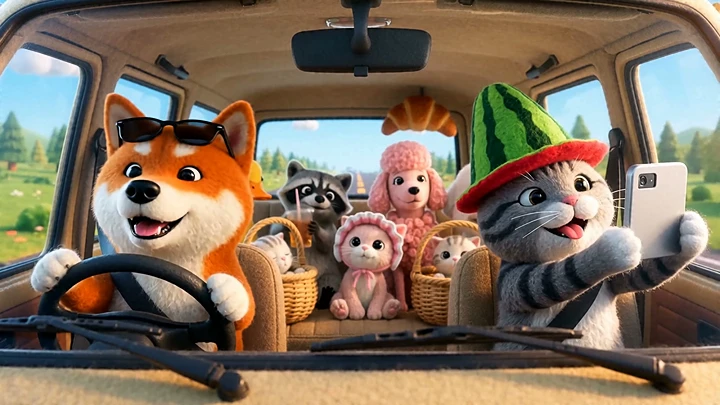
Um grupo de personagens animais expressivas, em estilo peluche, faz uma viagem de carro caótica. Dentro do veículo em movimento, cada personagem executa uma ação diferente enquanto eventos inesperados criam uma cadeia de reações cómicas.
A cena inclui um Shiba Inu condutor a cantar, um gato a tirar uma selfie, um pato a intrometer-se na fotografia, chapéus que mudam de lugar, passageiros aos saltos, objetos a voar e reações de grupo coordenadas.
O prompt pede um ângulo de câmara fixo e uma renderização de feltro tipo peluche consistente ao longo da sequência de 15 segundos.
Multirreferência · 1 imagem + áudio · 15s · 9:16
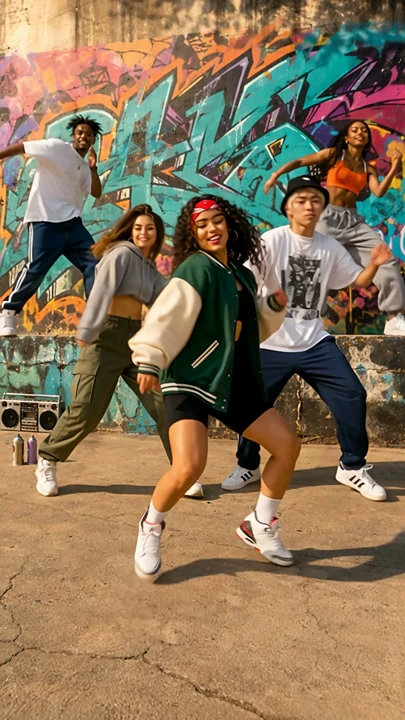
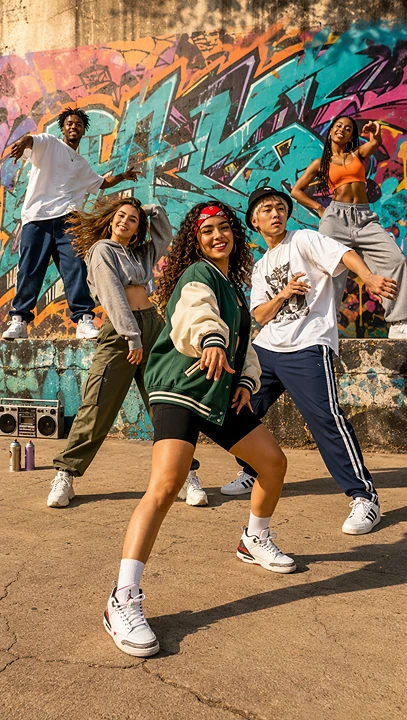
Cinco dançarinos executam uma rotina coordenada de dança de rua numa praça coberta de graffiti, com uma imagem de referência para definir a aparência e uma referência de áudio para orientar a coreografia.
A rotina começa em formação de V e passa para uma linha horizontal. O prompt exige que os cinco dançarinos preservem a identidade, concluam a mudança de formação e sincronizem os movimentos com a música original num único plano contínuo.
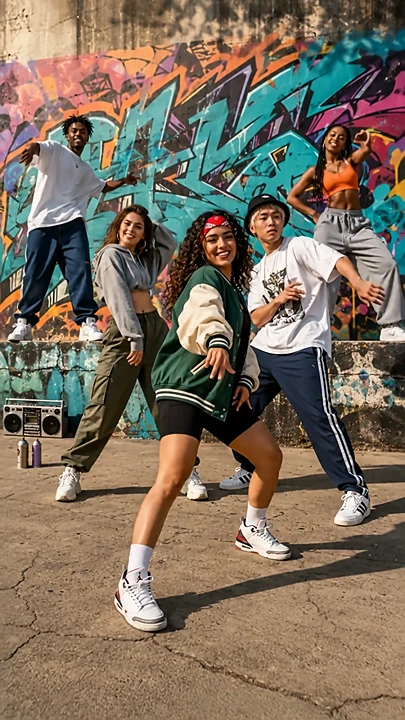
Texto para vídeo · 15s · 16:9
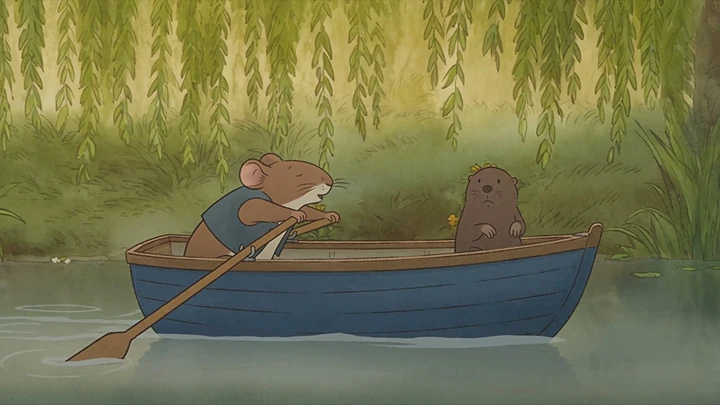
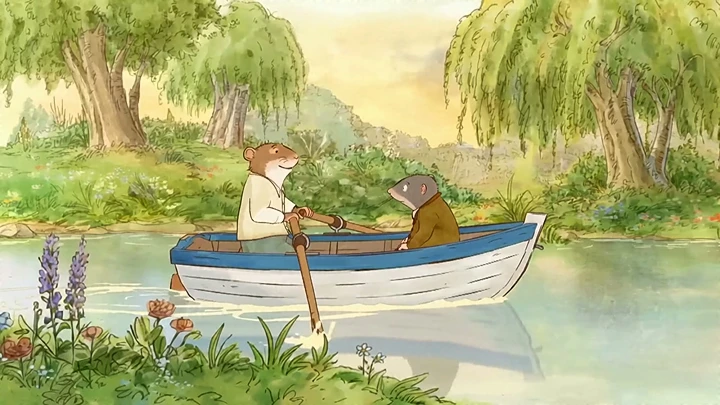
Uma cena curta de The Wind in the Willows, de Kenneth Grahame, é adaptada para uma animação em aguarela eduardiana.
Um rato de água rema um barco azul e branco por um rio tranquilo enquanto uma toupeira se senta na popa. Quando o rato se absorve na conversa, o barco embate na margem e o remador tomba para trás antes de recuperar.
O teste pede aos dois modelos que reproduzam uma sequência literária específica e mantenham os papéis das personagens, as ações físicas e uma aparência ilustrada consistente.
Estas nove comparações lado a lado mostram como o Seedance 2.5 e o Wan 3 respondem a briefs criativos concretos. Os resultados podem variar entre gerações, definições e referências de entrada. Os vereditos comparativos devem basear-se nas saídas apresentadas e nos critérios de avaliação documentados.
A nossa abordagem de avaliação centra-se em saber se cada saída resolve a tarefa criativa original.
Cada comparação utiliza o mesmo prompt pretendido e os mesmos ficheiros de origem. Se uma definição não estiver disponível num modelo, essa diferença deve ser documentada, e não tratada como uma condição de teste idêntica.
Verificamos se os sujeitos, as ações, a ordem das cenas e os finais pedidos aparecem na saída. A ausência de eventos-chave conta como limitação mesmo quando o vídeo parece polido.
Nos casos guiados por imagem, comparamos personagens, produtos, roupas, adereços e locais com o material de origem. Uma reprodução mais precisa não equivale necessariamente a um estilo mais apelativo.
Inspecionamos percursos de câmara, movimento do corpo, interações com objetos e a relação entre planos sucessivos.
Procuramos deriva de identidade, reinícios abruptos e relações espaciais inconsistentes.
Nos casos guiados por áudio, verificamos as palavras faladas, a quem são atribuídas, a sincronização labial, os sinais sonoros e o alinhamento com a batida quando os ficheiros de origem relevantes estão disponíveis.
Uma comparação fiável de desempenho exige registos de submissão de cada tentativa, incluindo gerações falhadas, novas tentativas e rejeições de moderação.
O nosso benchmark planeado utiliza três gerações por modelo em tarefas mais simples e cinco gerações por modelo em tarefas mais complexas, num total de 74 tentativas de geração entre os dois modelos.
Cada vídeo concluído é avaliado de forma independente com uma rubrica de pontuação definida previamente.
Para evitar ficar apenas com os resultados visualmente mais apelativos, a saída representativa do benchmark é selecionada pela proximidade à pontuação mediana de qualidade em avaliação cega desse modelo e desse cenário.
Modelos diferentes podem interpretar instruções idênticas de formas diferentes.
Uma saída pode destacar-se na composição enquanto outra preserva uma personagem ou uma ação com maior proximidade. O melhor modelo para um projeto é aquele que cumpre o padrão de qualidade exigido a um custo aceitável.
Compare as mesmas definições de saída, não apenas a tarifa anunciada mais baixa.
Os dois modelos utilizam créditos do Topview, mas o custo real depende da variante do modelo, do fluxo de trabalho, da duração, da resolução e do plano da conta.
A cotação de créditos do gerador antes da submissão é o valor mais relevante para o seu projeto.
| Resolução | Seedance 2.5 no Topview | Wan 3.0 no Topview |
|---|---|---|
| 480p | 0.70 créditos/s | 0.30 créditos/s |
| 720p | 1.50 créditos/s | 0.50 créditos/s |
| 1080p | 3.70 créditos/s | 1.00 créditos/s |
Se uma saída precisar de várias tentativas antes de ser utilizável, o custo real de produção inclui essas tentativas.
Compare o total de créditos consumidos, a qualidade da saída e o número de resultados aceitáveis, não apenas o preço por segundo anunciado.
Seedance 2.5 · Wan 3.0
Um melhor vídeo AI começa com o modelo certo para o trabalho.
Escolha o Seedance 2.5 para direção com muitas referências e controlo criativo pormenorizado, ou explore o Wan 3.0 quando o seu brief couber nas entradas disponíveis e quiser comparar custos de geração.
Mantenha o mesmo prompt e as mesmas referências, reveja as saídas e escolha para si com base no resultado, não apenas no nome do modelo.
As cenas de ação complexa exigem muito da geração de vídeo AI. O modelo tem de manter personagens consistentes, compreender a escala relativa, preservar relações espaciais e coordenar várias ações ao longo do tempo. Este teste examina se sequências de combate visualmente ambiciosas permanecem compreensíveis.
O Wan 3.0 corresponde melhor às folhas de referência neste combate. A abertura mantém legíveis os dois rabos-de-cavalo brancos, o boné com orelhas de gato, o casaco amarelo e o canhão face ao mecha azul-marinho, à crista rosa, à viseira amarela e ao núcleo rosa do peito, e um fotograma posterior mostra mísseis no ar antes de ela regressar à armadura. O Seedance 2.5 ganha a leitura de escala no plano do punho, em que ela é minúscula contra a mão, mas desce ao nível da rua e o rosto e a arma tornam-se difíceis de verificar quando a câmara abre. O Seedance termina numa explosão rosa com quem dispara fora do enquadramento; o Wan termina com ela pequena contra a viseira. Escolha o Wan 3.0 quando as folhas de personagem e o momento dos mísseis tiverem de permanecer reconhecíveis. Escolha o Seedance 2.5 quando o contraste entre o gigante e o minúsculo importar mais do que uma correspondência limpa com a referência.
A geração com várias referências exige que o modelo compreenda como entradas visuais separadas se relacionam. Para além de reproduzir objetos isolados, tem de preservar a identidade, combinar elementos de desenho e manter um mundo criativo consistente entre cenas que mudam.
Este teste ajuda a avaliar com que fiabilidade cada modelo converte várias imagens de referência num vídeo mais longo e estruturado.
O Seedance 2.5 é o resultado multirreferência mais forte. O grande plano conserva o bob rosa da Sugar Pop, os olhos azuis e os adereços de guloseima no cabelo; a meio do clip, marcos de guloseima surgem separados; e o robô em plano aberto corresponde à folha do mecha, com o canhão às riscas no ombro, o escudo de antebraço em forma de donut e os membros de guloseima num só corpo. O final é um feixe colorido com esse robô ainda no enquadramento. O Wan 3.0 abre com o Candy Kingdom mais legível — roda gigante, vulcão e ruas de guloseimas — e é o clip que mostra o monstro de sobremesa sobre a cidade. Os fotogramas seguintes ficam num comboio de guloseimas e num rosto de robô desfocado, pelo que o mecha montado nunca encaixa como a folha de desenho especifica. Escolha o Seedance 2.5 quando a personagem, a combinação e o mecha concluído tiverem de sobreviver num único vídeo. Escolha o Wan 3.0 quando o reino e o monstro tiverem de se ler primeiro.
A geração de vídeo documental depende de comunicação precisa, não apenas de imagem cinematográfica. A narração, o tempo das cenas, a narrativa visual e a continuidade ambiental têm de funcionar em conjunto para comunicar uma sequência completa.
Este teste examina como cada modelo coordena a narração falada com eventos visuais complexos ao longo de 30 segundos.
O Wan 3.0 leva a história em imagem mais longe. Os fotogramas passam de um vale fluvial dourado a uma debandada frontal sob uma muralha de poeira, uma erupção, um animal caído na cinza e uma Terra cinzenta em órbita. O Seedance 2.5 também sai do vale soalheiro para uma manada em corrida, uma inundação com um estegossauro pequeno e um saurópode cinzento, mas continua no vale tranquilo já bem avançado o clip, e o último fotograma amostrado é um cinzento sem traços, não uma órbita. A inundação, e o animal pequeno contra a paisagem, leem-se com mais clareza no Seedance. Estes fotogramas não confirmam o texto falado, o ritmo nem as pausas. Escolha o Wan 3.0 quando o vídeo tiver de chegar ao colapso e ao final orbital. Escolha o Seedance 2.5 quando o vale e a inundação tiverem de permanecer naturalistas, e verifique depois se a sua própria geração chega à órbita.
A mudança de estilo exige que o modelo separe a aparência visual da identidade do sujeito e do movimento. O ambiente e o tratamento artístico podem mudar muito, mas a personagem e a ação de base têm de permanecer compreensíveis.
Este teste explora como cada modelo trata transformações coordenadas entre vários estilos visuais dentro de uma sequência criativa contínua.
O Seedance 2.5 cobre mais dos mundos pedidos. As amostras mostram a rua europeia molhada e o casaco de malha verde, um traje ciberpunk néon, um fotograma de cinema mudo a preto e branco com barras, uma viragem para pintura a óleo estrelada com um vestido azul e, de seguida, o visual original rodeado por quatro painéis separados. O Wan 3.0 dança com mais clareza na rua e nas partes ciberpunk, e o momento de animação 3D com vestido amarelo é uma cena completa, não uma imagem dentro de um painel. O mundo de cinema mudo não aparece nas amostras do Wan, e o final são quatro imagens separadas, não um cartaz com a bailarina ao centro. Escolha o Seedance 2.5 quando a lista de estilos e o final de quatro mundos forem o objetivo do brief. Escolha o Wan 3.0 quando a coreografia legível e o mundo de desenho animado importarem mais do que o segmento de cinema mudo.
As cenas de diálogo juntam várias tarefas exigentes: geração de fala, sincronização labial, consistência das personagens, interpretação emocional e interação física coordenada.
Um resultado convincente depende de estes elementos funcionarem em conjunto. Este teste ajuda a avaliar a eficácia com que cada modelo trata uma narrativa conduzida por personagens.
Ambos os clips conservam os desenhos de referência: o casaco de malha azul, o colete creme, a saia salmão e o toldo da Corner Cafe. As bocas estão abertas durante a conversa, mas os fotogramas fixos não confirmam as quatro falas nem uma sincronização labial real. A porta é a diferença visível. O último fotograma do Wan 3.0 mostra-o a segurar o puxador de latão enquanto ela atravessa o vão aberto. O Seedance 2.5 conduz o par até à entrada e para o interior, sem um momento claro em que a porta fique aberta para fora. Escolha o Wan 3.0 para este brief quando a ação da entrada tiver de corresponder ao prompt. Qualquer dos modelos serve quando a prioridade é manter as duas personagens e o café consistentes; ouça as falas antes de fechar uma tomada.
A representação com várias personagens testa a capacidade do modelo para gerir várias ações independentes num ambiente partilhado.
O desafio não é apenas gerar muitas personagens ao mesmo tempo, mas preservar as identidades, coordenar as interações e manter relações lógicas de causa e efeito na cena.
O Seedance 2.5 mantém o interior bloqueado. A mesma vista do para-brisas conserva o shiba ao volante com a boca aberta, o gato com chapéu de melancia e o pato. O pescoço do pato avança, mas a troca de chapéus, a apanha da uva e o polegar final para cima não são visíveis. O Wan 3.0 mostra mais desses momentos cómicos: um croissant numa cabeça, o caniche encostado ao cão branco, um gatinho rabugento no cesto e um polegar para cima do condutor. A câmara também abandona o ângulo bloqueado, a cortar da cabina completa para o banco traseiro e para o interior do cesto, e os chapéus e os lugares reorganizam-se. Escolha o Seedance 2.5 quando importarem uma câmara fixa e um elenco estável. Escolha o Wan 3.0 quando a cadeia de reações cómicas importar mais do que um único ângulo ininterrupto.
A geração de dança exige coordenação precisa entre movimento visual, identidade das personagens, posição do grupo e tempo do áudio.
Uma sequência de dança apelativa pode ainda falhar se os intérpretes perderem a sincronização ou se a formação mudar de forma incorreta. Este teste examina se cada modelo consegue coordenar vários sujeitos com uma referência musical externa.
O Wan 3.0 abre mais próximo da fotografia de referência: cinco dançarinos, o casaco varsity verde à frente e uma postura semelhante a um V contra o muro de graffiti. A meio, esse grupo desaparece e um dançarino ocupa a praça, antes de um fotograma posterior regressar com um grupo mais solto. O Seedance 2.5 mantém um grupo em cada amostra, incluindo o casaco verde, mas os fotogramas seguintes acrescentam pessoas e não mostram uma mudança limpa do V inicial para uma única linha horizontal dos mesmos cinco. As imagens fixas não confirmam que algum dos clips se mantenha na batida original ou deixe o áudio intocado. Escolha o Seedance 2.5 quando todos os dançarinos tiverem de permanecer no enquadramento. Escolha o Wan 3.0 quando o primeiro plano tiver de corresponder à referência, e veja o meio do clip antes de aceitar a mudança de formação.
A adaptação literária exige que o modelo converta uma narrativa escrita numa sequência visual clara.
O desafio não é apenas produzir imagens apelativas de livro ilustrado. O resultado deve preservar os papéis das personagens, as relações de causa e efeito e os eventos essenciais que tornam a cena original reconhecível.
Este teste ajuda a avaliar com que fidelidade cada modelo converte uma passagem literária pormenorizada num vídeo curto.
O Seedance 2.5 segue a passagem mais longe. O rato rema enquanto a toupeira se senta na popa; de seguida, o rato fica de costas com os pés no ar e depois senta-se de novo. O barco lê-se como azul uniforme, e não azul por fora e branco por dentro, e a proa a bater na margem fica implícita na queda, não é mostrada. O Wan 3.0 corresponde melhor ao barco — azul por fora, branco por dentro — e sustenta uma aguarela eduardiana mais estável enquanto remam sob os salgueiros. Os fotogramas finais inclinam o barco na direção das flores e depois regressam ao remar calmo, pelo que faltam a queda com os calcanhares no ar e a recuperação. Escolha o Seedance 2.5 quando o embate e a queda tiverem de ser legíveis. Escolha o Wan 3.0 quando o barco pintado e o rio tranquilo importarem mais do que a piada final.
"Believe me, my young friend, there is nothing—absolute nothing—half so much worth doing as simply messing about in boats. Simply messing," he went on dreamily: "messing—about—in—boats; messing—" "Look ahead, Rat!" cried the Mole suddenly. It was too late. The boat struck the bank full tilt. The dreamer, the joyous oarsman, lay on his back at the bottom of the boat, his heels in the air. "—about in boats—or with boats," the Rat went on composedly, picking himself up with a pleasant laugh." — Kenneth Grahame, The Wind in the Willows (1908), Chapter I, Project Gutenberg #27805 (Scribner 1913 ed.)
Fonte original: Kenneth Grahame, The Wind in the Willows (1908), capítulo I. Texto de domínio público disponível através do Project Gutenberg.